AI资讯新闻榜单内容搜索-模型训练

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型训练
答对了,理由却错了:港科大提出LexAgentHallu,追踪智能体的「隐性幻觉」

答对了,理由却错了:港科大提出LexAgentHallu,追踪智能体的「隐性幻觉」

答对了,理由却错了:港科大提出LexAgentHallu,追踪智能体的「隐性幻觉」

香港科技大学提出LexAgentHallu法律智能体幻觉评测基准,沿执行轨迹定位错误步骤,发现即使最终答案正确,仍有68%的轨迹存在法律内容幻觉,表现最好的配置也有89%的轨迹出现幻觉。

来自主题: AI技术研报
7527 点击    2026-09-28 09:49
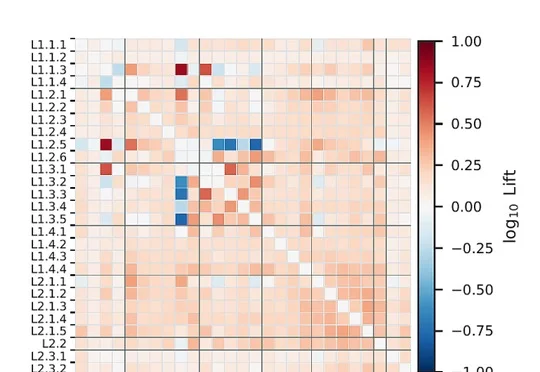
Nature Machine Intelligence|不只是「像大脑」,人脑信号还能直接引导语言模型进行鲁棒推理

Nature Machine Intelligence|不只是「像大脑」,人脑信号还能直接引导语言模型进行鲁棒推理

Nature Machine Intelligence|不只是「像大脑」,人脑信号还能直接引导语言模型进行鲁棒推理

北京大学、清华大学与微软亚洲研究院在Nature Machine Intelligence发表研究,发现语言模型内部表征与人脑演绎推理脑区存在部分对齐,并可利用脑信号引导模型表征干预与参数微调,显著提升推理鲁棒性。
来自主题: AI技术研报
7932 点击    2026-09-28 09:49
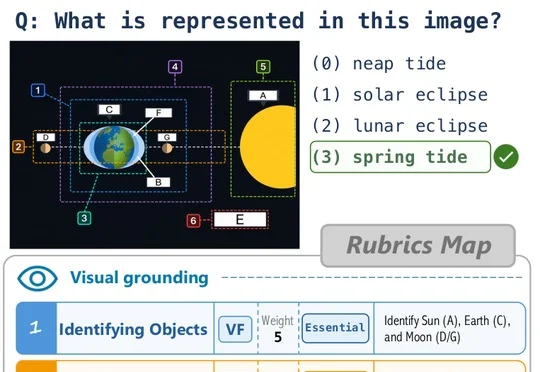
答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
来自主题: AI技术研报
7406 点击    2026-09-28 09:48
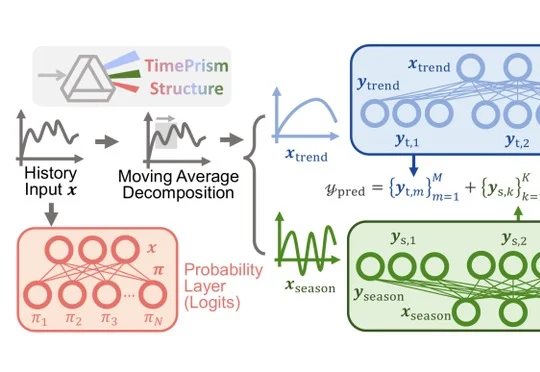
Jev刷屏之后,竟然有人12个月前就提出了概率并行生成?

Jev刷屏之后,竟然有人12个月前就提出了概率并行生成?

Jev刷屏之后,竟然有人12个月前就提出了概率并行生成?

Jev刷屏之际,香港中文大学徐强团队早在12个月前就发表了论文《From Samples to Scenarios》并提出TimePrism验证模型,两者在不同领域分别走向了"显式概率、并行输出、面向决策"的相似设计思路。
来自主题: AI技术研报
9137 点击    2026-09-26 15:00
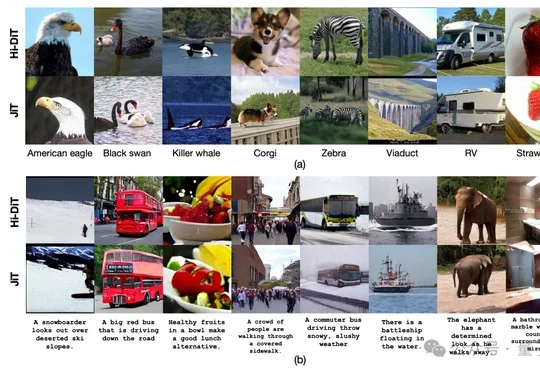
扩散模型路线之争可以停了?Latent‑Pixel混合扩散生成新范式上线 | ECCV'26

扩散模型路线之争可以停了?Latent‑Pixel混合扩散生成新范式上线 | ECCV'26

扩散模型路线之争可以停了?Latent‑Pixel混合扩散生成新范式上线 | ECCV'26

中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
来自主题: AI技术研报
9449 点击    2026-09-26 14:57
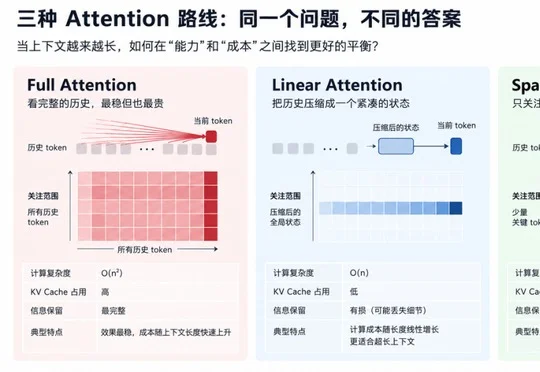
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?

GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
来自主题: AI技术研报
6794 点击    2026-09-25 10:11
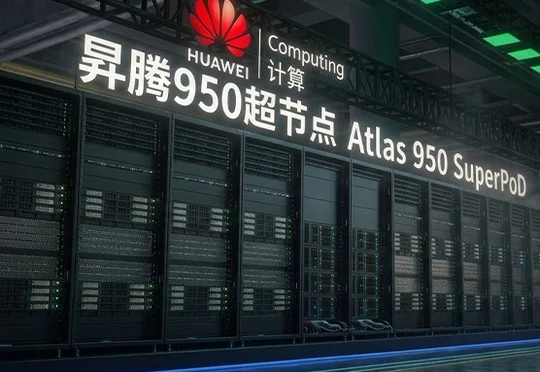
打破“算力存储通信”三堵墙,昇腾超节点给出十万亿大模型训推“最优解”

打破“算力存储通信”三堵墙,昇腾超节点给出十万亿大模型训推“最优解”

打破“算力存储通信”三堵墙,昇腾超节点给出十万亿大模型训推“最优解”

华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
来自主题: AI资讯
9334 点击    2026-09-25 10:11
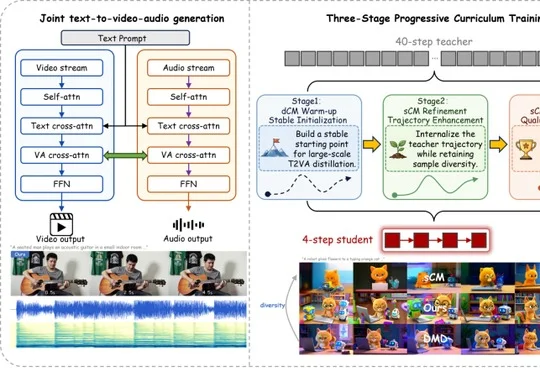
音视频生成提速54倍!TurboT2VA:分布蒸馏与轨迹蒸馏的联合蒸馏方案

音视频生成提速54倍!TurboT2VA:分布蒸馏与轨迹蒸馏的联合蒸馏方案

音视频生成提速54倍!TurboT2VA:分布蒸馏与轨迹蒸馏的联合蒸馏方案

浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
来自主题: AI技术研报
7579 点击    2026-09-25 10:09
从真机到世界模型,具身智能正在补一条看不见的数据产线

从真机到世界模型,具身智能正在补一条看不见的数据产线

从真机到世界模型,具身智能正在补一条看不见的数据产线

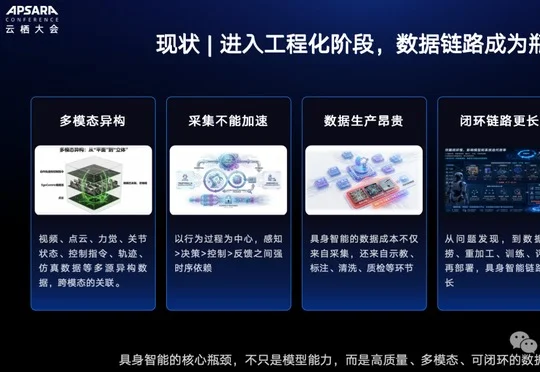
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
来自主题: AI资讯
7693 点击    2026-09-25 10:09
PCIe显卡被低估了!内核补齐+通信重构,DeepSeek推理吞吐直接翻近7倍

PCIe显卡被低估了!内核补齐+通信重构,DeepSeek推理吞吐直接翻近7倍

PCIe显卡被低估了!内核补齐+通信重构,DeepSeek推理吞吐直接翻近7倍

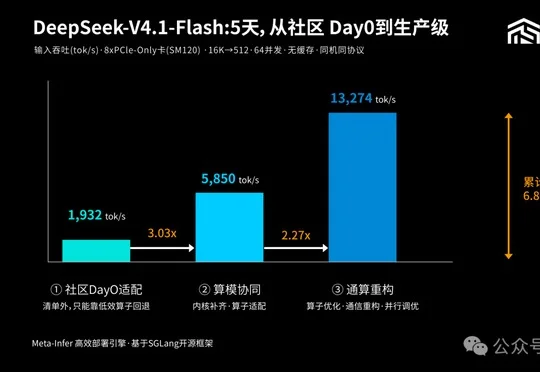
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。

来自主题: AI资讯
8047 点击    2026-09-25 10:09