图灵奖得主与月之暗面创始人联手,给AI大模型出了一套“科研能力考卷”,谁在真干活?
图灵奖得主与月之暗面创始人联手,给AI大模型出了一套“科研能力考卷”,谁在真干活?月之暗面(Moonshot AI)创始人杨植麟联合清华大学及图灵奖得主姚期智团队推出TCSExam,以机器核验的科研交付物评测大模型,GPT‑6 Astra居Full榜首,开放猜想有效解答仍依赖联网检索改编。
来自主题: AI技术研报
8645 点击 2026-11-13 17:09

 搜索
月之暗面(Moonshot AI)创始人杨植麟联合清华大学及图灵奖得主姚期智团队推出TCSExam,以机器核验的科研交付物评测大模型,GPT‑6 Astra居Full榜首,开放猜想有效解答仍依赖联网检索改编。
上海交通大学赵海教授团队在arXiv发布BriLLM-MetaPred,首次将AGI数学理论推导的MetaPred原语落地为可运行语言模型,其在约13.2M参数规模下的预测性能与同规模GPT基线相当。
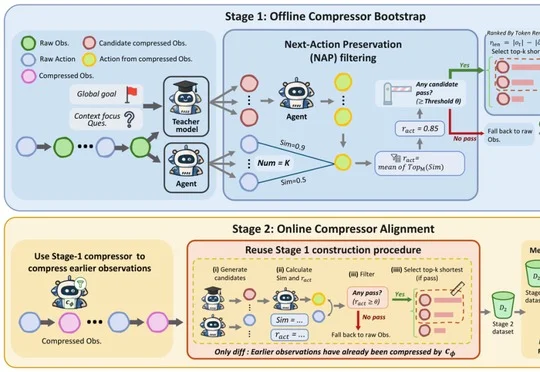
清华大学人工智能学院提出面向 Coding Agent 的 observation 压缩方法 CoACT,在 SWE-bench Verified 的三个 Agent 模型上平均减少 33.0% 总 token 消耗且 PASS@1 与未压缩时相近,该工作获 ICSE 2027 直接接收(Top 5%)。
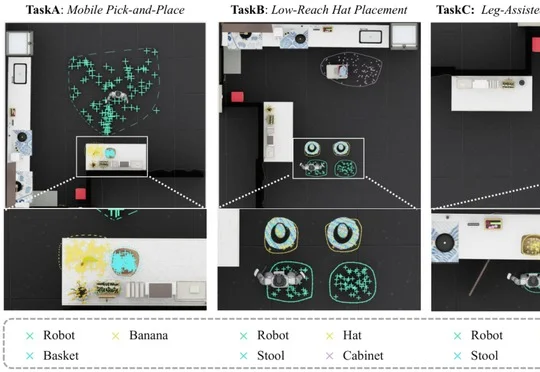
Real2Sim2Real 为此提供了一条路径:将真实场景重建为仿真环境,在其中生成示范、训练策略,再将技能迁移回真实机器人。但要让这条路径支撑人形机器人的全身操作,仍需跨过两道门槛。
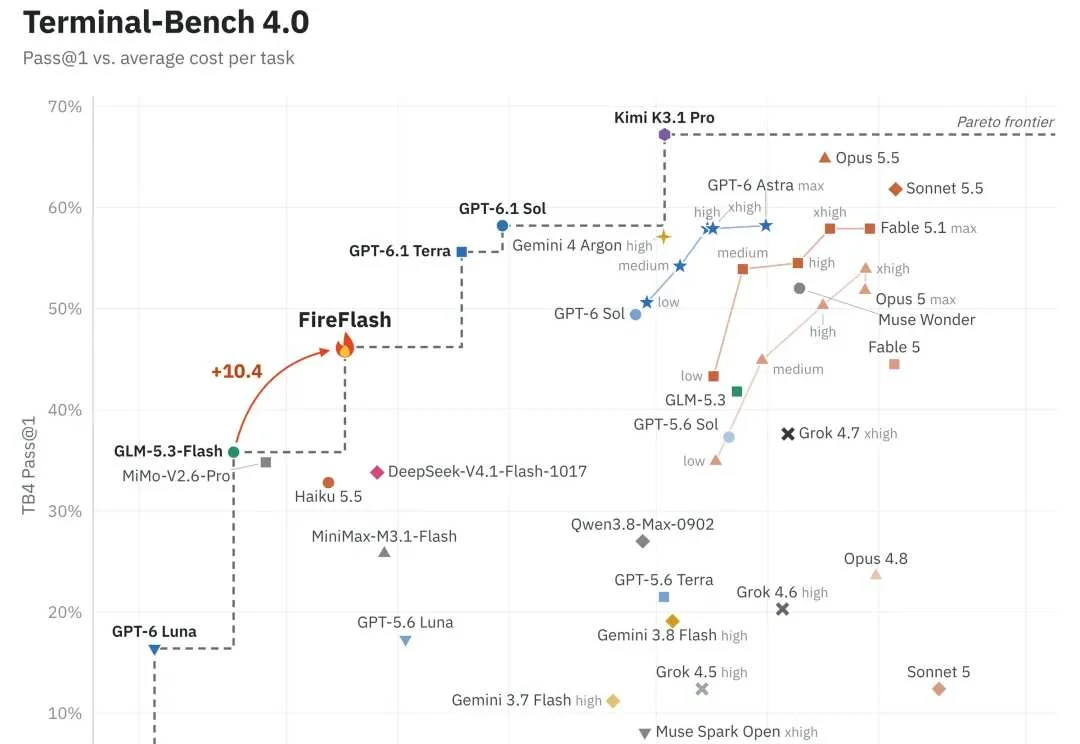
长程智能体(long-horizon agents)正从「修一个 bug」走向连续数小时的终端与编程工作,但它的强化学习训练也格外昂贵:前沿实验室可以在数千张 GPU 上扩展 RL,而对多数团队来说,一条训练样本往往就是一次长达 3 小时、上百轮工具调用的完整尝试,任何一个环节出错,浪费的都是成小时的 GPU 时间。
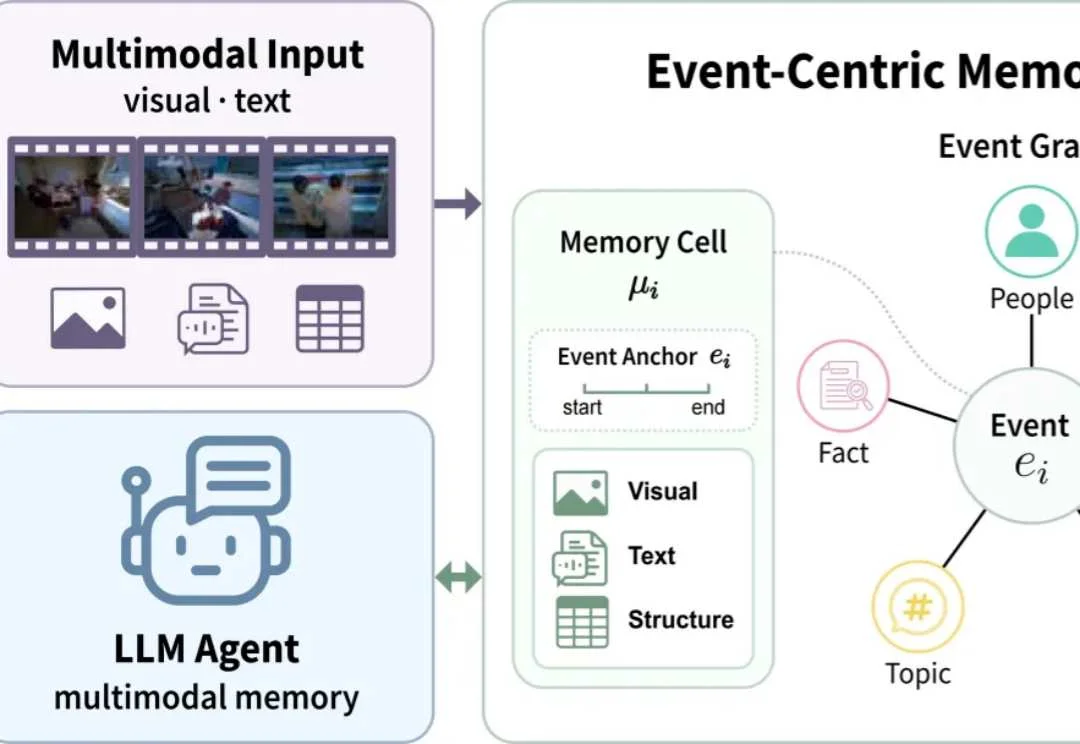
「刚才是谁说,打算种花?」
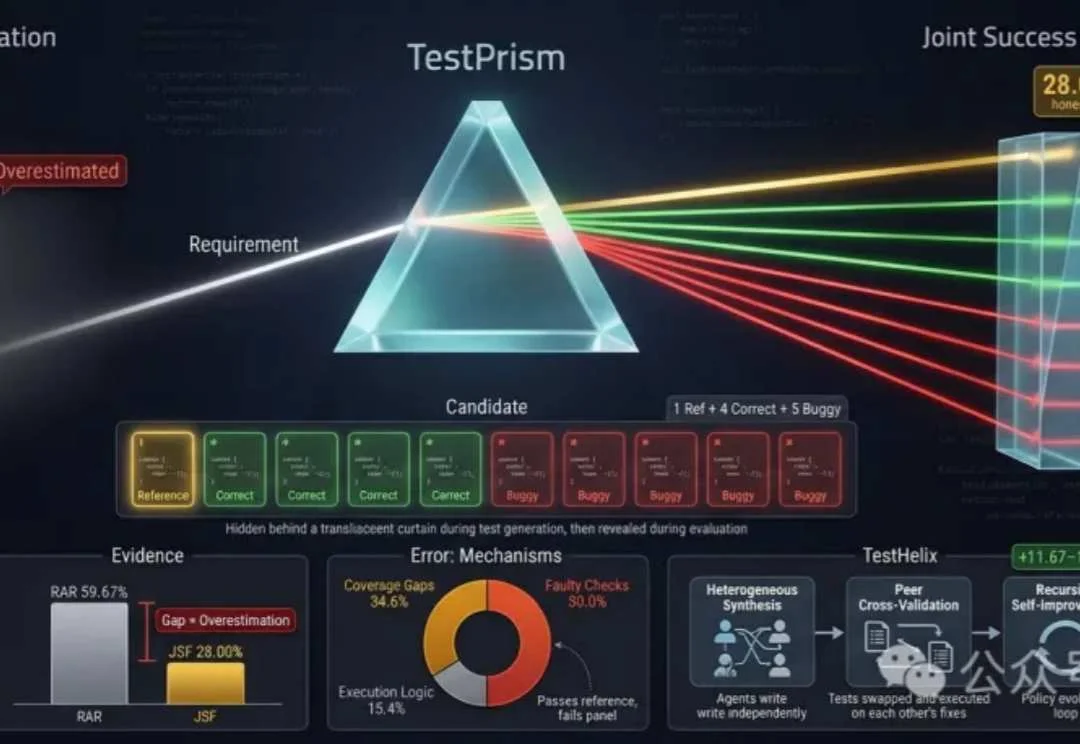
Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
在机器人操作研究中,视觉语言动作模型(Vision-Language-Action,VLA)与世界动作模型(World Action Model,WAM)为机器人提供了不同的动作生成路径。但当任务从一次抓放延伸到连续搭建与双臂协同,决定成败的就不只是眼前这个动作能否完成,还包括此前建立的条件能否一直支撑后续执行。
设想一个客服系统,每秒涌进成百上千条用户请求。
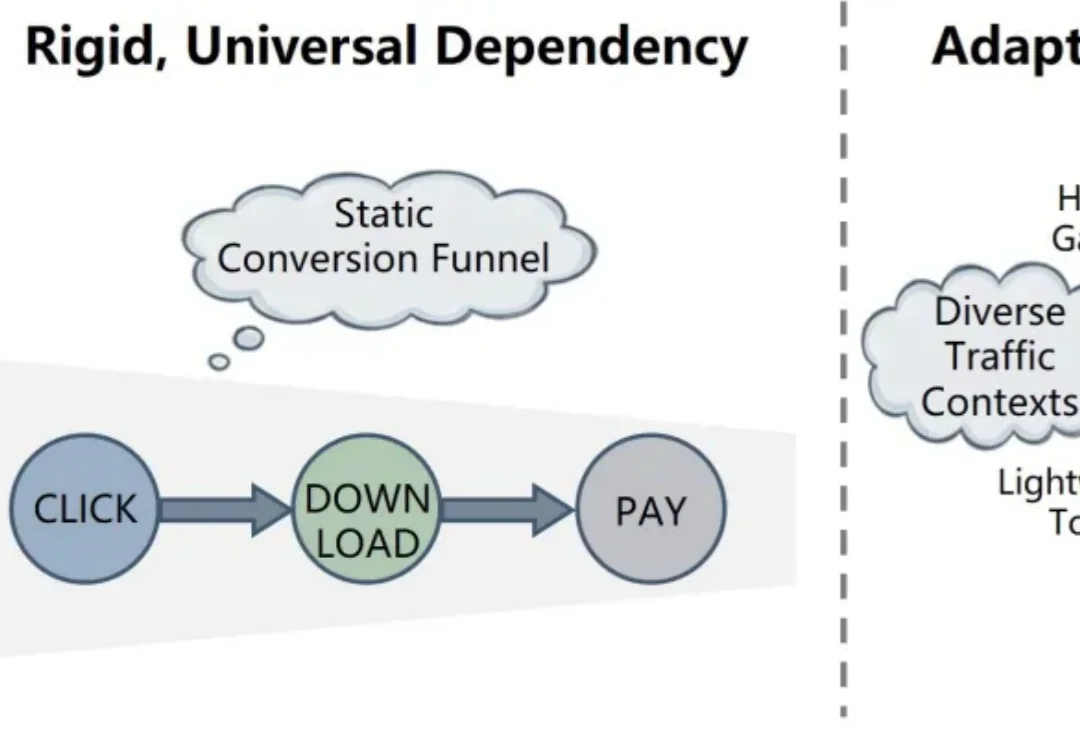
工业推荐的优化重心,已经从单一交互指标转向整体eCPM(每千次曝光收益)。