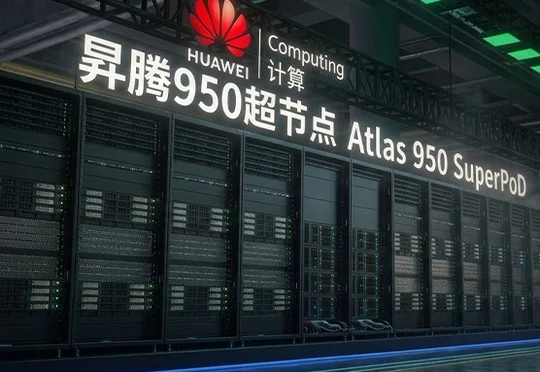
打破“算力存储通信”三堵墙,昇腾超节点给出十万亿大模型训推“最优解”
打破“算力存储通信”三堵墙,昇腾超节点给出十万亿大模型训推“最优解”华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
来自主题: AI资讯
9337 点击 2026-09-25 10:11

 搜索
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
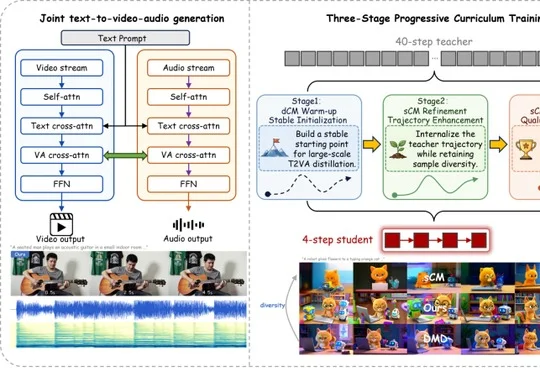
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
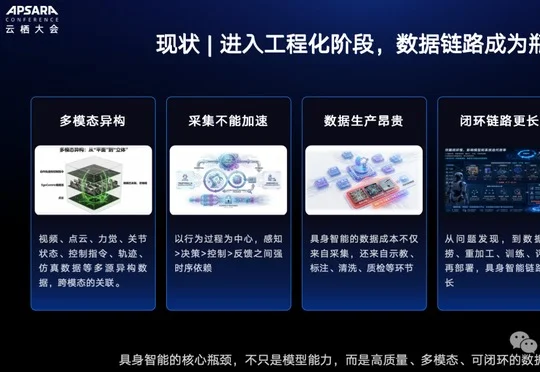
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
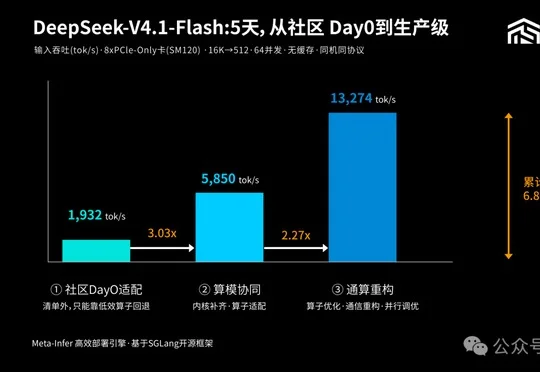
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
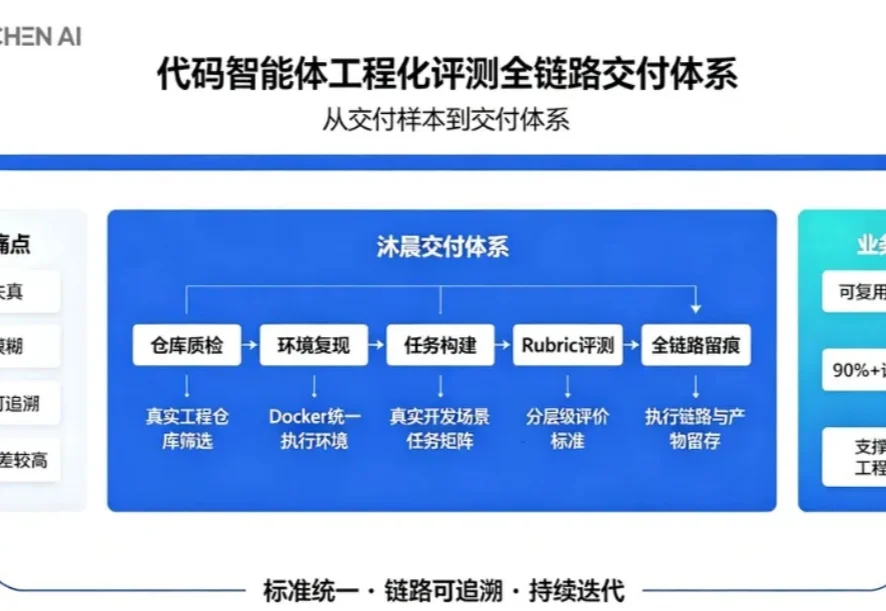
近期 2026 外滩大会上,北大助理教授杨灵关于「长程任务学习」的分享引发行业关注 —— 当 AI 从单次问答走向长周期复杂任务,模型如何从持续交互中积累进化。而在这份分享的合作研究标识中,Muchen AI 的名字赫然在列。
AI 正从看懂画面,走向理解空间、预测变化、执行动作。
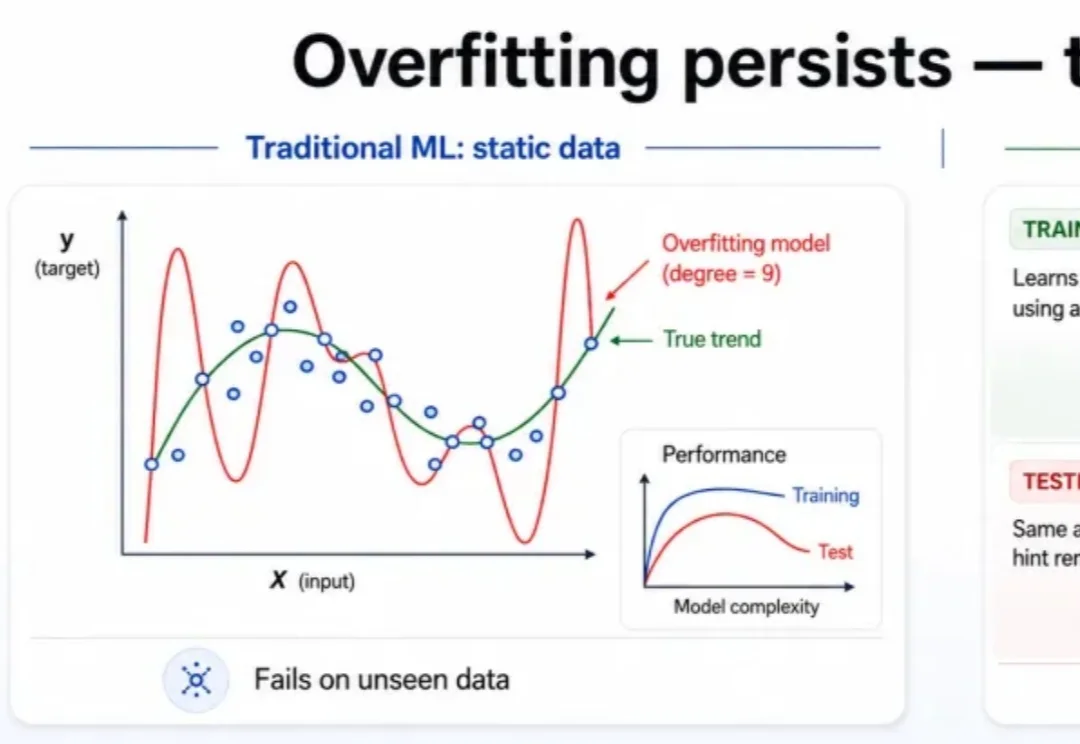
近日,IQuest Research 同北京航空航天大学、曼彻斯特大学等合作伙伴发布 ModularRSI,尝试让 Agent 根据自身执行经验,持续修改模型外围的运行机制——Harness。
大模型训练拼的是算力,Agent训练拼的是环境。
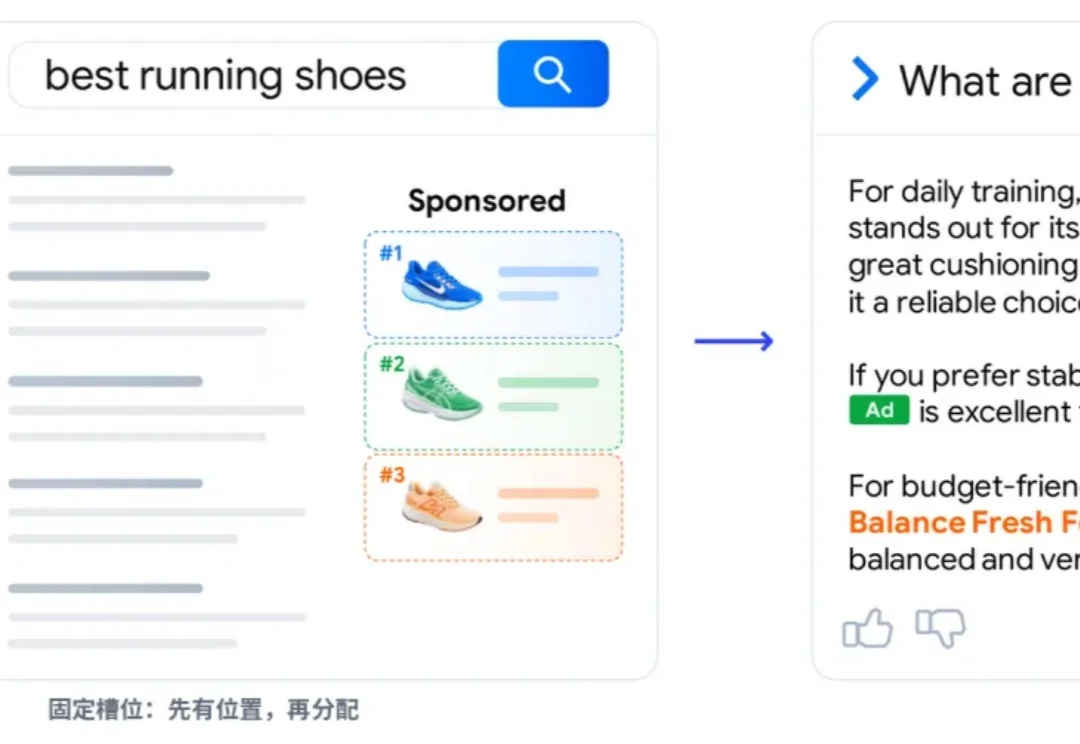
搜索结果里但凡出现 AI 摘要,用户点开普通网页的几率就几乎腰斩。Pew Research Center 对美国用户在 Google 上大规模浏览行为的分析发现:有 AI 摘要时,用户点击传统搜索结果的比例从 15%直接暴跌至 8%。