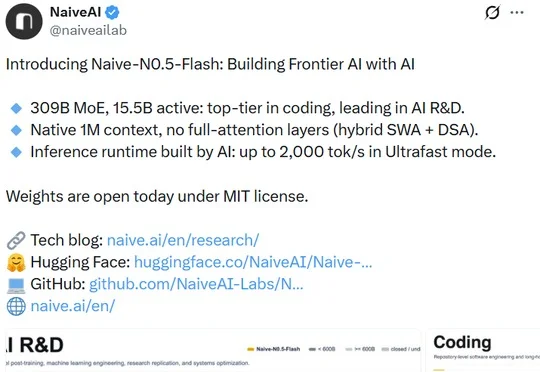
用AI造的!刚刚,代季峰团队首个模型开源Naive-N0.5-Flash
用AI造的!刚刚,代季峰团队首个模型开源Naive-N0.5-Flash代季峰创立的Naive AI开源首个模型Naive-N0.5-Flash,总参数量309B、激活参数量15.5B,原生支持百万token上下文,面向编程与AI研发任务,由AI参与研发并在论文复现等评测中表现优异,权重与代码采用MIT许可开源。
来自主题: AI资讯
9410 点击 2026-09-29 11:53

 搜索
代季峰创立的Naive AI开源首个模型Naive-N0.5-Flash,总参数量309B、激活参数量15.5B,原生支持百万token上下文,面向编程与AI研发任务,由AI参与研发并在论文复现等评测中表现优异,权重与代码采用MIT许可开源。
可灵AI发布时隔8个月大版本更新的旗舰视频生成模型Kling 4.0及轻量版Kling 4.0 Flash,单次原生生成时长提升至30秒,最多支持10个关键帧输入,新增双通道立体声输出,并将很快推出4K 10-bit HDR格式。
欧洲开发者 Mario Zechner 开发的极简 Coding Agent Harness Pi 只给模型一个 bash,却在多项 Benchmark 中击败 Claude Code 和 Codex,凭借极简设计和高可扩展性在 2025 年底爆火,团队来自维也纳而非硅谷。
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
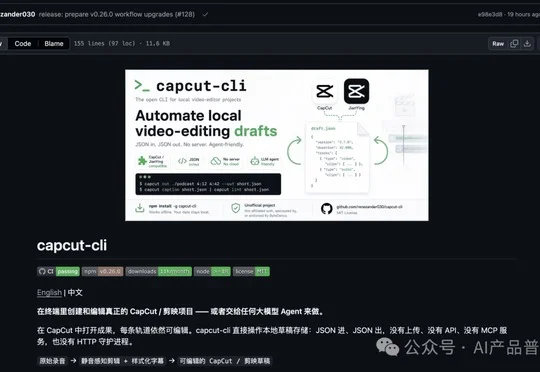
作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
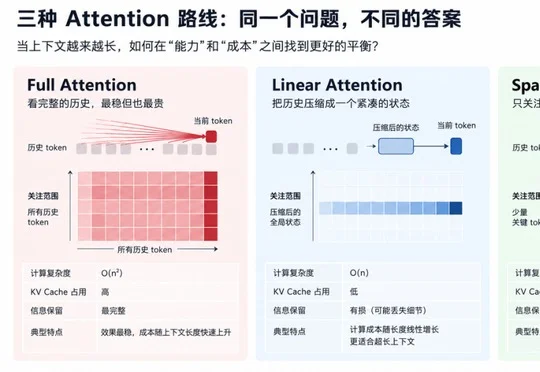
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
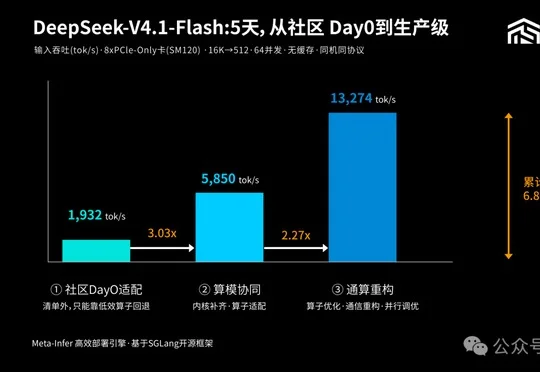
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
价格卷过DeepSeek Flash。
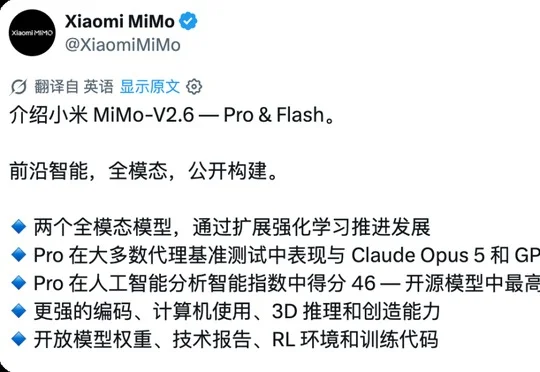
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。