刚刚,百度开源全新预训练基模,还是主打效率的Flash
刚刚,百度开源全新预训练基模,还是主打效率的Flash百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
来自主题: AI资讯
9644 点击 2026-11-05 18:02

 搜索
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
掏的是顶配旗舰的钱,调的是转售路由的API,后台真正干活的,却可能是个缩水的小模型。
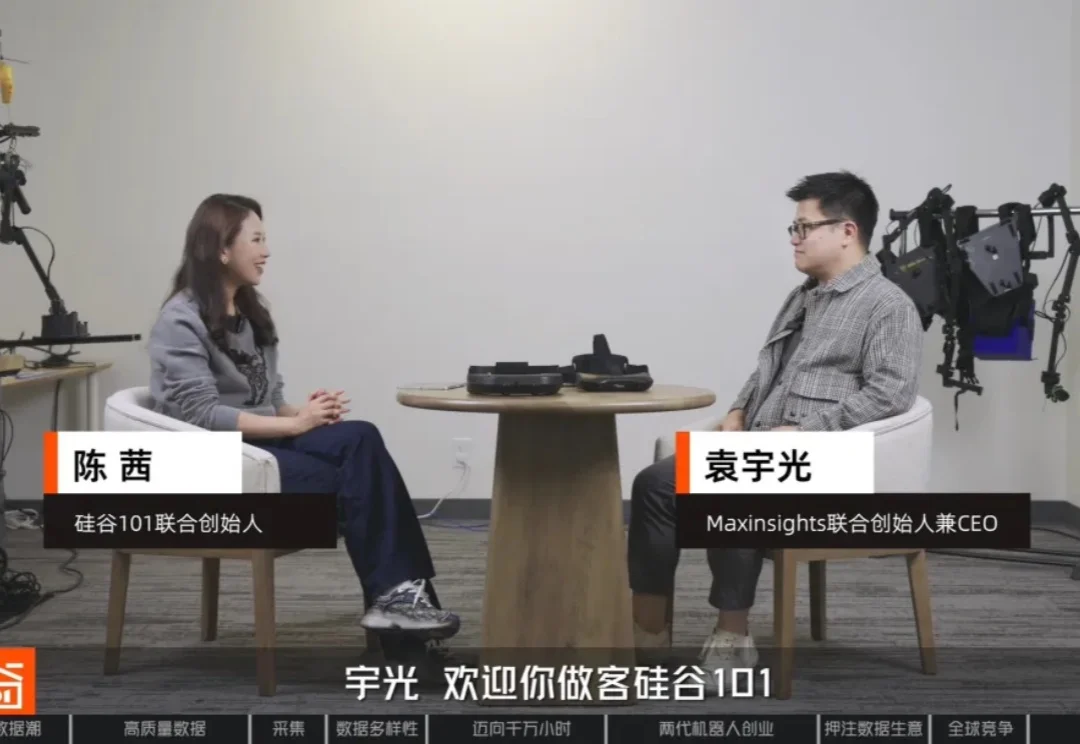
过去两年,在采访机器人公司时,我们听到最多的一句话就是:太缺数据了。
Anthropic 开源了基于零知识密码学的 FlashProve,使用户无需获取模型权重即可验证回答确由指定模型生成;该系统已在 4000 亿参数的 Llama 4 Maverick 上达到约 110 Token/s,但仍是受成本和上下文限制的研究原型。
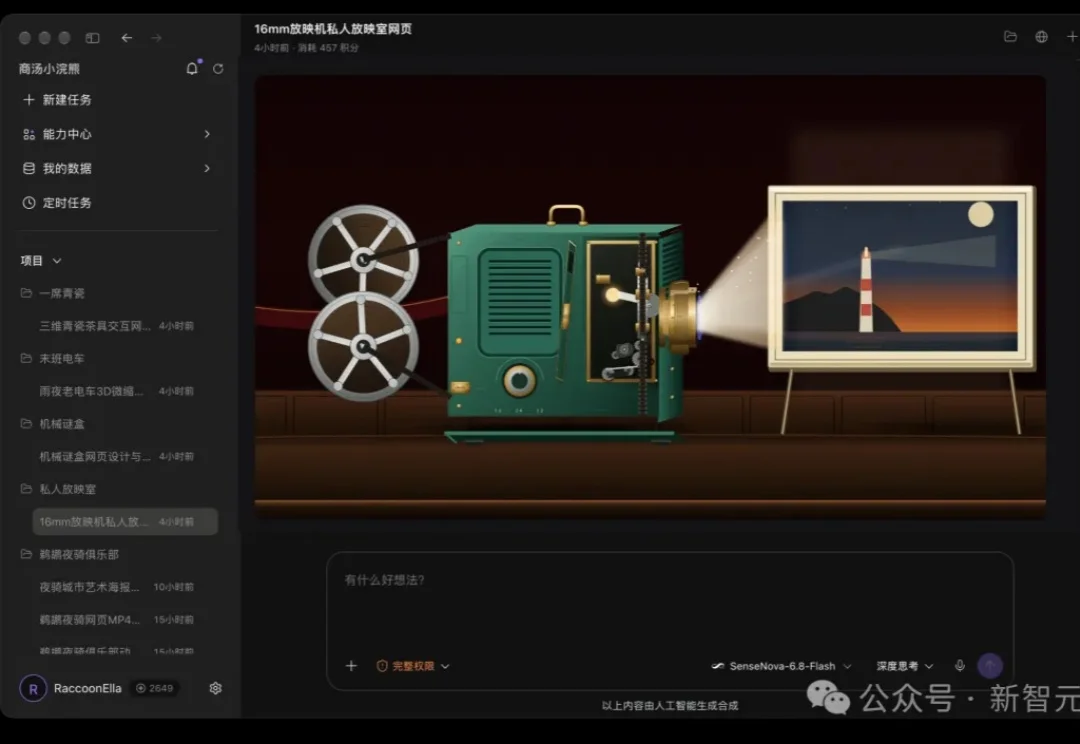
商汤发布多模态智能体模型SenseNova 6.8 Flash,实测其用8分21秒读完582页招股书并生成可交互看板,制作8页PPT却耗时64分钟,同时支持动态海报、Agentic 3D设计与Figma工作流。
最近,大模型圈的风向,彻底变了。
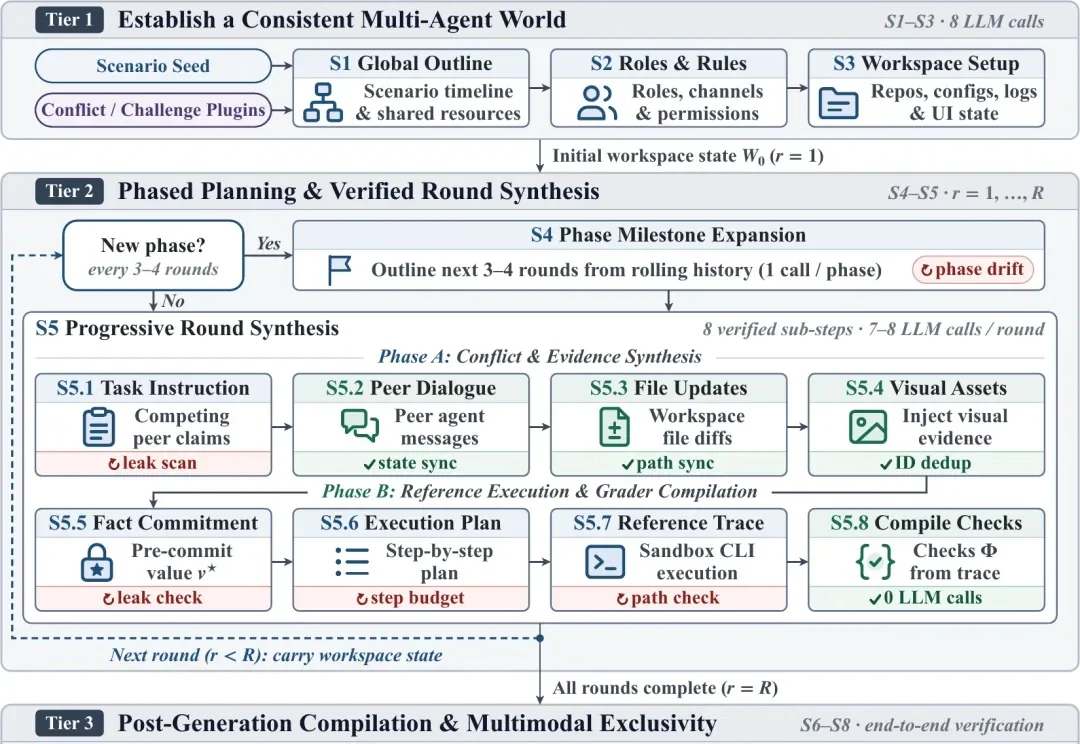
当大模型从“单兵作战”走向“多 Agent 协同操作电脑(Computer Use)”,如果队友 Agent 读了旧缓存报假消息、下发了互相矛盾的指令,甚至锁死了共享文件,主控 Agent 该听谁的?
面壁智能的ForgeKernel在仅有数学定义和B200硬件约束时,经22.5小时和42轮迭代生成FlashMLA Prefill算子,耗时472微秒,较DeepSeek-V4.1版本快9.8%,随后由智能进化实验室联合OpenBMB社区开源。
5600亿总参数,主攻个人智能体与复杂工作流。
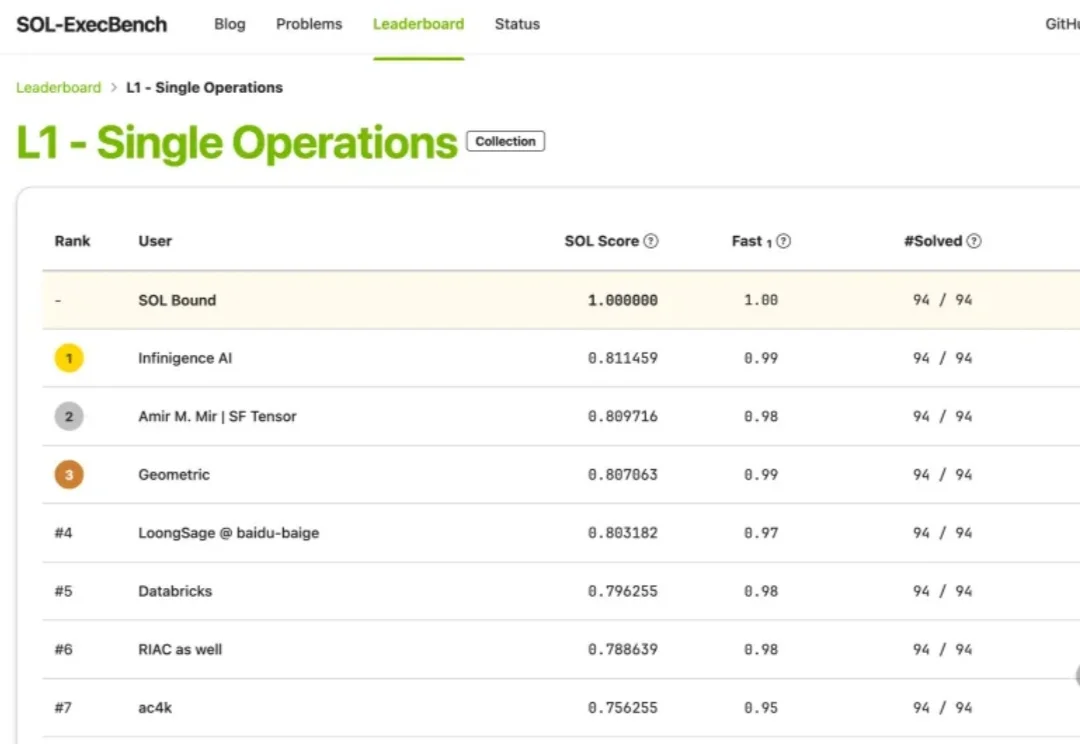
近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩: 先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。