88比12!在攻克癌症这件事上,垂类AI比国际主流通用大模型和人类医生都在行?
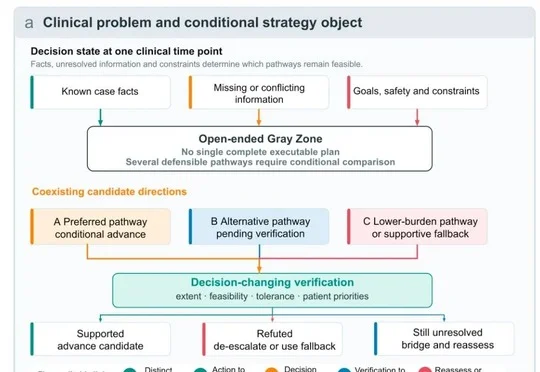
88比12!在攻克癌症这件事上,垂类AI比国际主流通用大模型和人类医生都在行?未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
搜索
未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
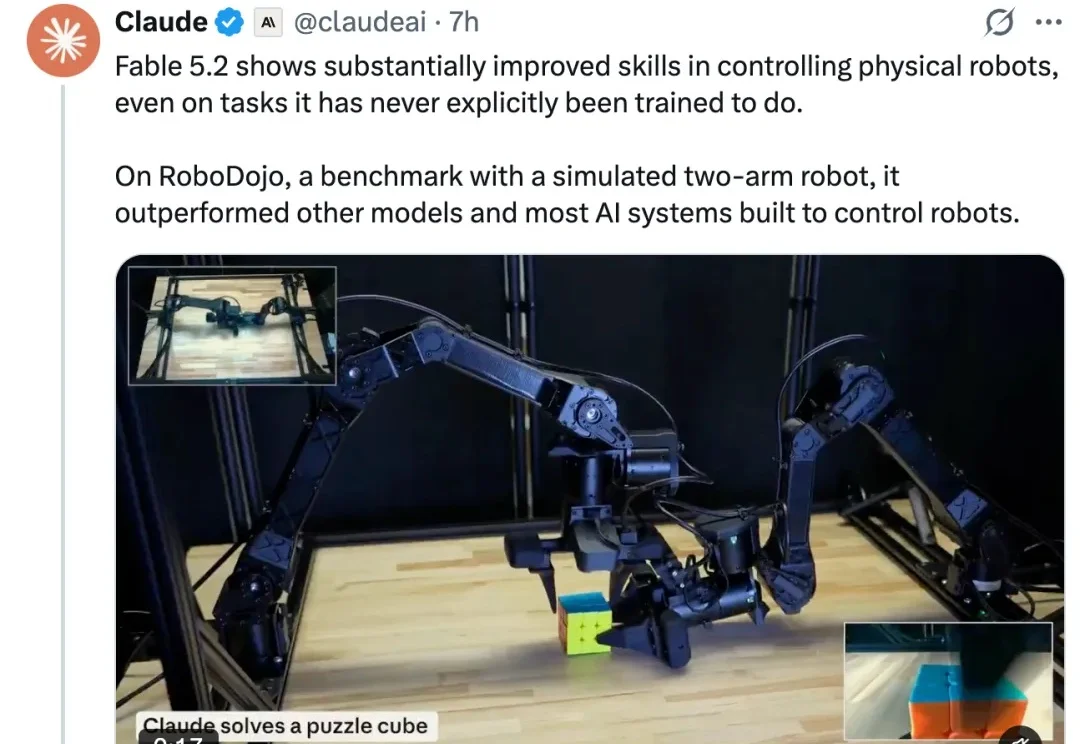
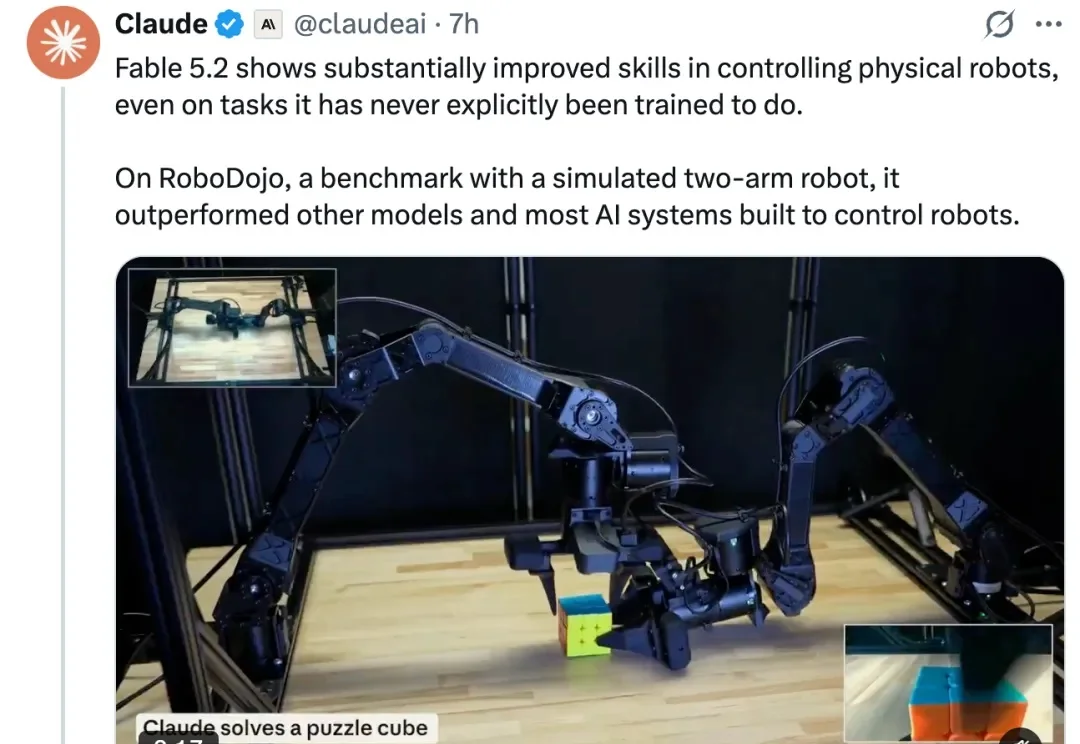
11 月 10 日,Anthropic 发布新一代模型 Fable 5.2,再次将通用大模型的物理行动能力推向新的高度。
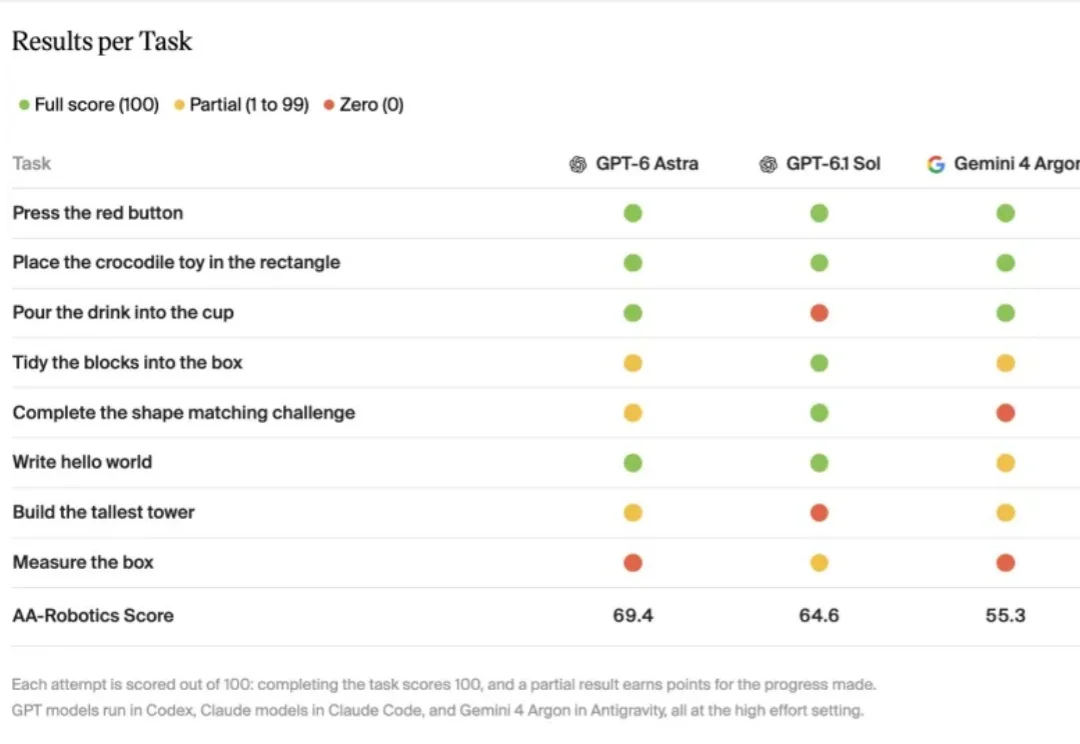
又一次,通用大模型在机器人操作领域展现出了惊人的潜力。今天,Anthropic 最新旗舰 Fable 5.2 亮相了!
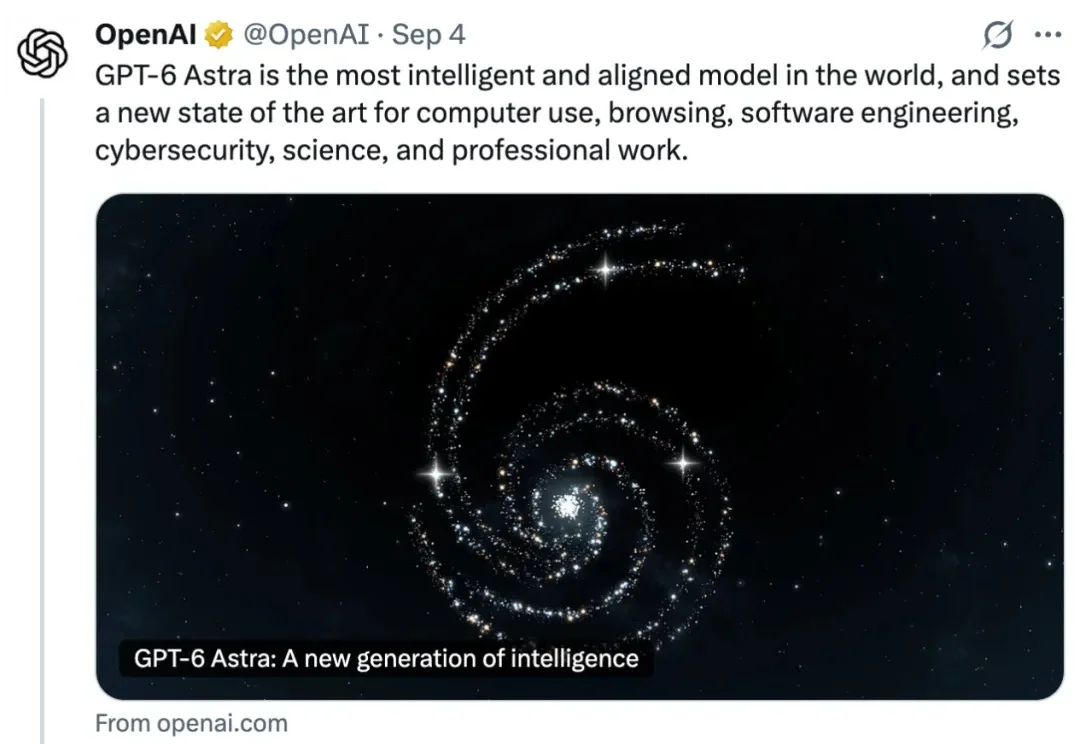
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
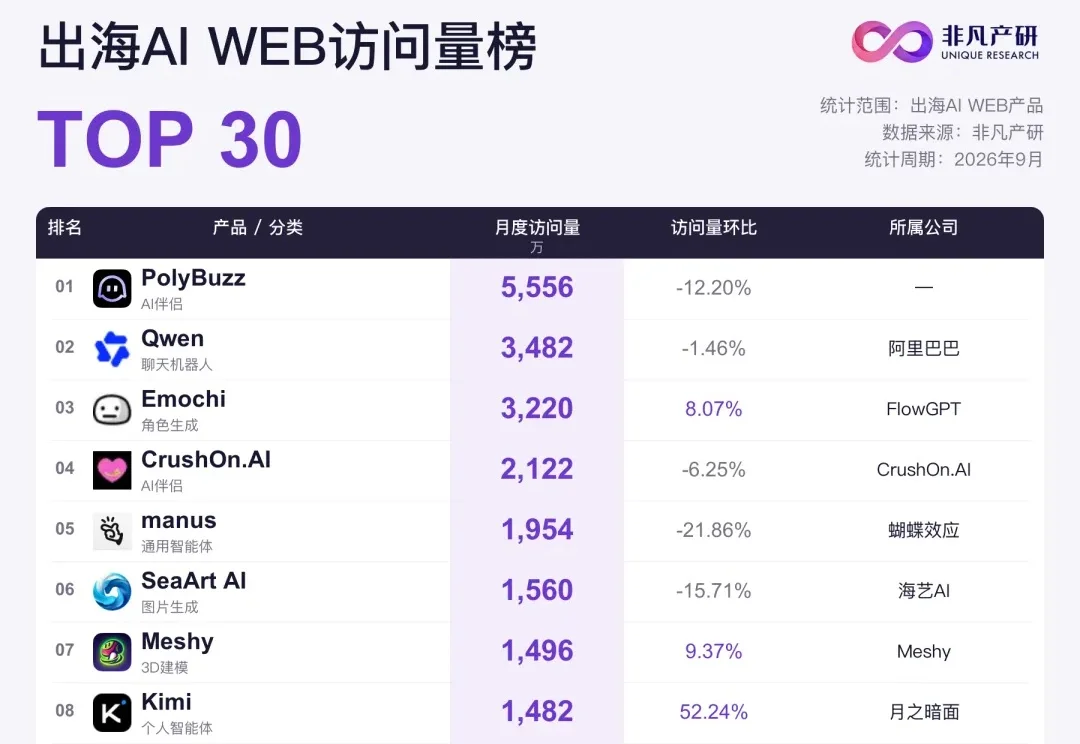
即便通用大模型的图像、视频能力越来越强,消费者依然持续为垂直创意工具付费
具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
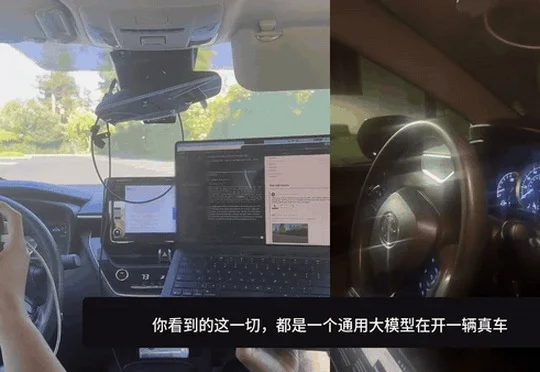
硅谷DrivingBench测试中,从未专门学过开车的通用大模型GPT-6 Astra操控改装丰田卡罗拉以5分22秒通过锥桶摆出的科目二考场,成为全场唯一通关的大模型,而Claude Fable 5.1、Grok 4.6和GPT-5.6 Sol均未通过。
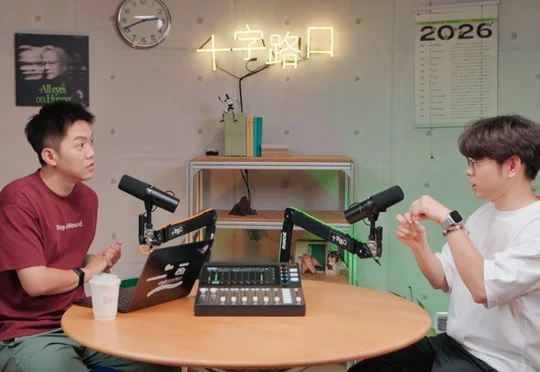
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
OpenAI发布的GPT-6 Astra在Insilico Medicine构建的DDD Benchmark抗体可开发性预测测试中以37.98分登顶第一,在不依赖外部专用工具的情况下击败所有前沿模型,标志着通用大模型正在突破抗体成药性预测这一生物医药研发的"死亡之谷",成为AlphaFold之后最具震撼性的科学范式转移。
当所有人都在盯着通用大模型时,Voice AI 这条相对安静的赛道里,也开始出现一些值得注意的新模型。最近,一家名为 Hojo 的创业团队公开披露了一组语音识别测试结果,似乎有成为「黑马」的趋势。