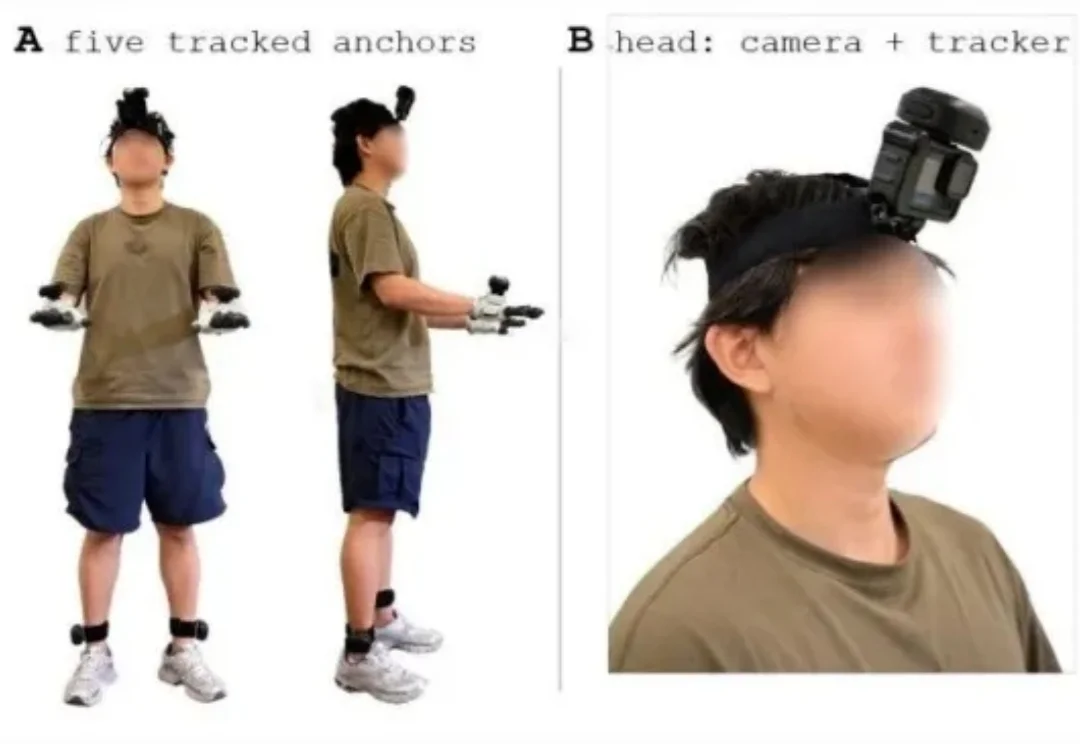
5个追踪器替掉动捕棚:上海AI Lab把具身数据采集做成了可穿戴管线
5个追踪器替掉动捕棚:上海AI Lab把具身数据采集做成了可穿戴管线家庭、实验室与工厂里的许多真实任务,都需要一边行走一边操作。
来自主题: AI技术研报
10086 点击 2026-11-19 08:37

 搜索
家庭、实验室与工厂里的许多真实任务,都需要一边行走一边操作。
市面上讨论 AI 数据生意的声音很多,但大多是从数商或投资人的视角讲故事。本文作者 Jinyan Su 是 Cornell 计算机科学 PhD,一位 post-training 方向的一线 researcher。今年找工作时,她也被各路数据 startup 创始人和猎头密集找上门。
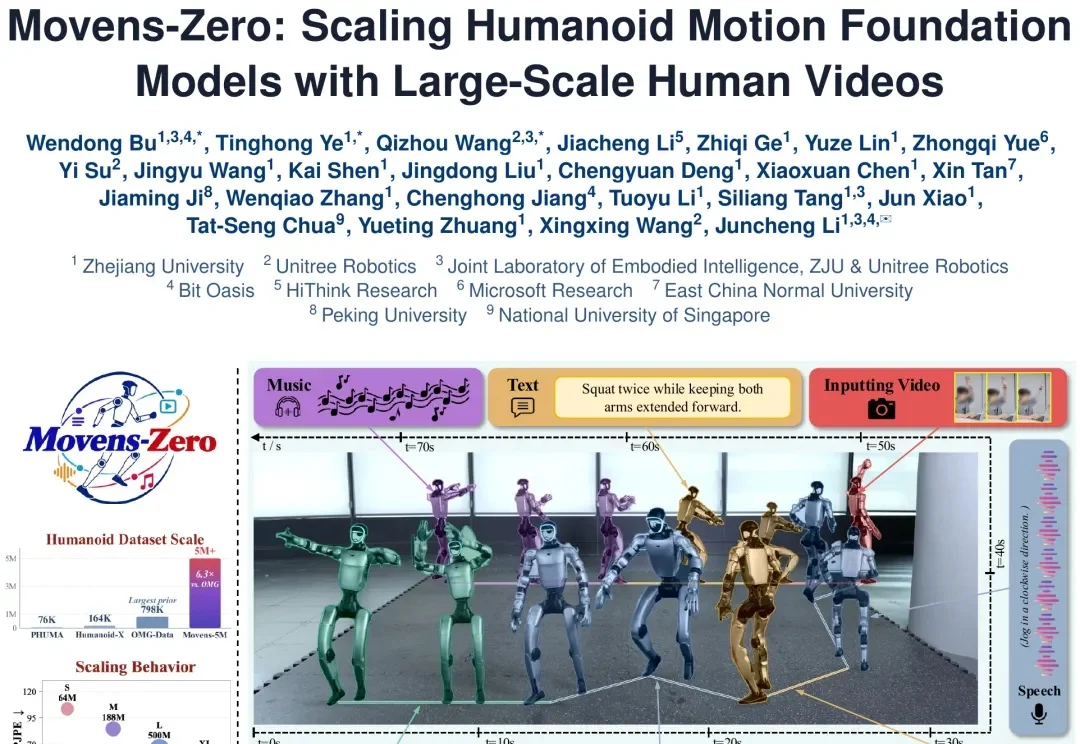
浙江大学与宇树科技具身智能联合实验室等团队从海量互联网人类视频中构建并开源了预训练数据集 Movens-5M,收录 500 万条经仿真执行验证的机器人动作,总时长超过 1 万小时。
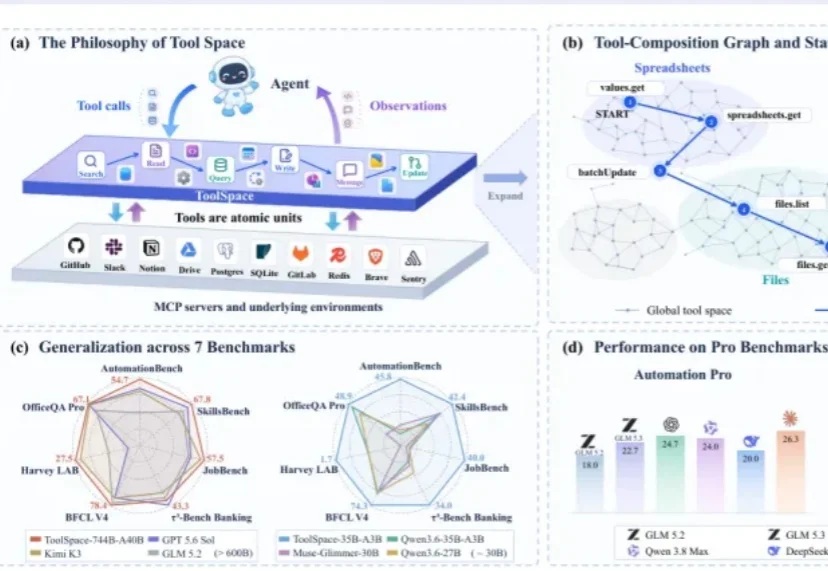
给智能体造训练环境,一定要先从数据库开始吗?现有的环境合成方法通常以数据为中心,先生成数据库和业务场景,再据此构造工具与任务。但沿着这条路线,工具接口和参数逻辑可能偏离真实定义,工具组合也可能缺少执行依据,任务往往局限于单个环境。
杭州创业公司 Pyromind 正以 EchoMind 探索企业 RSI,通过自动串联数据采集、清洗、训练、评测和模型热更新,让模型依据真实业务反馈持续改进参数。
《季载录·秋丨全球AI应用行业发展报告丨Xsignal》基于2026年第三季度数据指出,全球AI应用正从技术奇观转向场景基建,豆包、千问、ChatGPT等依托生态流量领跑,WorkBuddy、商汤小浣熊在Web生产力场景增长突出,垂类及情绪陪伴应用则在App端形成机会。
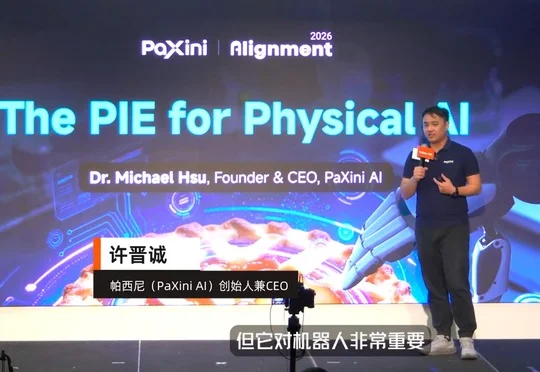
在ALIGNMENT 2026大会上,帕西尼创始人兼CEO许晋诚提出由感知、智能与执行(PIE)构成的物理AI路径,并以GEN FUSE架构、OmniSharing DB、Omni VTLA 2.0、Feelix World及DexH13灵巧手推进机器人感知、学习与执行能力。
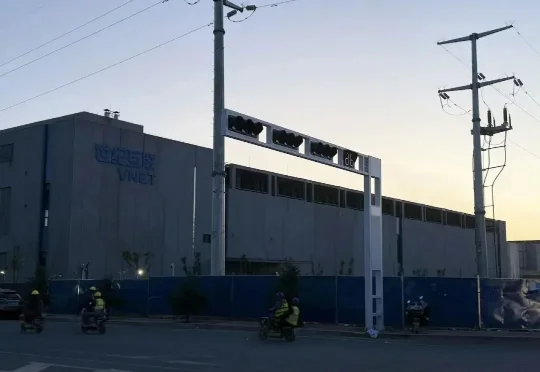
数据中心最忙的施工期通常只有三四个月。一座楼完工,几千名工人转去下一个工地,小店也得跟着走。等楼里的服务器运转起来,一位园区负责人算过,一栋楼值班和维护的人加起来不到 20 个。
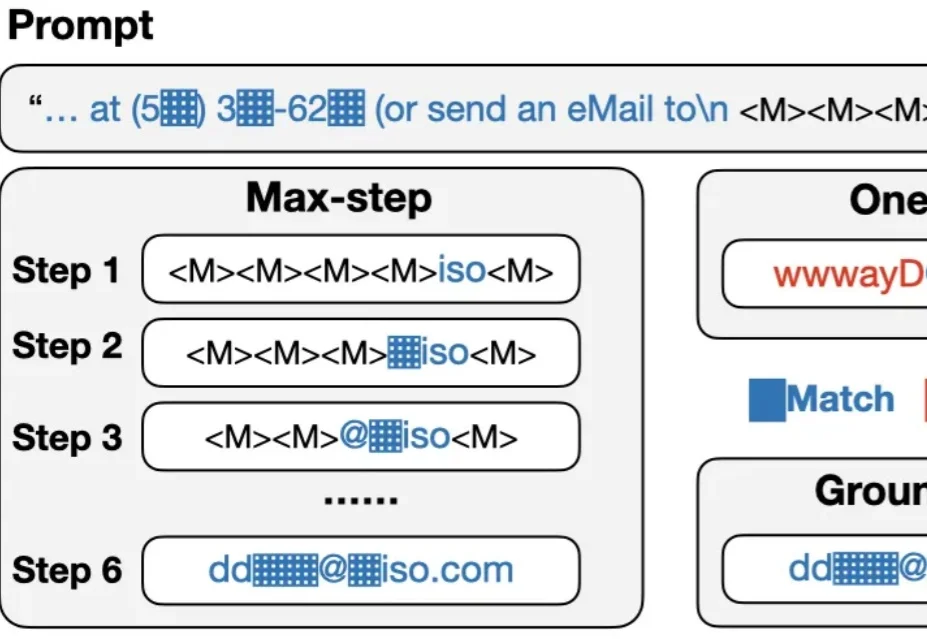
大语言模型有时会把训练时见过的内容原样「背出来」,其中可能包含邮箱、电话号码等个人信息。随着扩散语言模型走向更大规模,一个问题也随之出现:当模型不再从左到右逐词生成,它还会以同样的方式泄露训练数据吗?
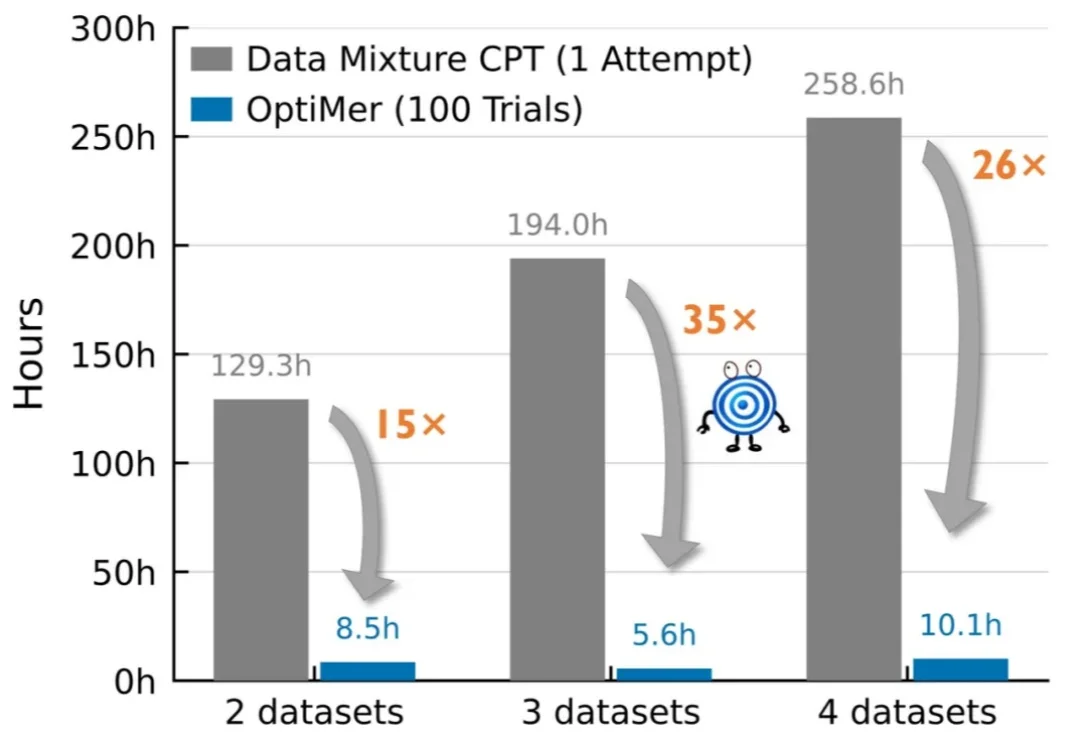
不同数据,到底各训多少?每个模型训练师都绕不开这个问题。