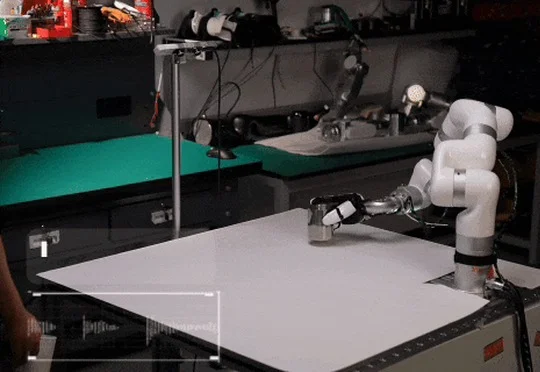
行业首款云端具身智能体Visics-Agent:懂人话、能教会、可进化,来自RoboScience机器科学
行业首款云端具身智能体Visics-Agent:懂人话、能教会、可进化,来自RoboScience机器科学RoboScience机器科学发布云端具身智能体Visics-Agent,支持语音理解、技能教学与经验积累,可通过腾讯云API适配不同末端执行器,计划于2026年12月上线。
来自主题: AI资讯
7912 点击 2026-11-13 17:09

 搜索
RoboScience机器科学发布云端具身智能体Visics-Agent,支持语音理解、技能教学与经验积累,可通过腾讯云API适配不同末端执行器,计划于2026年12月上线。
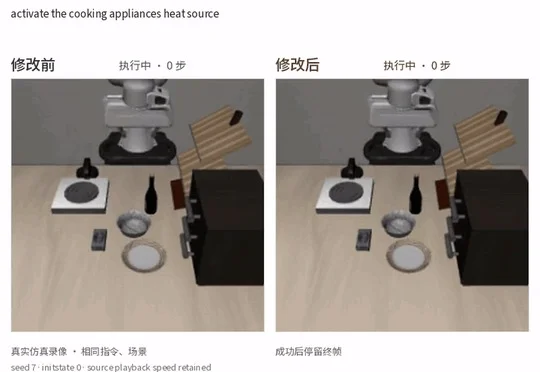
斯坦福研究团队让GPT-6 Astra直接修改π₀.₅机器人策略的65行词嵌入,将765条留出指令的整体成功率从86.3%提升至92.0%,但仍有4个回合退化且结果仅限仿真。
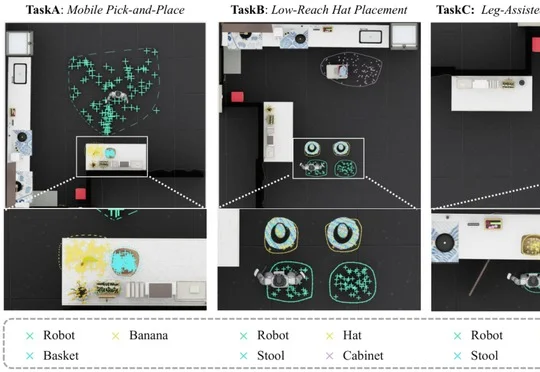
Real2Sim2Real 为此提供了一条路径:将真实场景重建为仿真环境,在其中生成示范、训练策略,再将技能迁移回真实机器人。但要让这条路径支撑人形机器人的全身操作,仍需跨过两道门槛。
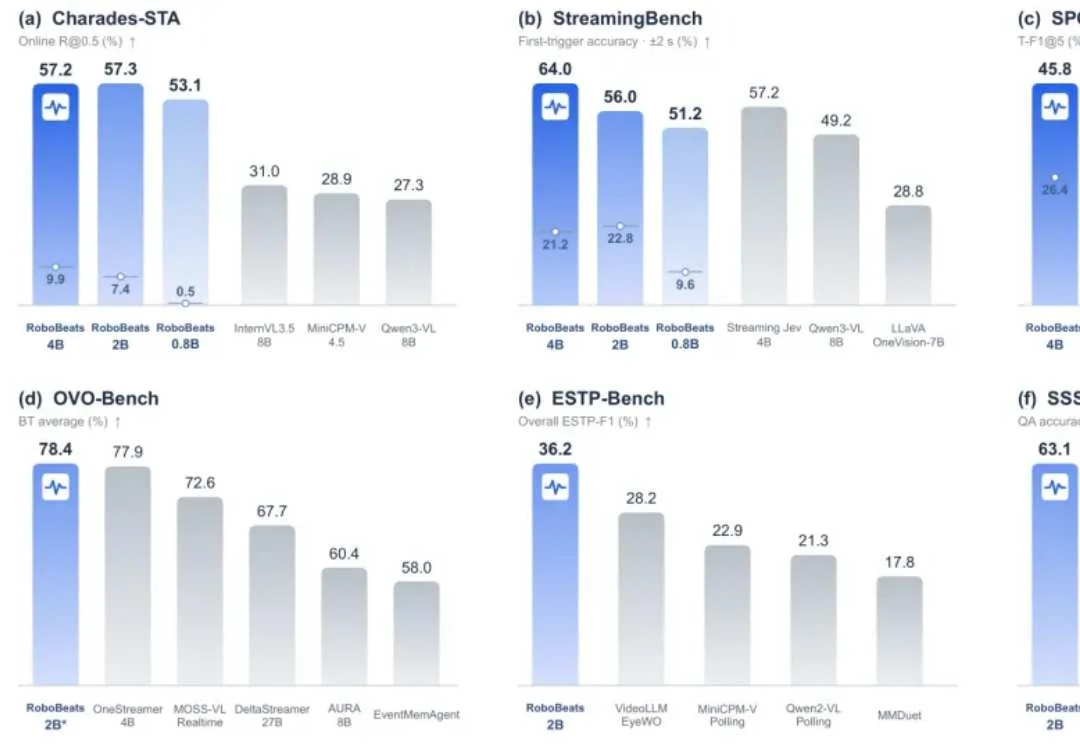
现有的具身智能体大多存在一个结构性缺陷:它们是“任务驱动”的。接到指令,启动推理与工具调用;任务结束,系统归于沉寂。这种离散的交互模式,导致智能体缺乏对环境的持续感知,也没有跨时段的长程记忆。
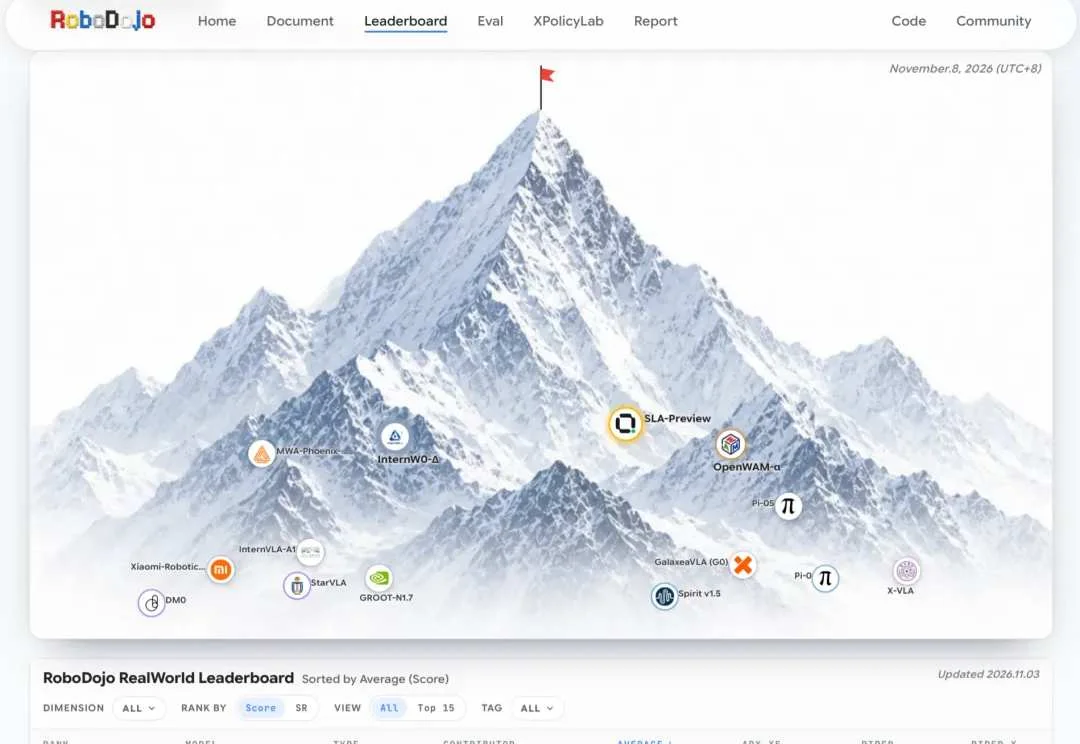
把空间理解放进基础模型的持续学习过程,机器人能否更好地应对现实中的变化?
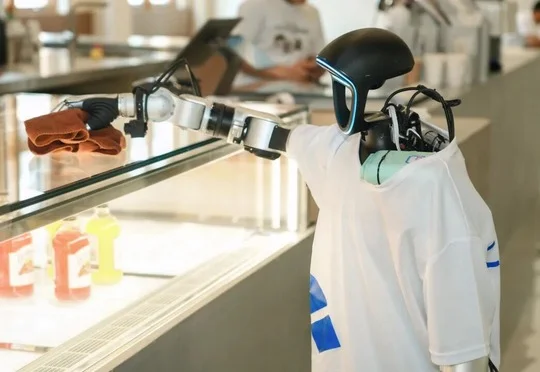
刻行时空完成近亿元pre-A轮融资,资金将投入预部署环境、数据理解专用模型和数据基建,其首批交付的宇树真机数据通过率接近100%。
在机器人操作研究中,视觉语言动作模型(Vision-Language-Action,VLA)与世界动作模型(World Action Model,WAM)为机器人提供了不同的动作生成路径。但当任务从一次抓放延伸到连续搭建与双臂协同,决定成败的就不只是眼前这个动作能否完成,还包括此前建立的条件能否一直支撑后续执行。
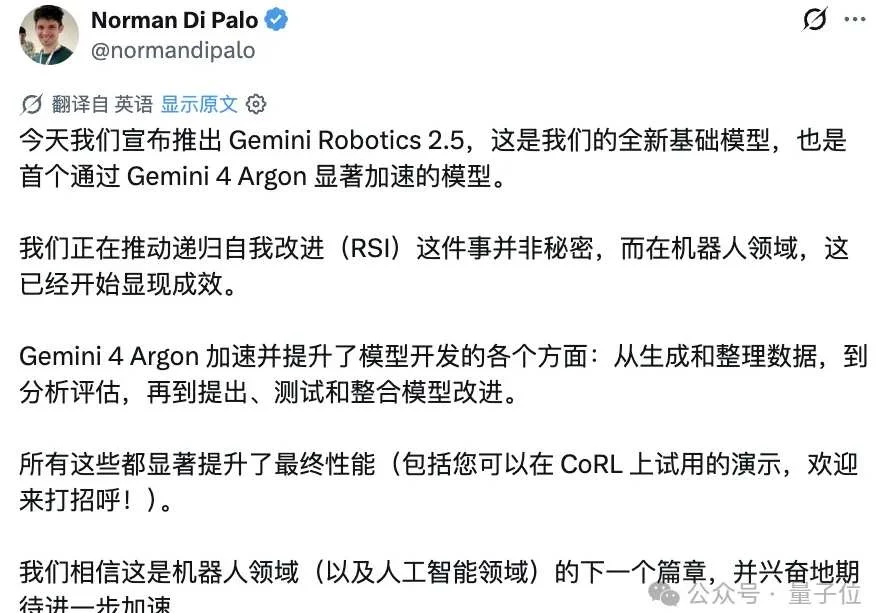
谷歌具身RSI新成果来了!
机器人正迎来自己的 Computer Use 时刻。
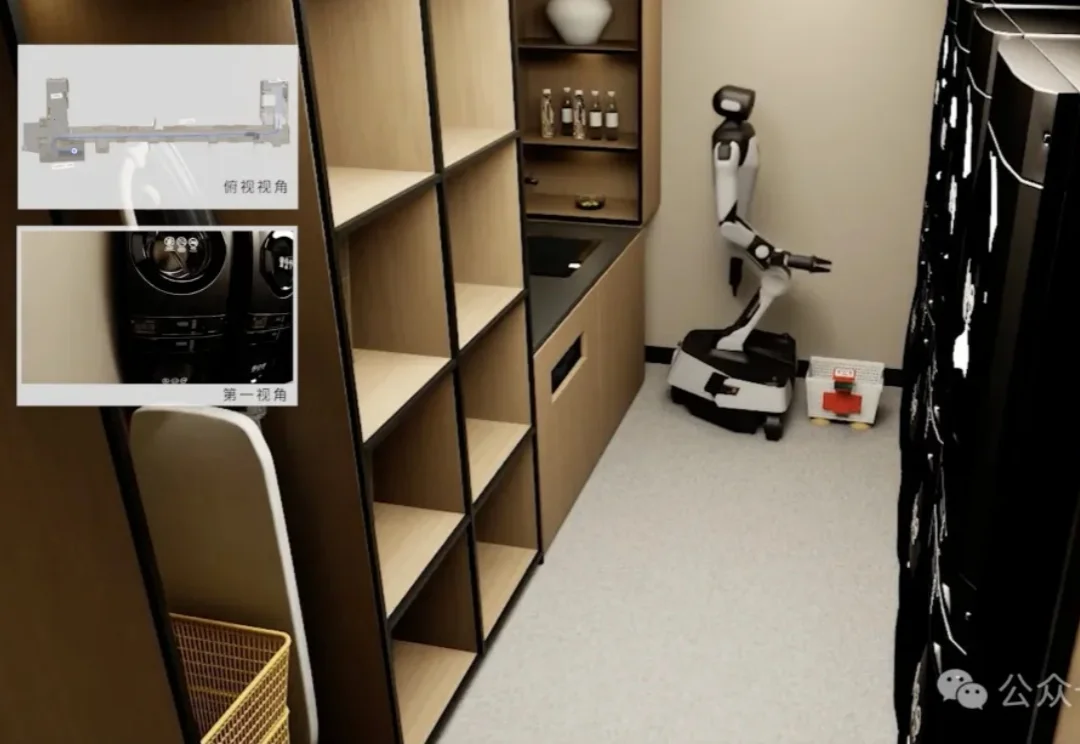
啥,机器人已经能接管酒店洗衣房了??