速递|谷歌推出两款新TPU芯片,加速挑战英伟达,2028年销售额或突破1350亿美元
速递|谷歌推出两款新TPU芯片,加速挑战英伟达,2028年销售额或突破1350亿美元谷歌推出TPU 8tx和8i Max,分别面向机密计算与长上下文任务,预计明年上市,其TPU相关销售额到2028年有望超过1350亿美元。
来自主题: AI资讯
8973 点击 2026-11-13 17:09

 搜索
谷歌推出TPU 8tx和8i Max,分别面向机密计算与长上下文任务,预计明年上市,其TPU相关销售额到2028年有望超过1350亿美元。
智能正在走向更持续的理解与行动。围绕一个目标,Agent 理解上下文、制定计划,在执行中验证判断;面对新的信息,它重新评估已有结论,调整行动路径,继续推进任务。未来,更多智能将融入我们日常使用的应用。
继 Apex-35B-V1.0 凭借领先 Flint 的表现引发关注之后,开源 RSI 模型又迎来一份亮眼成绩单:REMORY 仅凭一个 1.9B 的记忆模块,用两张 H800 实现完全自监督训练,在多项关键评测中领跑;驱动小模型持续数日递归改进,产出接近 GPT-6.1-Terra。
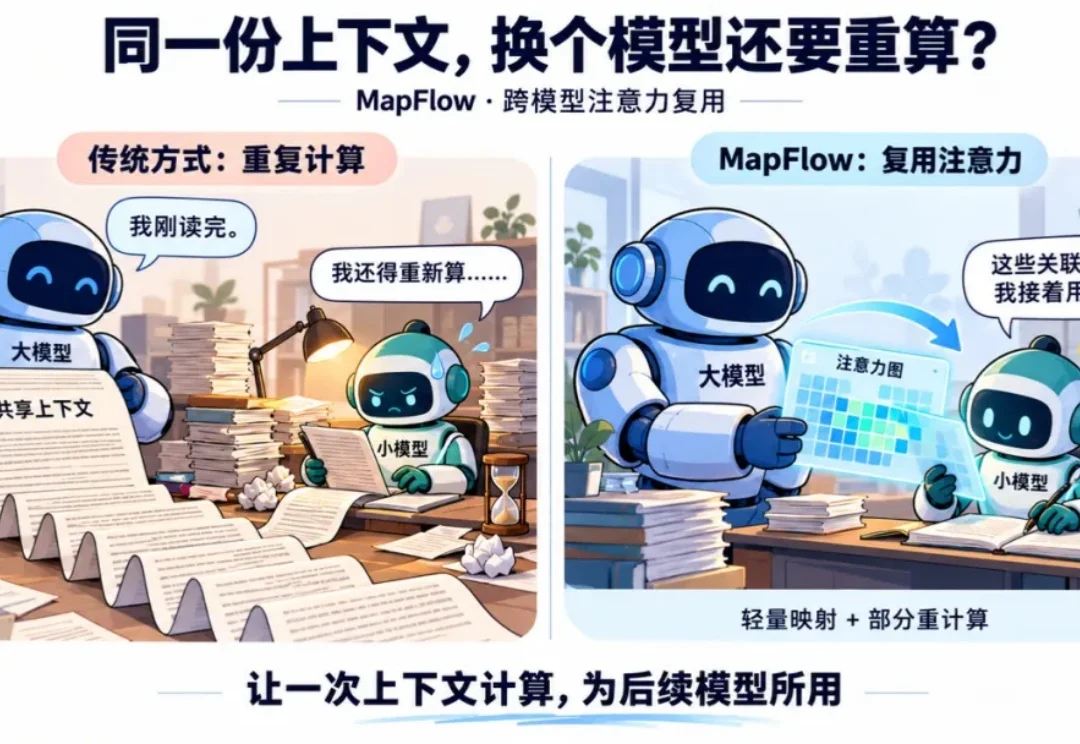
模型 A 负责规划,模型 B 负责细化和总结;复杂问题交给强模型,简单问题交给轻量模型——多模型协作,为 AI Agent 应用提供了兼顾效果与成本的路径。
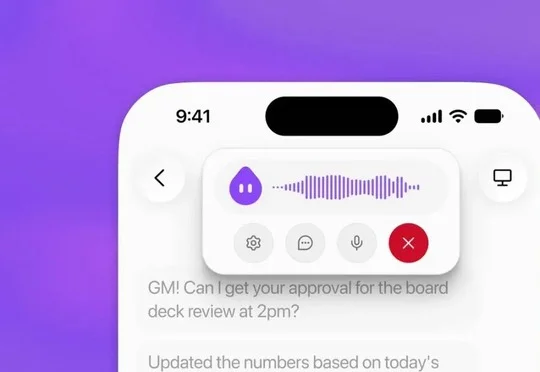
Muse 的实时语音与拟人化形象降低了个人 AI 的交互门槛,并通过承接琐碎需求积累上下文,但研究显示过度使用语音 AI 可能加剧孤独感与情感依赖。
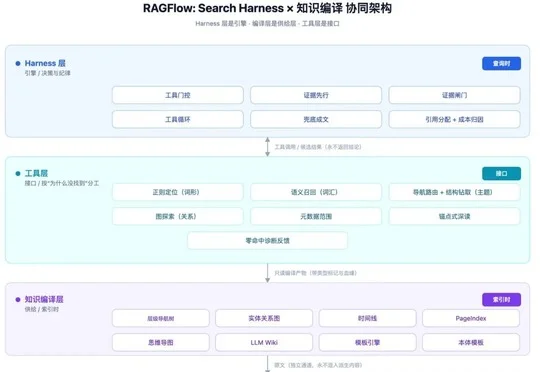
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
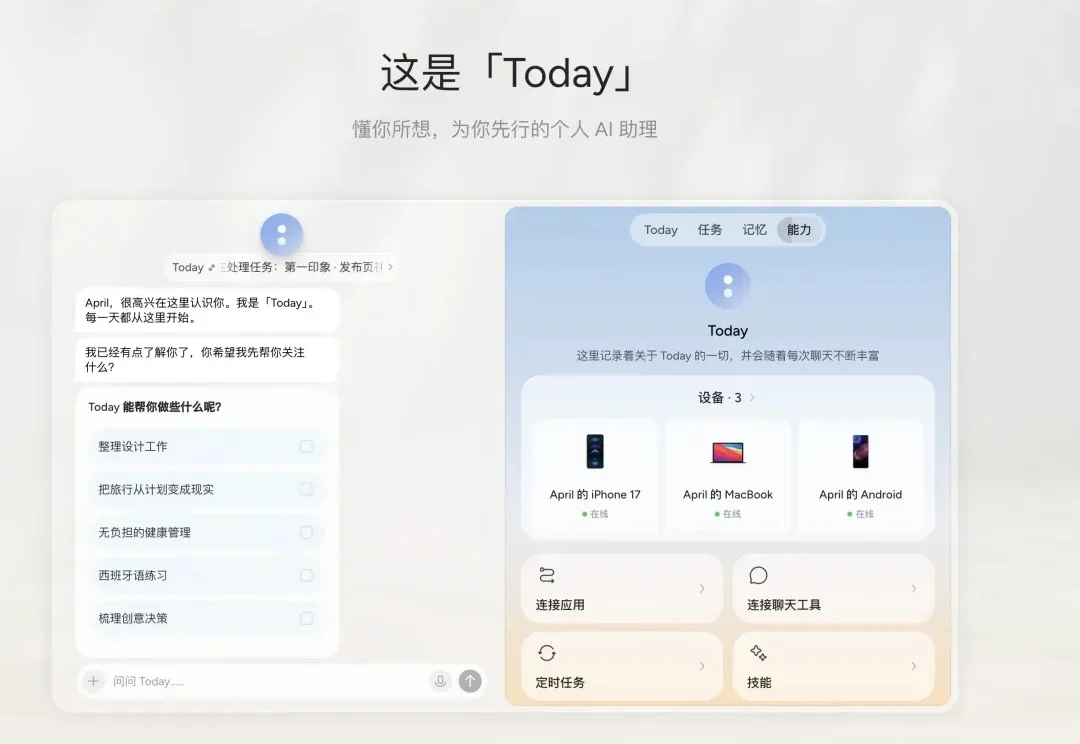
DeepSeek Harness 团队前几天发了篇关于 Super-agent 设计探索的长文,想用 Router + Worker 双层架构,把一个人管理多个 Agent 的负担交给系统。文章出来后讨论不少,大多关注这套调度机制是怎么设计的。
百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
由前 Manus 成员 Cecilia 与 Tianyi 创立的 Persom 推出本地优先的 Personal Agent,在用户授权下将电脑中的工作与生活上下文沉淀为可由其他 Agent 调用的 Personal Database,并持续沉淀工作流与个人判断。
Anthropic 开源了基于零知识密码学的 FlashProve,使用户无需获取模型权重即可验证回答确由指定模型生成;该系统已在 4000 亿参数的 Llama 4 Maverick 上达到约 110 Token/s,但仍是受成本和上下文限制的研究原型。