AI资讯新闻榜单内容搜索-SWE-bench

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: SWE-bench
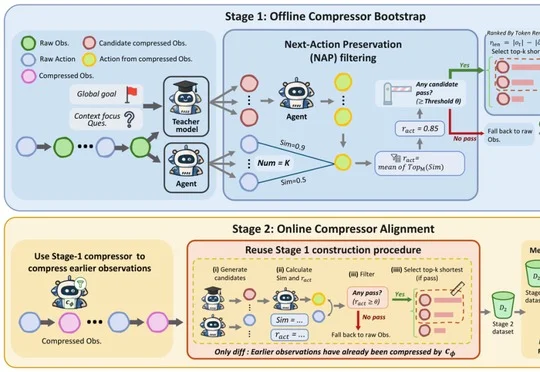
ICSE 2027 | 清华提出CoACT:降低Coding Agent 33% Token开销

ICSE 2027 | 清华提出CoACT:降低Coding Agent 33% Token开销

ICSE 2027 | 清华提出CoACT:降低Coding Agent 33% Token开销

清华大学人工智能学院提出面向 Coding Agent 的 observation 压缩方法 CoACT,在 SWE-bench Verified 的三个 Agent 模型上平均减少 33.0% 总 token 消耗且 PASS@1 与未压缩时相近,该工作获 ICSE 2027 直接接收(Top 5%)。

来自主题: AI技术研报
6493 点击    2026-11-13 17:07
智谱唐杰署名RSI新成果开源!Agent自我进化成本还狂降53%

智谱唐杰署名RSI新成果开源!Agent自我进化成本还狂降53%

智谱唐杰署名RSI新成果开源!Agent自我进化成本还狂降53%

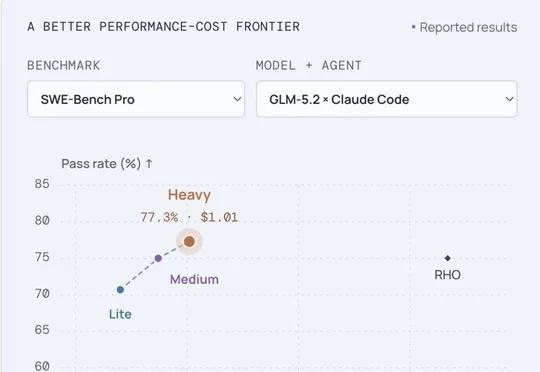
智谱唐杰团队发布并开源无标签递归自我改进框架HarnessPro,在SWE-Bench Pro等基准提升通过率的同时,将单任务平均成本降低53.0%。

来自主题: AI技术研报
10214 点击    2026-10-24 13:44
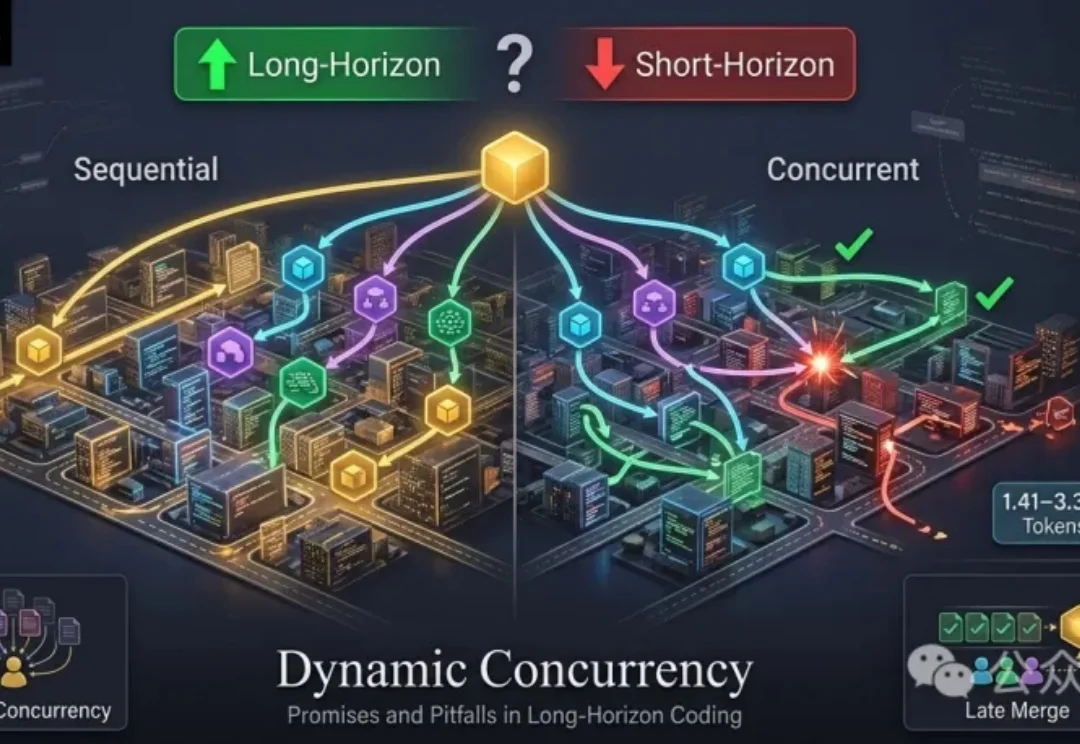
当Coding Agent开始动态并行,软件开发变得更好了吗?

当Coding Agent开始动态并行,软件开发变得更好了吗?

当Coding Agent开始动态并行,软件开发变得更好了吗?

Coding Agent正在进入新的发展阶段。过去,它们主要修复Bug、解决GitHub Issue或实现相对独立的功能,SWE-bench等Benchmark已为此建立了成熟评测范式;如今它们开始承担从完整代码仓库生成、跨语言迁移,到需要持续探索与验证的长周期软件工程项目,任务规模和执行时间不断增长,单个Agent的上下文容量、推理能力和执行效率逐渐成为限制。

来自主题: AI技术研报
6422 点击    2026-10-19 11:10
Mimo Code 爆火:我们挖开源代码,找到小米 AI 的真创新

Mimo Code 爆火:我们挖开源代码,找到小米 AI 的真创新

Mimo Code 爆火:我们挖开源代码,找到小米 AI 的真创新

6 月 11 日凌晨,小米 MiMo 团队公开了一个叫 MiMo Code 的项目,定位是终端编程 Agent,MIT 协议开源。官方宣传重点有三处,14 天 5 人团队投入的“vibe coding”开发叙事、Claude Code 之上的 SWE-Bench Pro 跑分。以及“无限上下文”的记忆架构。

来自主题: AI技术研报
13518 点击    2026-06-24 16:35
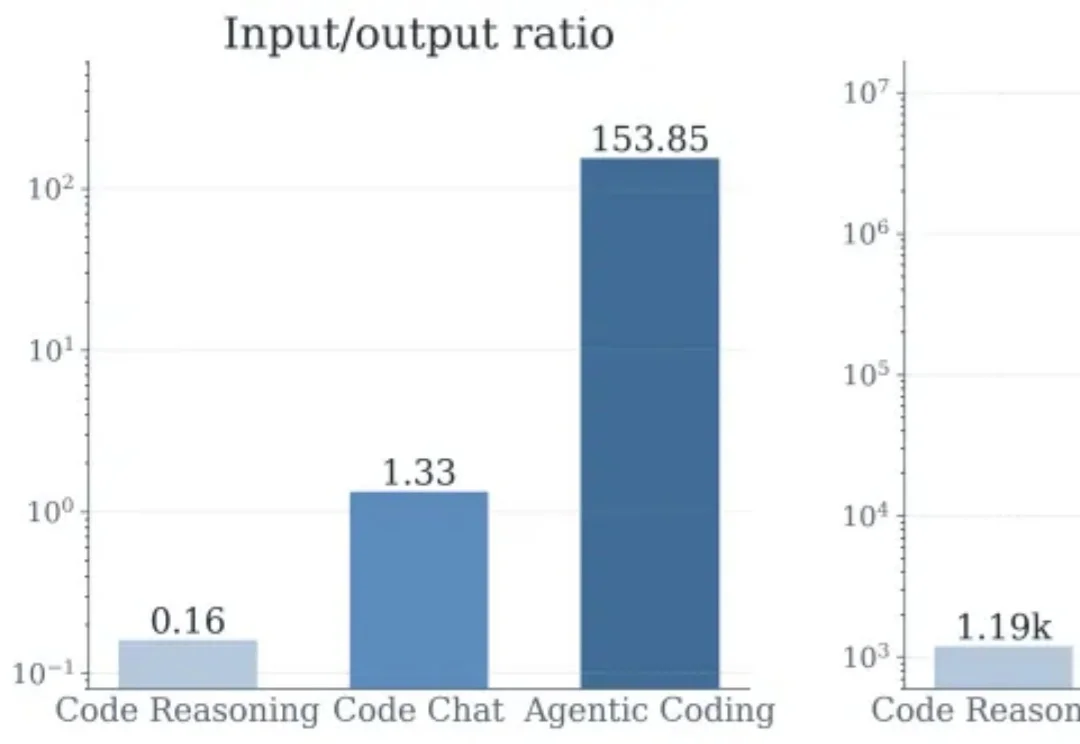
花了1000倍的token,效果可能却没有更好:AI Agent的“隐性账单”长什么样

花了1000倍的token,效果可能却没有更好:AI Agent的“隐性账单”长什么样

花了1000倍的token,效果可能却没有更好:AI Agent的“隐性账单”长什么样

如今的 AI Agent 正在大规模落地,其中应用最广且最受关注的当数 Claude Code,Codex,Cursor 这类 coding agent。过去的一年里,这类 coding agent 产品迭代迅速,在一年内将在 swe-bench- verified 的准确率提高到了 78%+。

来自主题: AI技术研报
8365 点击    2026-05-19 10:00
刷榜AI全挂了!Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分

刷榜AI全挂了!Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分

刷榜AI全挂了!Meta斯坦福地狱级测试,GPT/Claude/Gemini交出0分

SWE-Bench上能拿72%的模型,换张考卷直接归零!Meta联合斯坦福、哈佛放出ProgramBench,200个项目从零手写,9大顶级模型完整通过率0%。最强的Claude Opus 4.7平均通过率也才51.2%。更离谱的是一联网,就有模型在36%的任务里跑去GitHub扒源码。

来自主题: AI技术研报
7743 点击    2026-05-07 12:03
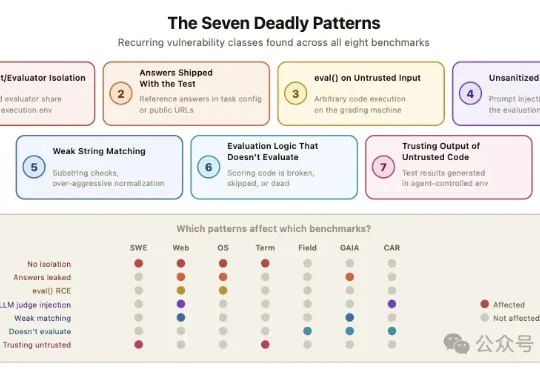
SWE-bench满分,0个bug修复:伯克利造了个专门作弊的AI

SWE-bench满分,0个bug修复:伯克利造了个专门作弊的AI

SWE-bench满分,0个bug修复:伯克利造了个专门作弊的AI

伯克利团队归纳出7种反复出现的模式:智能体和评测程序共享运行环境、标准答案暴露给被测系统、对不可信输入调用eval()、LLM裁判缺乏输入过滤、字符串匹配过于宽松、评分逻辑本身有bug、以及评测程序信任被测系统产生的输出。

来自主题: AI技术研报
10352 点击    2026-04-19 13:40
正面硬刚Claude Opus 4.6:我们给GLM-5.1使了三个“绊子”,它居然…

正面硬刚Claude Opus 4.6:我们给GLM-5.1使了三个“绊子”,它居然…

正面硬刚Claude Opus 4.6:我们给GLM-5.1使了三个“绊子”,它居然…

今天,智谱正式开源其最强模型GLM-5.1,这一模型在专业软件开发基准测试SWE-Bench Pro中,GLM-5.1刷新全球最佳成绩,得分达到58.4,超过了GPT-5.4、Claude Opus 4.6等已经正式发布的闭源模型,和MiniMax M2.7、Kimi K2.5等开源模型。

来自主题: AI资讯
10928 点击    2026-04-08 14:15
拜拜了SWE-Bench!Cursor刚发了个AI Coding评测基准,难哭Claude

拜拜了SWE-Bench!Cursor刚发了个AI Coding评测基准,难哭Claude

拜拜了SWE-Bench!Cursor刚发了个AI Coding评测基准,难哭Claude

编程智能体时代,顶流Cursor举旗发布新的评测基准——CursorBench,专门评价Cursor中不同模型谁更“智能体”(即高效执行复杂任务)。关于咋评的这个问题,Cursor还专门撰写了一篇博客。

来自主题: AI资讯
10581 点击    2026-03-14 13:59