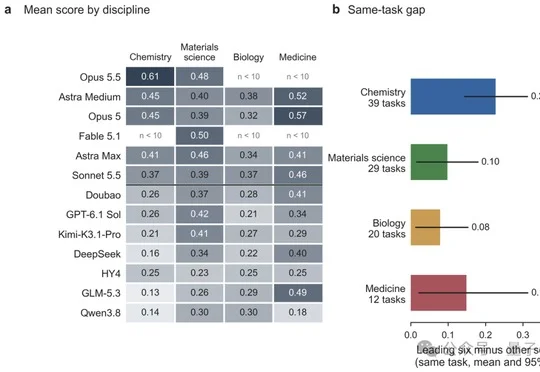
「史上最严」湿实验预测基准发布!推理拉满、算力翻5倍也白搭
「史上最严」湿实验预测基准发布!推理拉满、算力翻5倍也白搭UniPat AI牵头推出Science Prediction Universe(SPU)湿实验预测基准,以116个任务、4207个实验评测12款前沿模型,首轮Claude Opus 5.5平均分最高但仅约半数任务超过随机水平,GPT-6 Astra推理强度升至最高也未显著提分。
来自主题: AI技术研报
9214 点击 2026-11-15 11:29

 搜索
UniPat AI牵头推出Science Prediction Universe(SPU)湿实验预测基准,以116个任务、4207个实验评测12款前沿模型,首轮Claude Opus 5.5平均分最高但仅约半数任务超过随机水平,GPT-6 Astra推理强度升至最高也未显著提分。
OpenAI简直漏风漏得跟筛子一样,关于最新Spud(土豆)模型的消息,又双叒叕来了。这颗「土豆」,就是万众瞩目的GPT-6。据爆料,这颗「土豆」已经彻底煮熟了,4月14号就会发布。
昨天,OpenAI总裁Greg Brockman在Big Technology Podcast上,亲口透露了他们研究两年的重磅模型成果——Spud大模型。
半年前,DeepSeek R1 的推出轰动了全球,无论东西方都是火的一塌糊涂,更是被外网称为 AI 领域的 Sputnik 时刻。

来自华盛顿大学、AI2、UC伯克利研究团队证实,「伪奖励」(Spurious Rewards)也能带来LLM推理能力提升的惊喜。