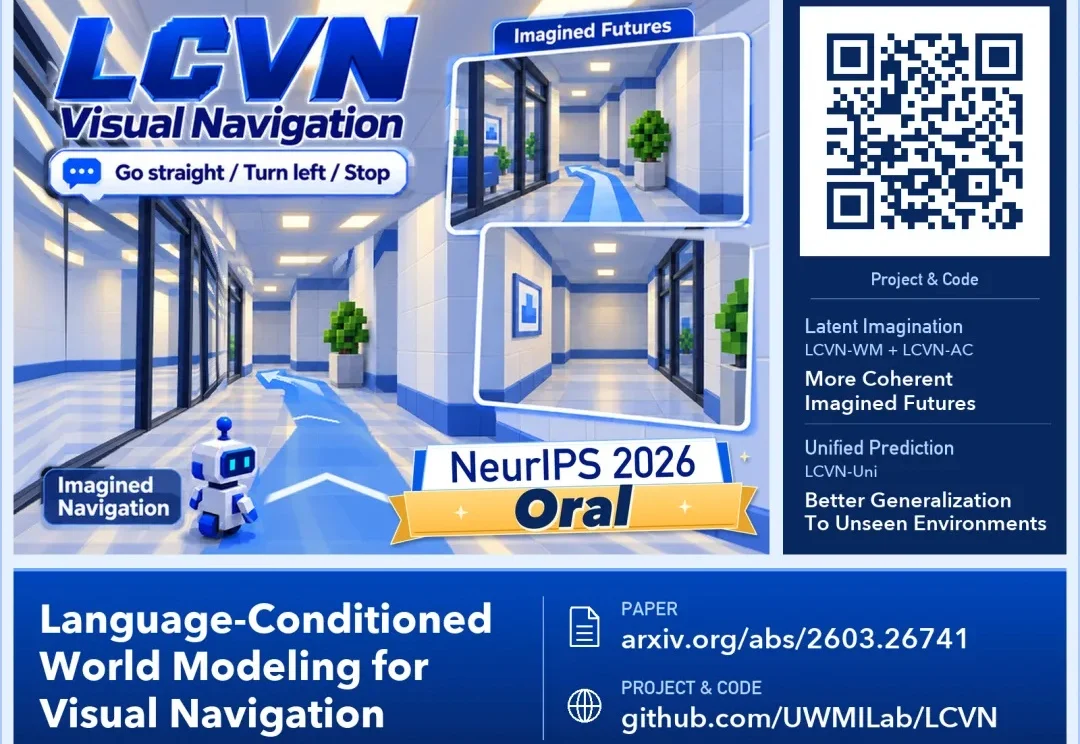
NeurIPS 2026 Oral|LCVN:一张起始画面、一段语言指令,能否预测完整的导航路线?
NeurIPS 2026 Oral|LCVN:一张起始画面、一段语言指令,能否预测完整的导航路线?「沿着走廊直走,经过左侧玻璃墙后,在拐角左转,继续走到墙边停下来。」
来自主题: AI技术研报
7870 点击 2026-11-09 10:49

 搜索
「沿着走廊直走,经过左侧玻璃墙后,在拐角左转,继续走到墙边停下来。」
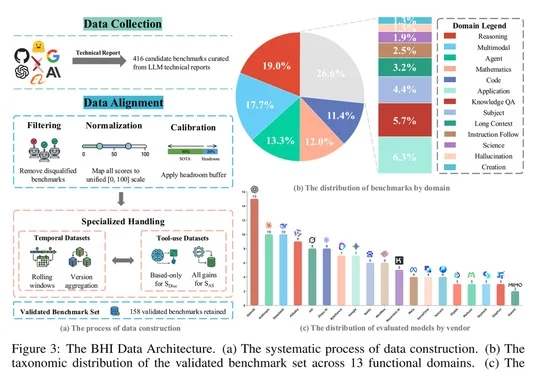
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
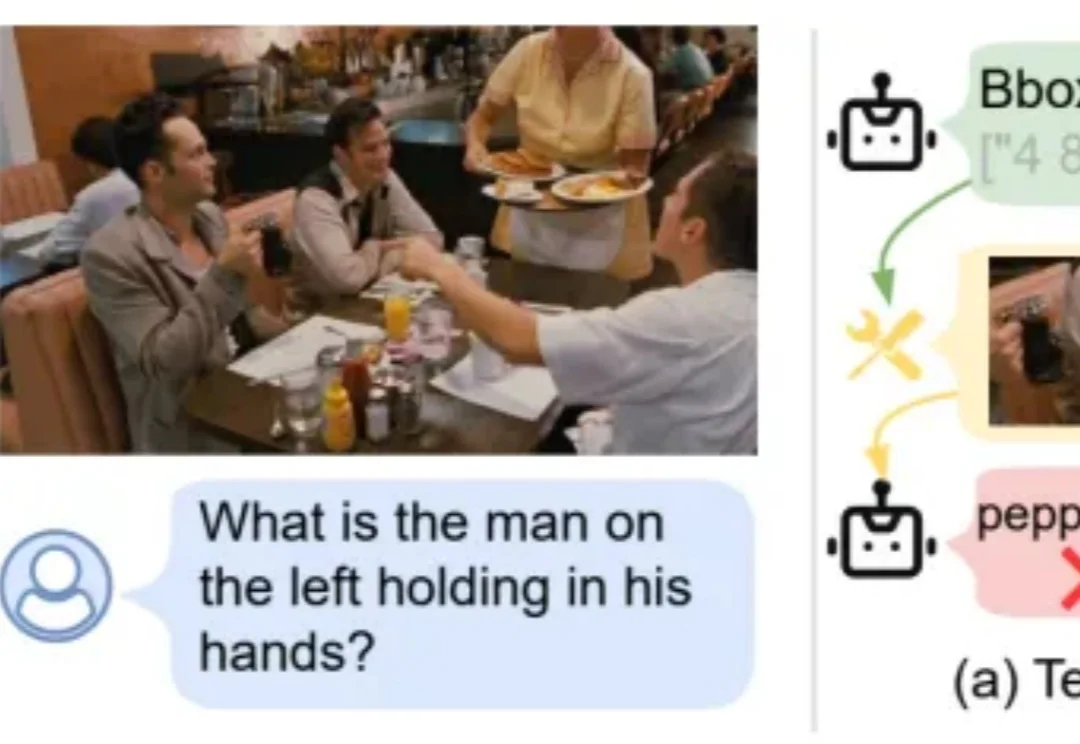
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
只要和一个人聊得足够久,大模型就能成为他的「数字分身」吗?
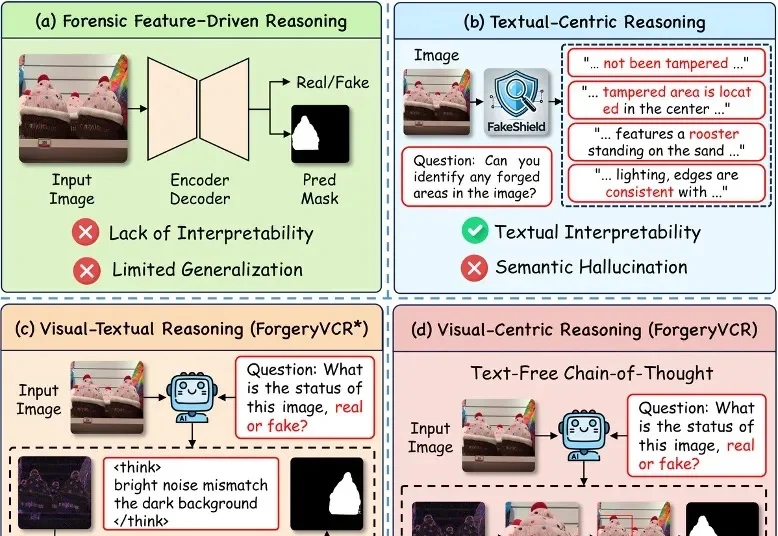
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
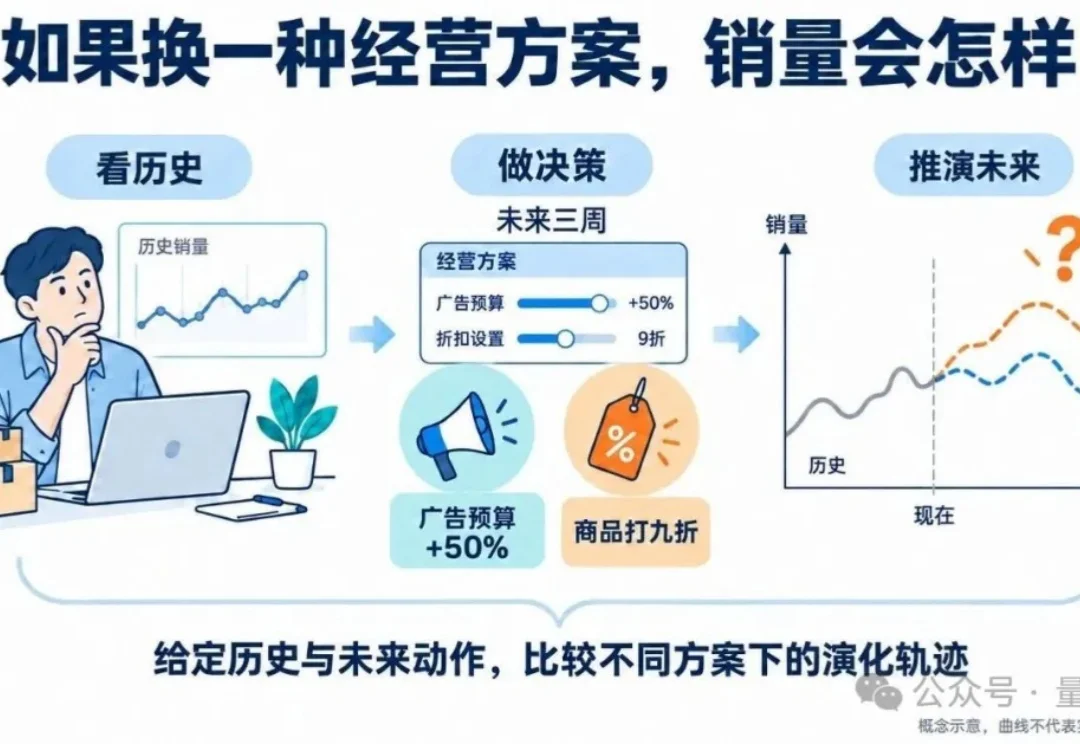
真实世界的时间序列,不仅被外部事件冲击,也被人为决策持续重塑。

蚂蚁灵波开源的流式3D重建模型LingBot-Map凭借几何上下文注意力机制在GitHub获16.9K Stars后,其论文入选ECCV 2026 Oral,全球开发者围绕该项目完成Apple Silicon桌面前端、RTX 4060低显存适配及Ray-Ban Meta智能眼镜采集等多种二次开发。
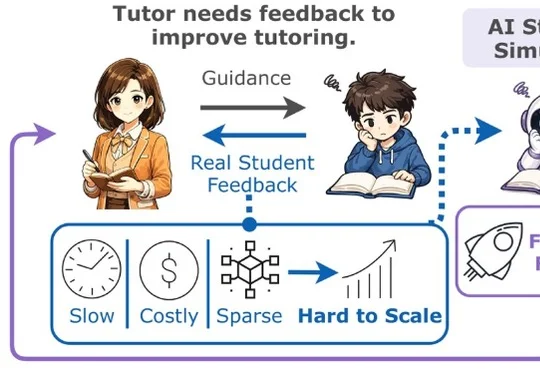
微软与UIUC合作研究StudentSim框架,基于真实学生数据训练个性化学生模拟器,具备behavioral fidelity和guidance responsiveness两项能力,在国际象棋等三个领域验证其优于现有基线,并可作为AI教师强化学习的高通量奖励信号。
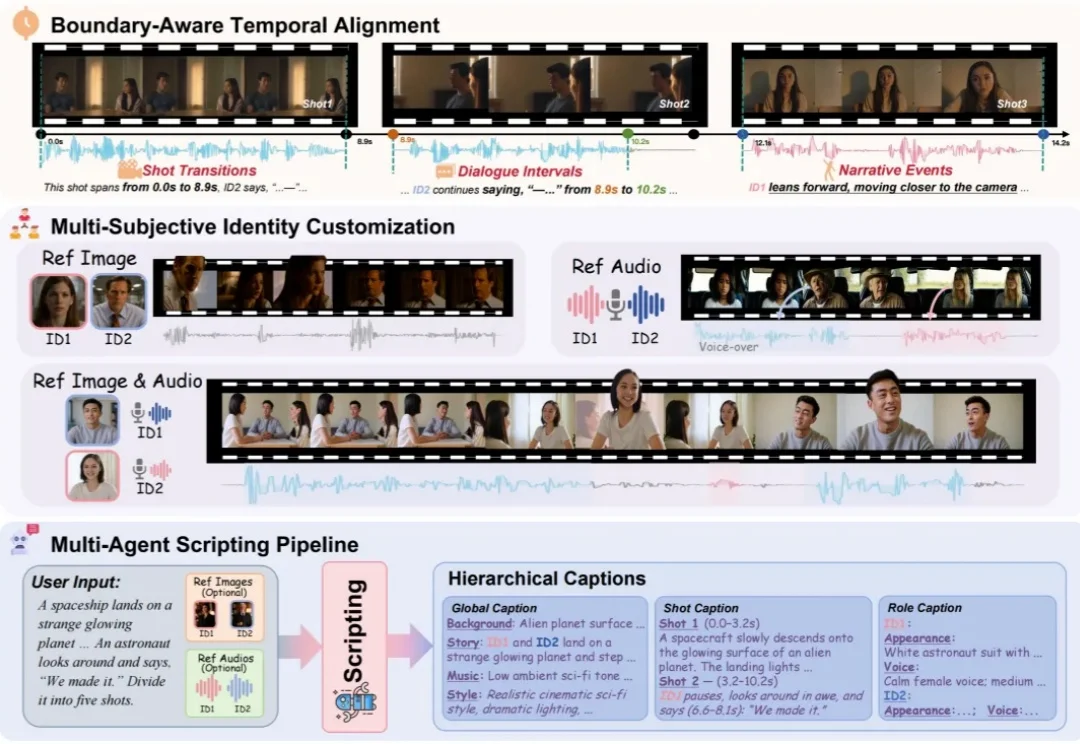
过去几年,视频生成模型在清晰度、运动表现和画面质感上不断进步。输入一句文字,模型已经能够生成颇具电影感的视频。
给图像生成模型一张人物参考图,它大概率能抓住身份特征。