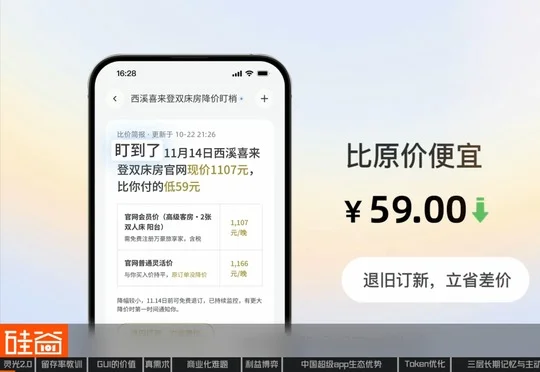
聊聊中国版MUSE:蚂蚁灵光2.0,支付宝,超级App的生态优势与挑战
聊聊中国版MUSE:蚂蚁灵光2.0,支付宝,超级App的生态优势与挑战蚂蚁灵光CTO莫林剑(花名:林怿)表示,蚂蚁灵光2.0已从“一句话生成闪应用”转向围绕用户目标持续跟踪并执行任务的个人智能体,可借助支付宝等生态接入真实服务,但可靠性、用户信任、平台利益协调与商业化仍是主要挑战。
来自主题: AI资讯
7705 点击 2026-11-13 17:08

 搜索
蚂蚁灵光CTO莫林剑(花名:林怿)表示,蚂蚁灵光2.0已从“一句话生成闪应用”转向围绕用户目标持续跟踪并执行任务的个人智能体,可借助支付宝等生态接入真实服务,但可靠性、用户信任、平台利益协调与商业化仍是主要挑战。
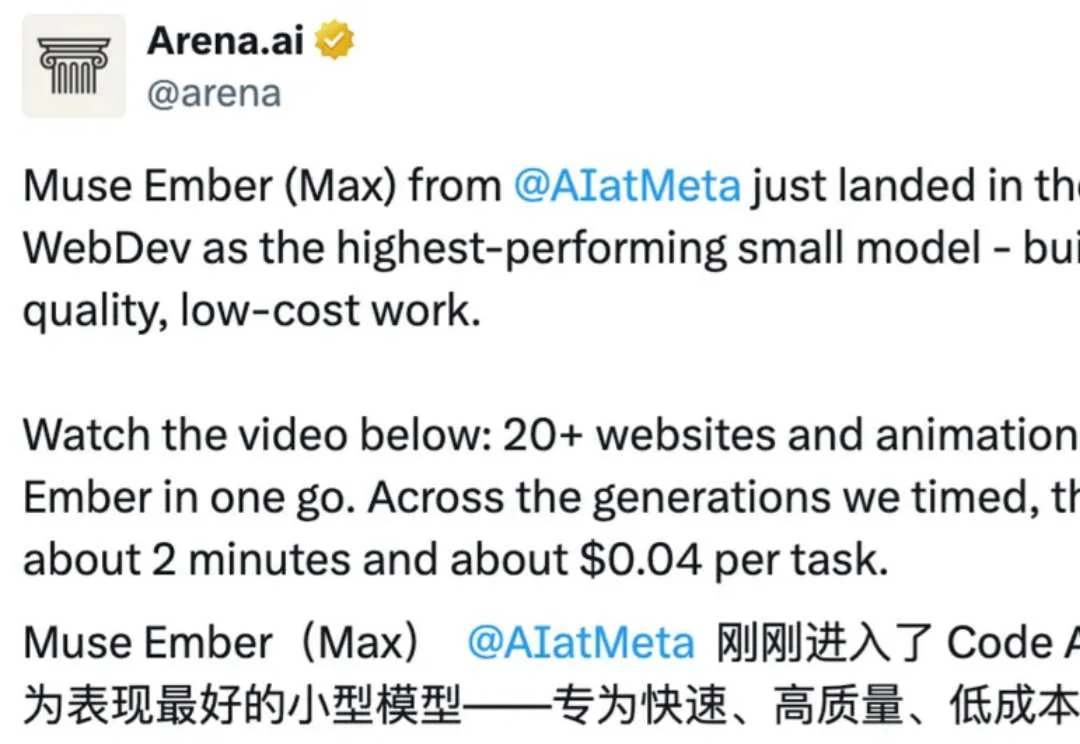
2分钟,4美分,一个网站!
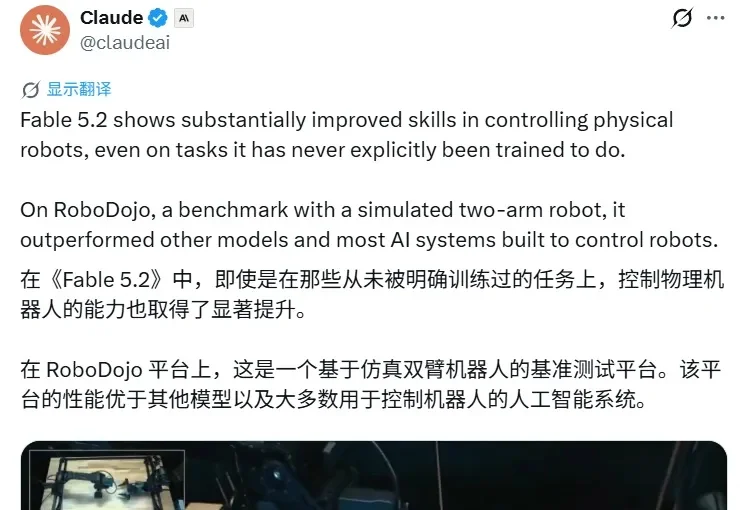
今天凌晨,Anthropic 一口气发布两款顶级模型 Claude Fable 5.2 和 Mythos 5.2。新模型在科学研究方面展示了多项成果,包括通过约 1000 个 AI 智能体协作,仅用 30 小时完成费马大定理证明的形式化。
单项任务成本约为Claude Haiku 5.5的三分之一。
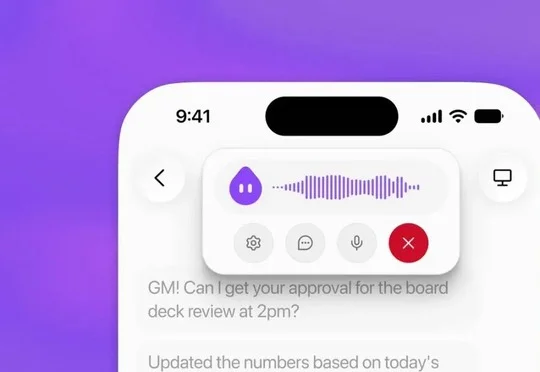
Muse 的实时语音与拟人化形象降低了个人 AI 的交互门槛,并通过承接琐碎需求积累上下文,但研究显示过度使用语音 AI 可能加剧孤独感与情感依赖。
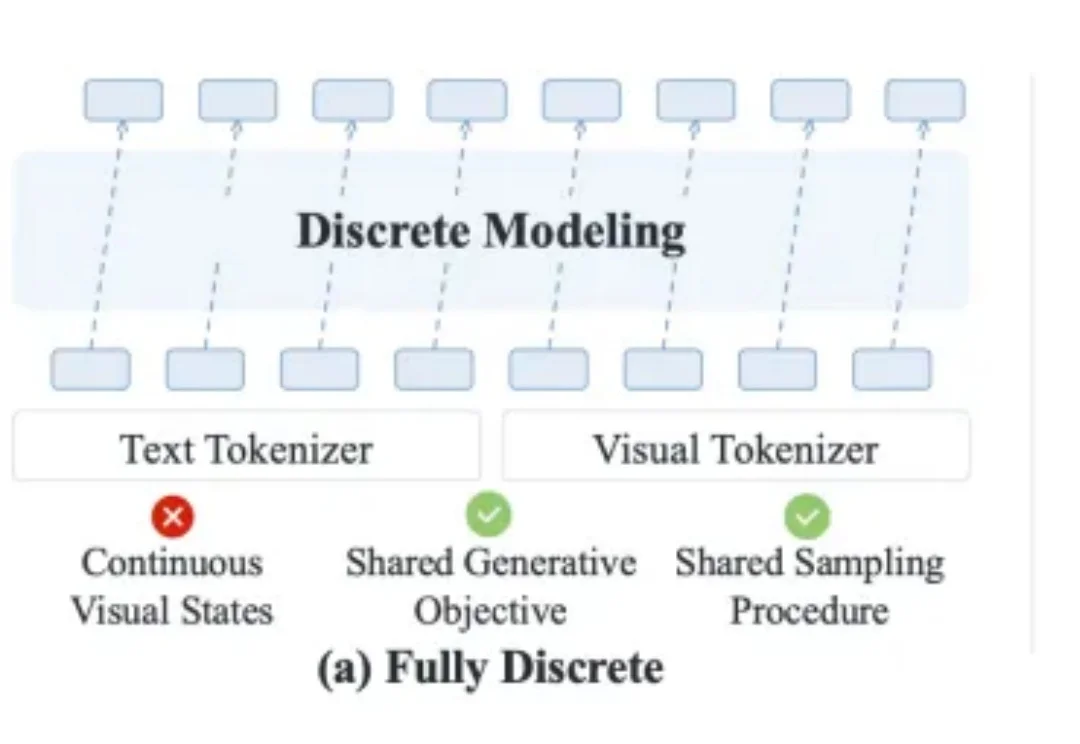
走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
10 月初,我在旧金山的一家川菜馆,和经济学家泰勒·科文吃了一顿饭。
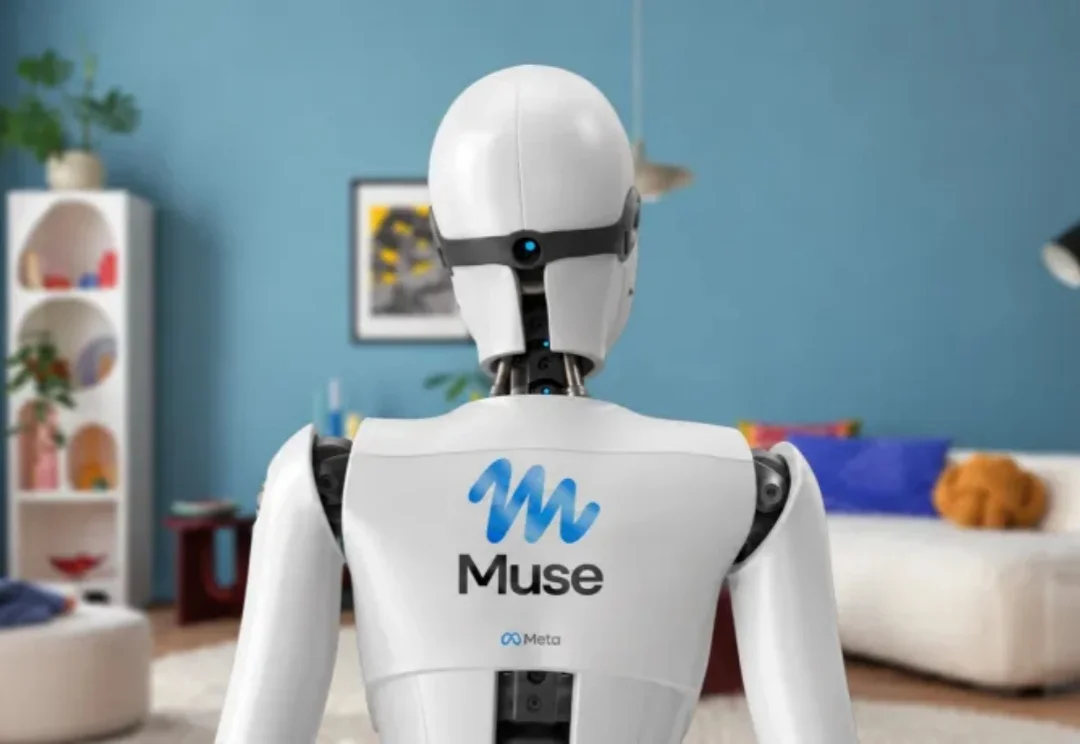
Meta机器人业务产品副总裁曾来上海工作近两个月。
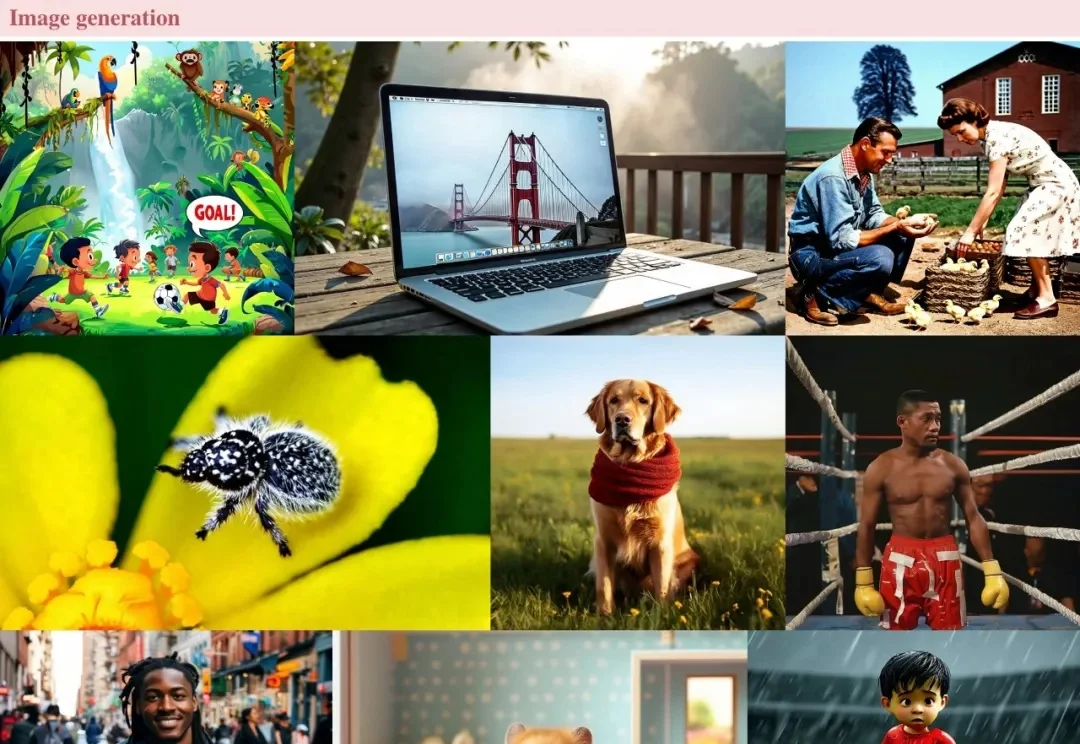
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
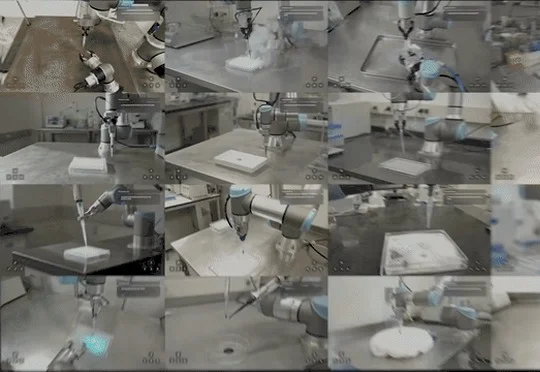
大晓机器人联合南洋理工大学S-Lab发布世界模型Mundo,通过照片重建可探索、可交互的物理环境,并支持多款机器人训练及酒店场景实测。