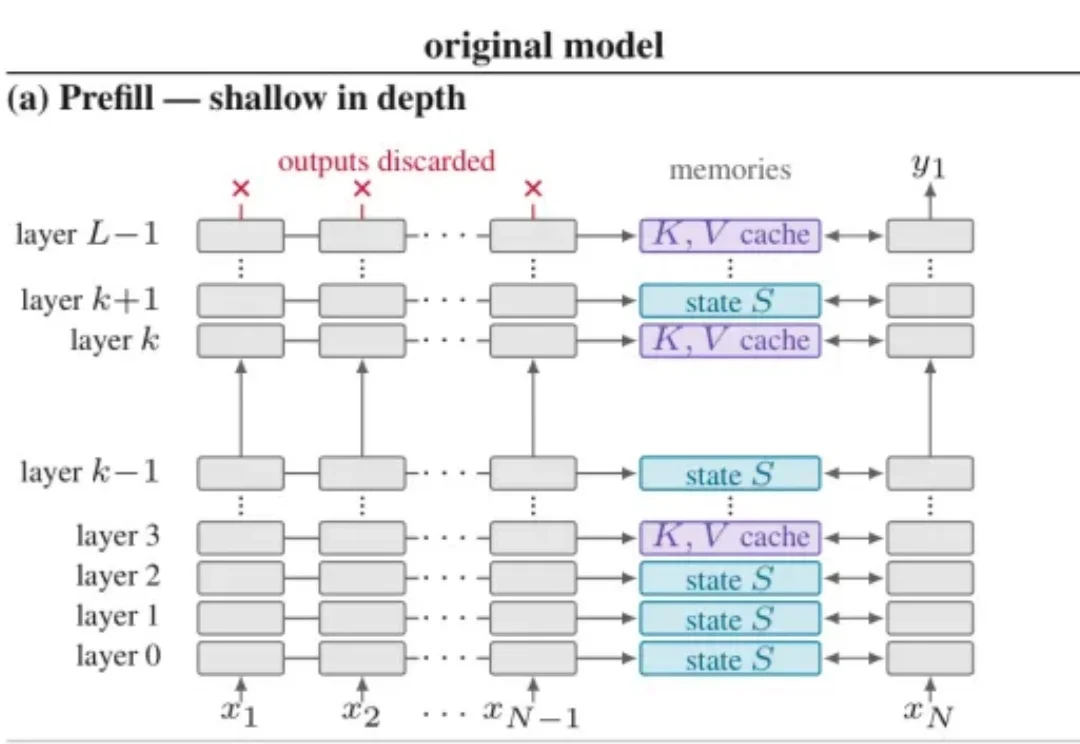
写入记忆,何必读完整个网络?英伟达SEED每GPU吞吐最高提升42%
写入记忆,何必读完整个网络?英伟达SEED每GPU吞吐最高提升42%Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
来自主题: AI技术研报
5829 点击 2026-11-19 14:50

 搜索
Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
累计融资513亿元。
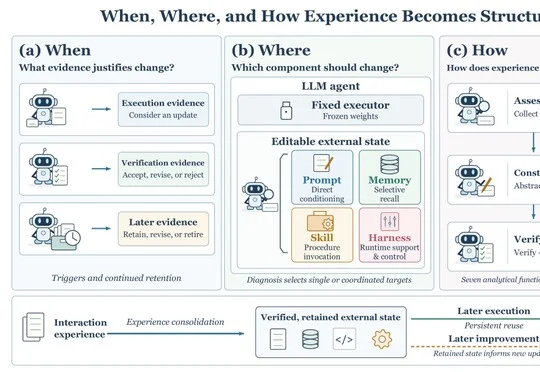
中国科学院自动化研究所、美团等机构推出LLM Agent递归自我改进综述,以Prompt、Memory、Skill和Harness四条主线及When、Where、How三问、七步生命周期,梳理Agent将交互经验转化为可验证、复用且持续维护的改进机制。
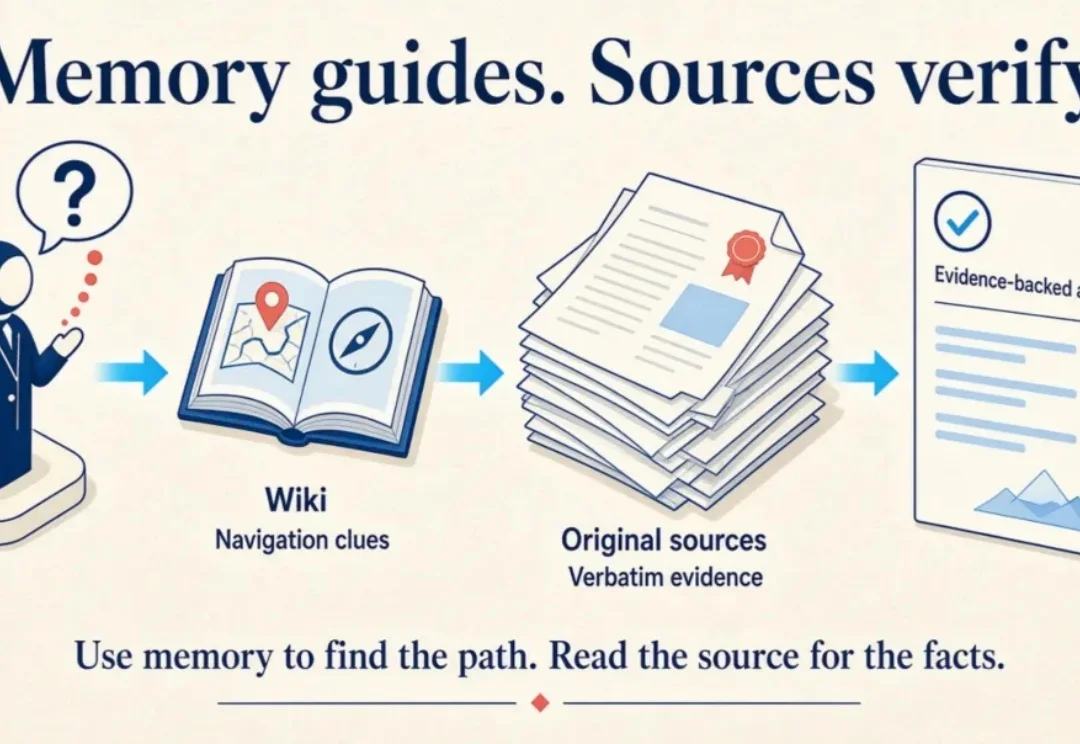
前不久,Anthropic 的工程团队在 11 月 6 日发了一篇文章《The components of agent memory》。里面有一个非常有意思的观察:很多被精心设计过的知识wiki或者Agent Memory准确率有时候还不如直接搜索原始文档高。但换个场景,过多的原始信息塞给模型,有时候也同样会让检索的准确率暴跌。
继 Apex-35B-V1.0 凭借领先 Flint 的表现引发关注之后,开源 RSI 模型又迎来一份亮眼成绩单:REMORY 仅凭一个 1.9B 的记忆模块,用两张 H800 实现完全自监督训练,在多项关键评测中领跑;驱动小模型持续数日递归改进,产出接近 GPT-6.1-Terra。
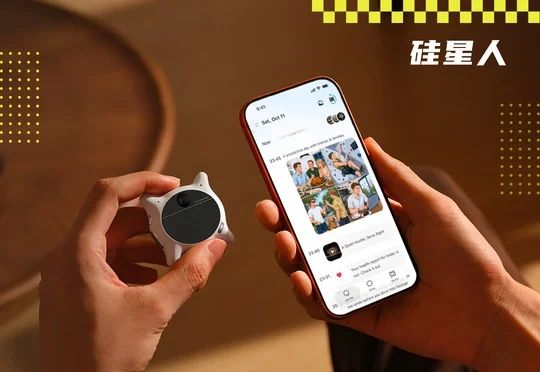
文章认为,Looki以胸前第一视角设备采集现实数据,并通过Loom时序感知模型、Memory和Agent构建可服务不同Personal Agent的Context层,探索从硬件出发的个人AI路线。
MiniMax创始人闫俊杰首次接受Scottish Mortgage播客《Invest in Progress》英文采访,表示低推理成本与开源是公司护城河,中美模型最后5%的差距可能比此前95%更难追,H3月下载量约2500万次。
Alphabet旗下AI药物研发公司Isomorphic Labs正洽谈筹集约50亿美元的新一轮融资,估值预计约500亿美元,交易尚未完成,其AI药物发现项目仍处于临床前阶段。
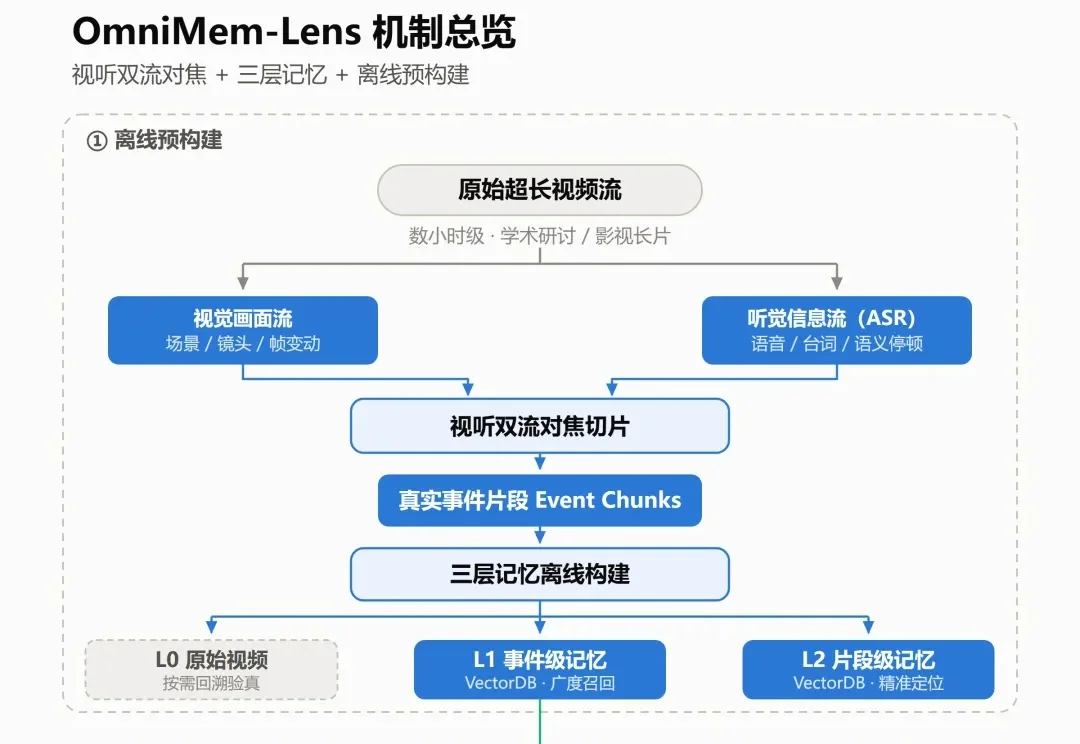
openJiuwen AgentMemory正式上线了多模态记忆能力OmniMem-Lens:按秒盲切是记忆碎片化的元凶,按真实事件记忆才是正解——召回精度最高提升45.7%,在线问答时延最高降低97%。
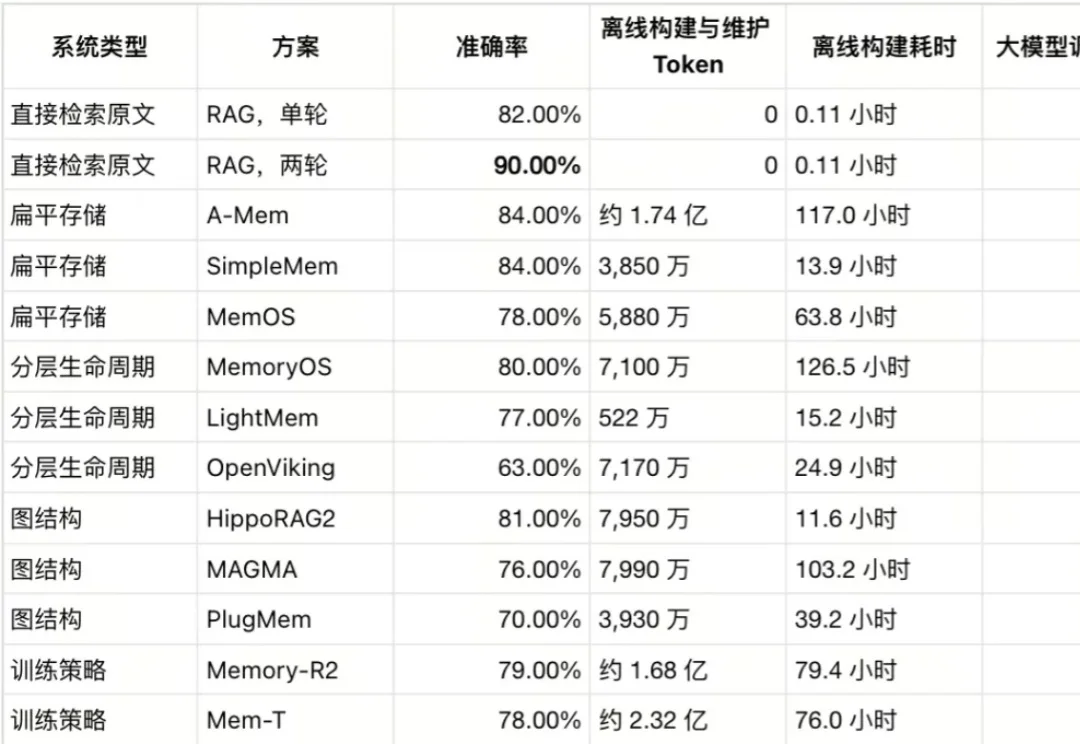
为 Agent 建记忆,花掉了上亿 Token,结果在相当一部分情况下,回答准确率甚至低于直接用RAG检索聊天记录。