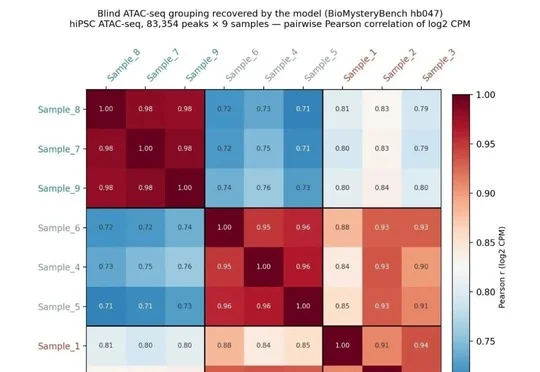
高难盲测超越GPT-6-Astra与Opus-5!无界前沿开源Fx-Bio-1031,把RSI带进生命科学
高难盲测超越GPT-6-Astra与Opus-5!无界前沿开源Fx-Bio-1031,把RSI带进生命科学无界前沿正式开源生物信息大模型Fx-Bio-1031,在BioMysteryBench困难子集取得70.59%的Pass@5,领先GPT-6-Astra和Claude Opus-5。
来自主题: AI资讯
8919 点击 2026-11-14 12:48

 搜索
无界前沿正式开源生物信息大模型Fx-Bio-1031,在BioMysteryBench困难子集取得70.59%的Pass@5,领先GPT-6-Astra和Claude Opus-5。
OpenAI已解散独立机器人研究团队并将人员并入核心研究和Applied部门,称并非退出机器人领域,而是因GPT-6 Astra等通用模型可直接执行机器人任务,推动机器人研发与基础模型更紧密结合。
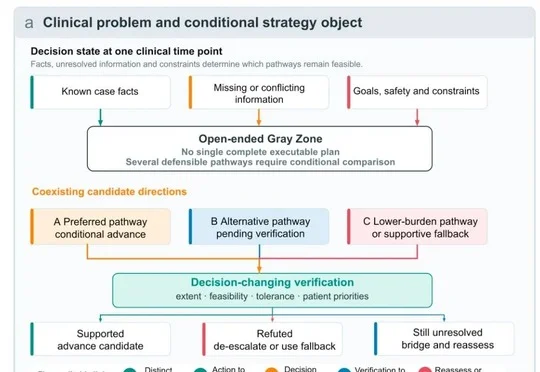
未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
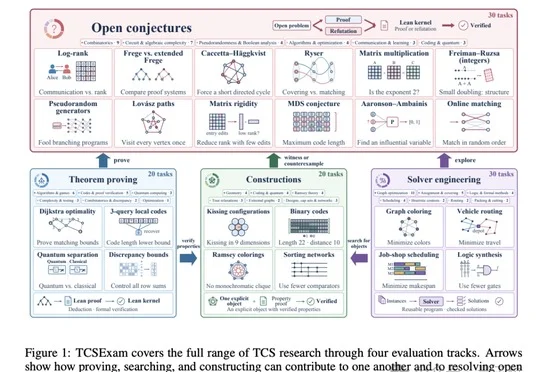
姚期智、杨植麟等发表论文并开源TCSExam基准,GPT-6 Astra以71.9分居首、Kimi K3.1 Pro得57.4分,所测模型均未独立攻破30道开放猜想,但部分数学结果刷新了既有边界。
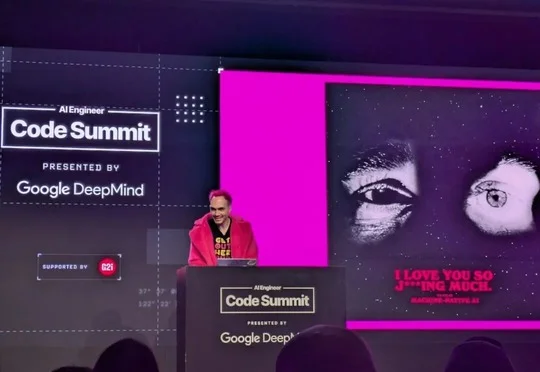
在AIE CODE 2026上,Typesafe联合创始人兼CEO、ChatGPT联合创造者Diogo Almeida介绍只做判断不生成的模型Jev,主张通过RLCD和窄任务训练提升自动化决策的可靠性。
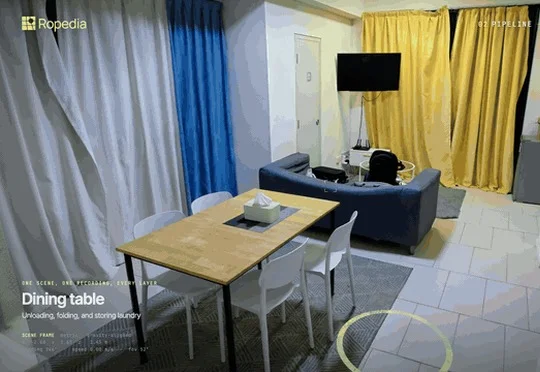
Ropedia发布面向Physical AI的真实环境与行为数据集Xperience 2,将1,589个场景与4,230段任务录像对齐,支持仿真、动作重定向、虚拟遥操作和长程轨迹生成,旨在建立下一代具身数据“金标准”。
月之暗面(Moonshot AI)创始人杨植麟联合清华大学及图灵奖得主姚期智团队推出TCSExam,以机器核验的科研交付物评测大模型,GPT‑6 Astra居Full榜首,开放猜想有效解答仍依赖联网检索改编。
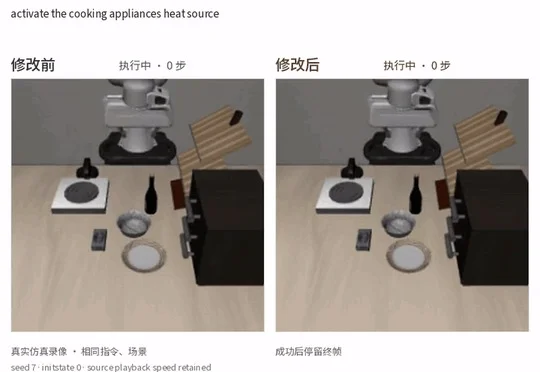
斯坦福研究团队让GPT-6 Astra直接修改π₀.₅机器人策略的65行词嵌入,将765条留出指令的整体成功率从86.3%提升至92.0%,但仍有4个回合退化且结果仅限仿真。
上海交通大学赵海教授团队在arXiv发布BriLLM-MetaPred,首次将AGI数学理论推导的MetaPred原语落地为可运行语言模型,其在约13.2M参数规模下的预测性能与同规模GPT基线相当。
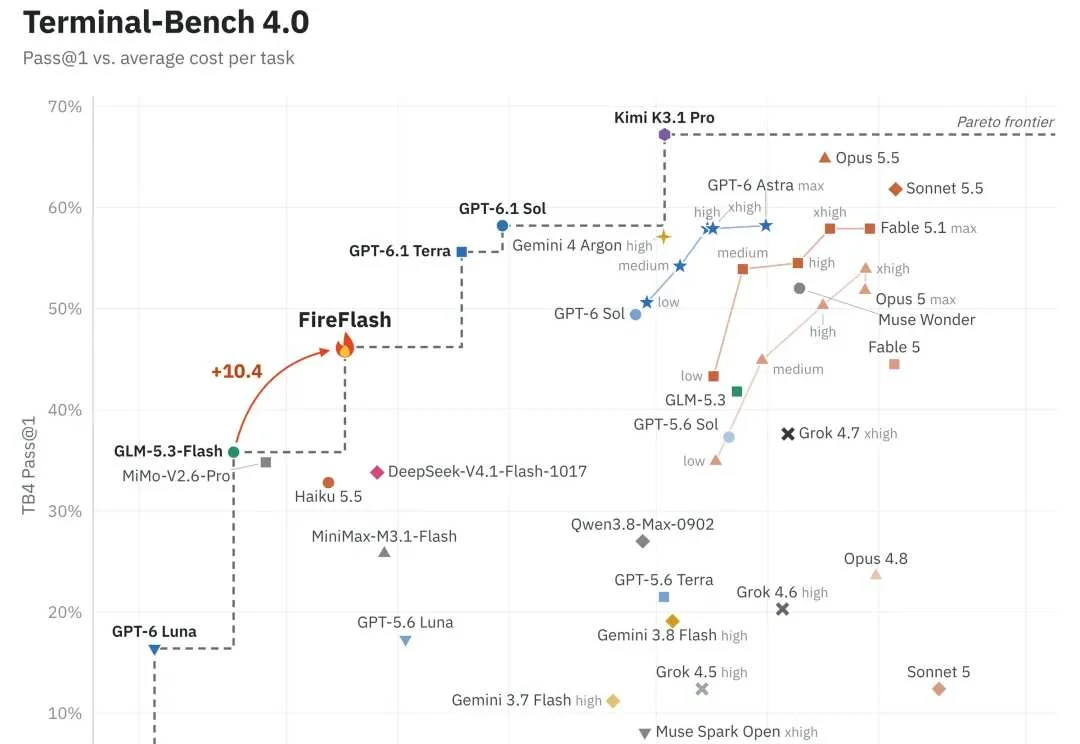
长程智能体(long-horizon agents)正从「修一个 bug」走向连续数小时的终端与编程工作,但它的强化学习训练也格外昂贵:前沿实验室可以在数千张 GPU 上扩展 RL,而对多数团队来说,一条训练样本往往就是一次长达 3 小时、上百轮工具调用的完整尝试,任何一个环节出错,浪费的都是成小时的 GPU 时间。