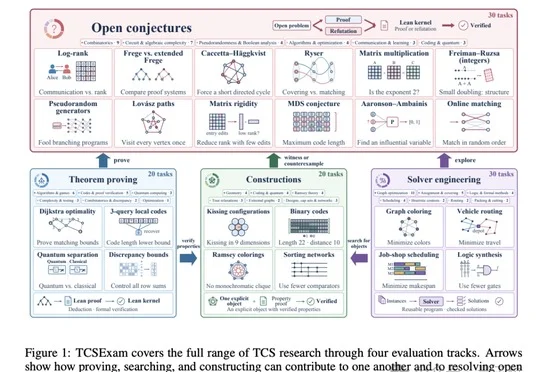
姚期智杨植麟首次联手发论文!30道数学世界难题无一AI独立攻破
姚期智杨植麟首次联手发论文!30道数学世界难题无一AI独立攻破姚期智、杨植麟等发表论文并开源TCSExam基准,GPT-6 Astra以71.9分居首、Kimi K3.1 Pro得57.4分,所测模型均未独立攻破30道开放猜想,但部分数学结果刷新了既有边界。
来自主题: AI技术研报
7358 点击 2026-11-14 12:46

 搜索
姚期智、杨植麟等发表论文并开源TCSExam基准,GPT-6 Astra以71.9分居首、Kimi K3.1 Pro得57.4分,所测模型均未独立攻破30道开放猜想,但部分数学结果刷新了既有边界。
月之暗面(Moonshot AI)创始人杨植麟联合清华大学及图灵奖得主姚期智团队推出TCSExam,以机器核验的科研交付物评测大模型,GPT‑6 Astra居Full榜首,开放猜想有效解答仍依赖联网检索改编。
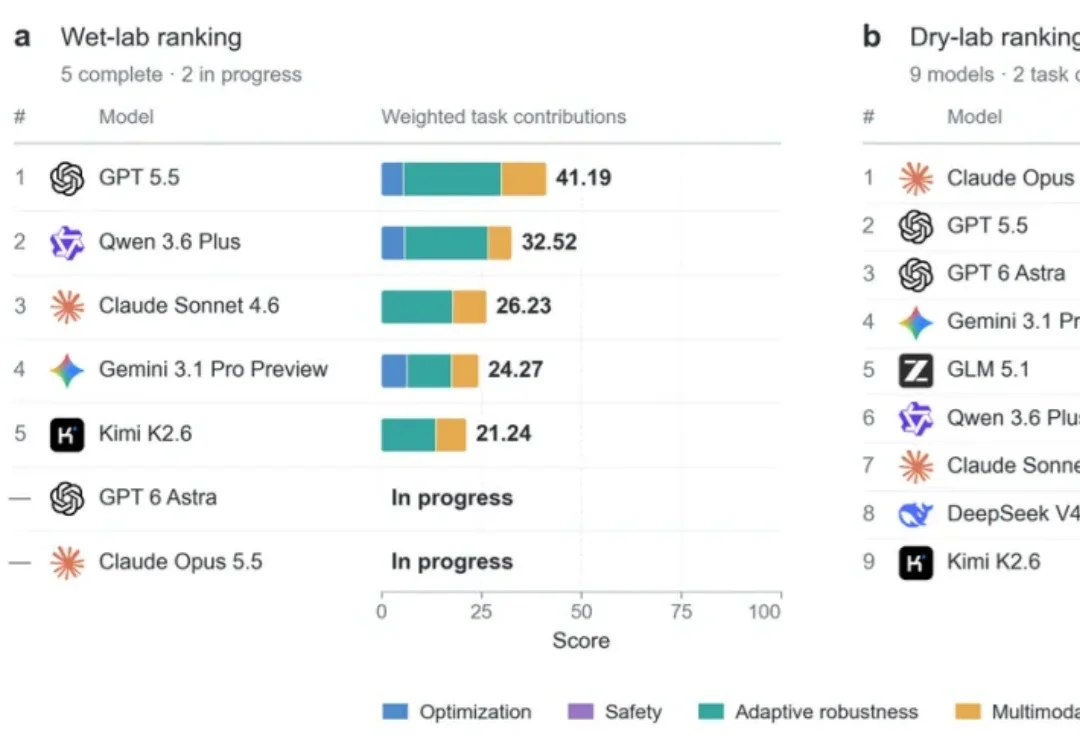
前段时间,Anthropic 展示了一项 AI for Science 研究成果:Claude 在 64 小时内生成了 31.8 万个蛋白质设计方案,经过筛选,211 个被送入湿实验室测试,最终有 17 个达到预设的蛋白结合标准,展示了 AI 科学设计走向真实实验验证的巨大潜力。但 Anthropic 也指出,从结合命中到真正可用的抗毒疗法,仍面临复杂的活性验证与成药性考验等一系列考验。
马斯克将Anthropic的Claude Cowork核心设计者Jenny Wen招入SpaceXAI,她已加入Cursor担任设计负责人,并将把产品与交互设计经验用于Grok Bot。
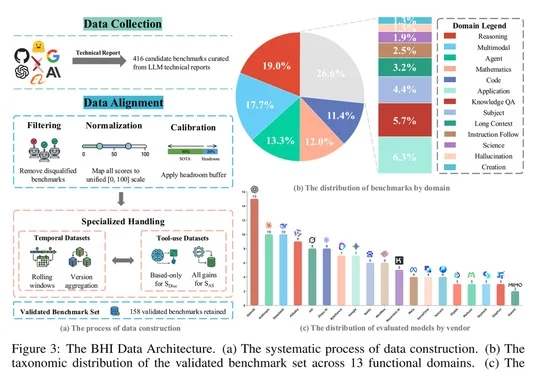
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
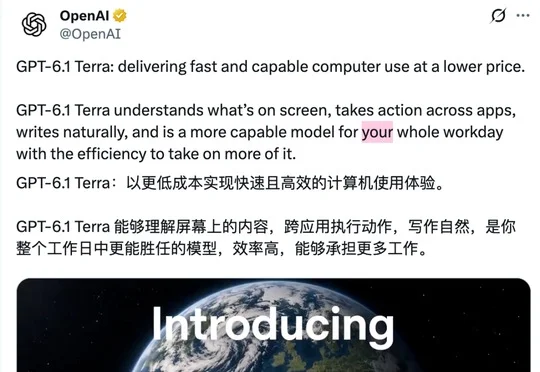
OpenAI发布GPT-6.1 Terra,每百万token输入1美元、输出5美元,较上代大幅降价,并强化视觉理解、写作和电脑操作;Agents’ Last Exam中追平GPT-6 Astra且速度快3倍以上,第三方评测幻觉率由88%降至38%,现已全面开放。
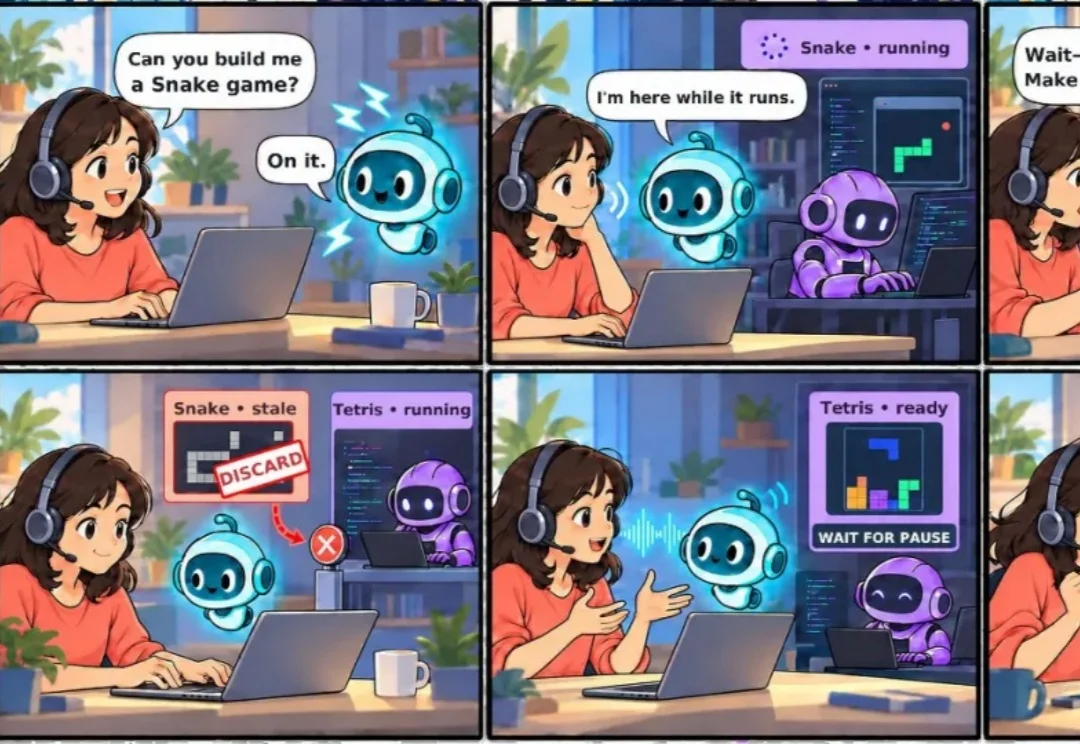
语音是人类最自然、最习惯的交互方式。随着代码智能体、办公智能体逐渐普及,人们对智能体的期待也不再只是 “问一个问题、得到一个答案”,而是希望像和同事一样持续沟通,共同完成一项工作:任务进行到一半,可以随时询问进展;想到新要求,可以直接补充;方向变了,也可以马上取消或修改。
近期,六角未来沿着 Physical Coding 的思路,进一步构建了 HexaShell-Preview。根据官方评测结果,在 RoboDojo 全部 42 项任务上,HexaShell-Preview 取得了 46.9% 的成功率、53.2 的进度得分,成功率高出第二名 7.5 个百分点,领跑 RoboDojo-Agent 榜单。
Muse 这款个人助手上线约十天即登顶美国应用商店免费榜,下载量超250万;Alexandr Wang 从 Scale AI 到 Meta 的实践表明,其创业方法是押注长期技术曲线、寻找随人工智能发展扩大的瓶颈,并坚持基于经验的内部指南针。
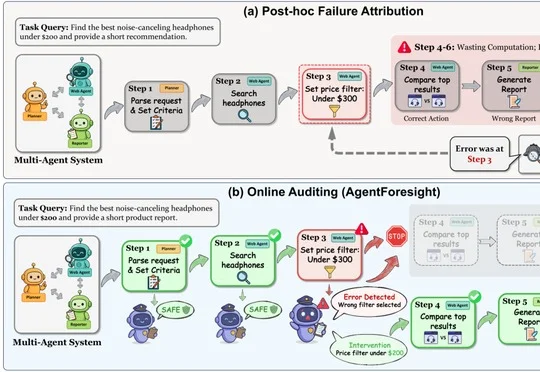
研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。