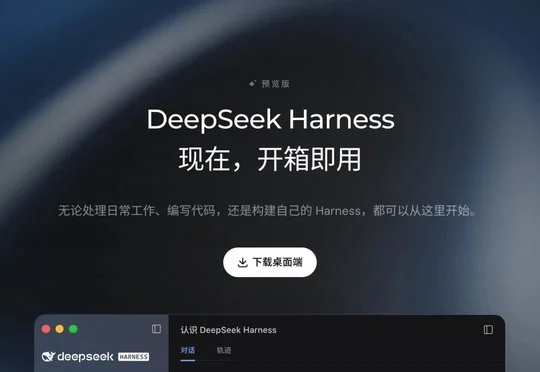
DeepSeek Harness 桌面端发布:一手体验
DeepSeek Harness 桌面端发布:一手体验DeepSeek Harness桌面端正式发布,支持Windows和Mac,提供本地工作区、预置办公与开发工具及Cordis插件内核,可通过插件页面管理扩展并使用自动化任务、智能体团队等实验功能,团队计划改进沙箱安全、长期记忆、浏览器自动化等方向,并公开了训练用DSec沙盒基础设施。
来自主题: AI资讯
8800 点击 2026-09-29 22:02

 搜索
DeepSeek Harness桌面端正式发布,支持Windows和Mac,提供本地工作区、预置办公与开发工具及Cordis插件内核,可通过插件页面管理扩展并使用自动化任务、智能体团队等实验功能,团队计划改进沙箱安全、长期记忆、浏览器自动化等方向,并公开了训练用DSec沙盒基础设施。
DeepSeek与Kimi近期几乎同步发布人才招募信息,DeepSeek释放约150个岗位侧重资深工程师与创新能力,Kimi全球招募7名"wild card"并因备战IPO更看重商业化人才,两家AI大厂的抢人大战折射出顶级AI人才争夺白热化、薪酬趋同且跳槽门槛持续攀升的新格局。
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。
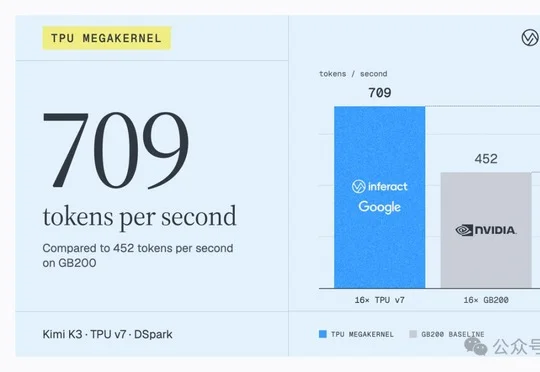
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。
开源智能体项目Orbital主张"Context is yours",通过将散乱会话和记忆总结为可迁移的项目记忆,帮助用户拿回被大厂Agent锁死的上下文资产,并配合观猹推出的Tokendance模型钱包,实现DeepSeek、GLM、Kimi等70多个模型用量的透明化管理。
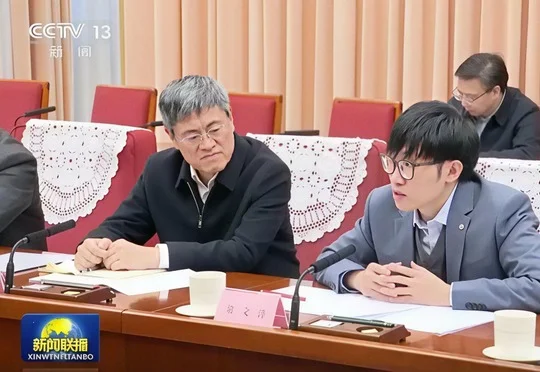
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
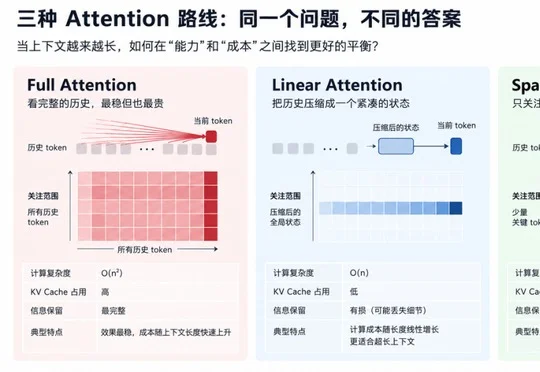
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
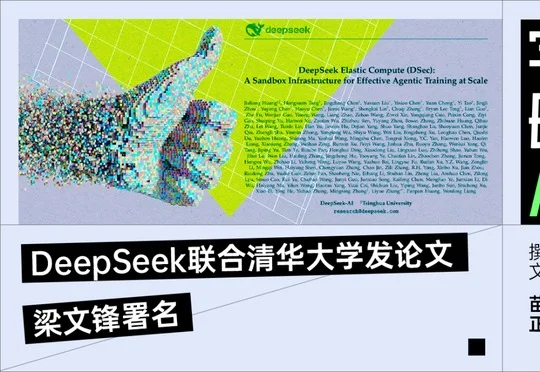
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。