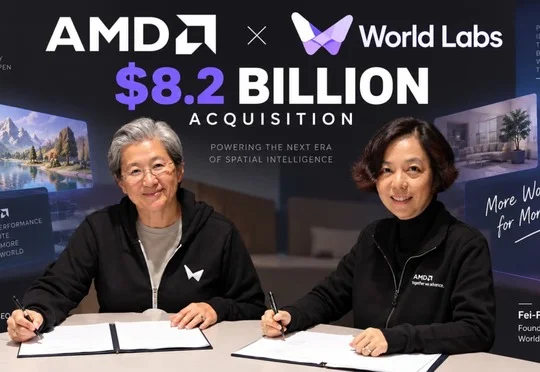
豪掷82亿美元,芯片巨头押注的世界模型究竟是什么|深度观察
豪掷82亿美元,芯片巨头押注的世界模型究竟是什么|深度观察AMD以82亿美元全股票收购世界模型公司World Labs,文章解析世界模型从生成内容迈向生成可交互数字世界的技术路径与产业影响,梳理李飞飞的空间智能路线、杨立昆的JEPA架构以及谷歌Genie 3、英伟达Cosmos等巨头的不同押注方向。
来自主题: AI资讯
9423 点击 2026-10-01 13:21

 搜索
AMD以82亿美元全股票收购世界模型公司World Labs,文章解析世界模型从生成内容迈向生成可交互数字世界的技术路径与产业影响,梳理李飞飞的空间智能路线、杨立昆的JEPA架构以及谷歌Genie 3、英伟达Cosmos等巨头的不同押注方向。
北京AI基础设施公司九章云极向港交所递交上市申请,2025年收入同比增长177.7%达10.98亿元,累计交付超31000 PFLOPS算力,正推进Token工厂战略。
EMNLP 2026录用论文提出Claim-Locked Reporting方法,针对AI审稿等场景中数字正确但方向或结论强度被改写的统计主张失真问题,通过先锁定证据支撑的主张、再由代码固定数字与方向而模型仅负责衔接,在fMRI与临床试验报告上将跨次生成数值复现率分别提升至98.5%和100%,并消除了方向反转错误。
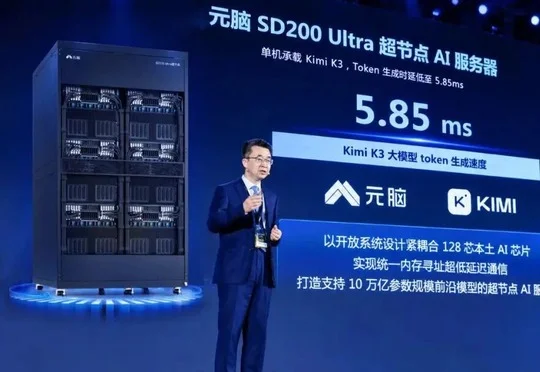
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
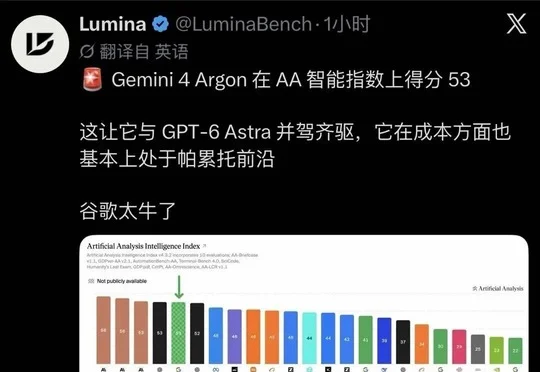
谷歌正式发布前沿AI模型Gemini 4 Argon,其在Text Arena排名第一、Vals RSI指数超越GPT-6 Astra达30%,单任务成本仅1.99美元,单次输出上限升至100万Token,并在谷歌内部以Rust安全语言重写了80万行系统内核代码。
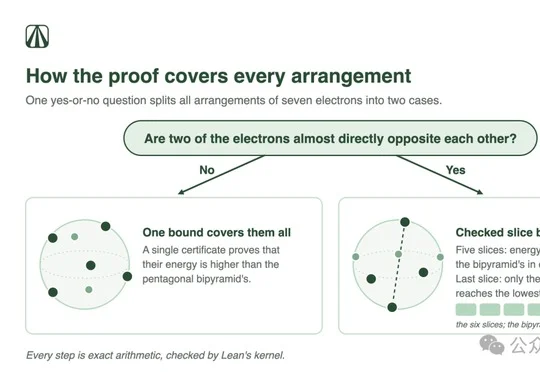
10个Claude Sonnet 5.5智能体通宵15小时、互发1270条消息并写出17895行Lean代码,在无人类介入的情况下完成悬置122年的汤姆逊问题N=7形式化证明,且通过Lean内核与nanoda双重验证。
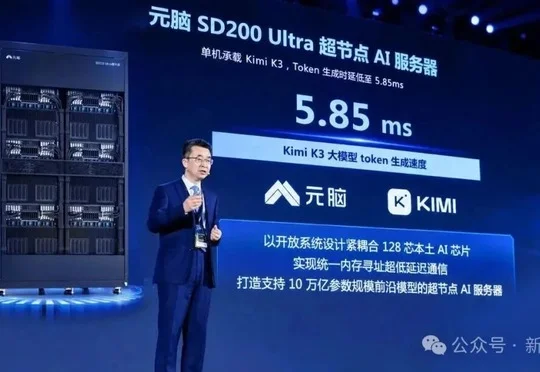
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
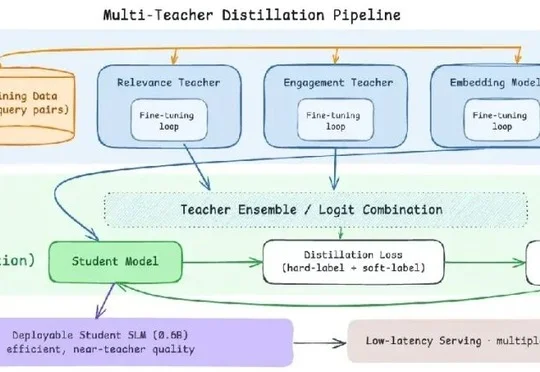
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
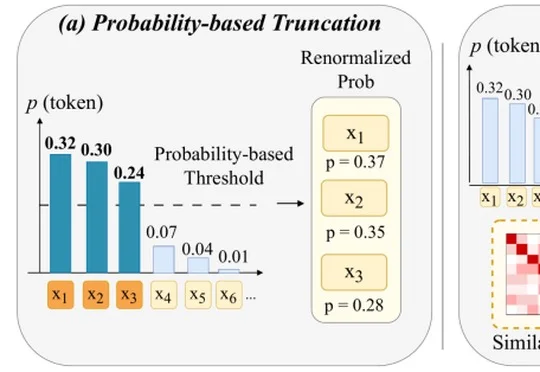
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
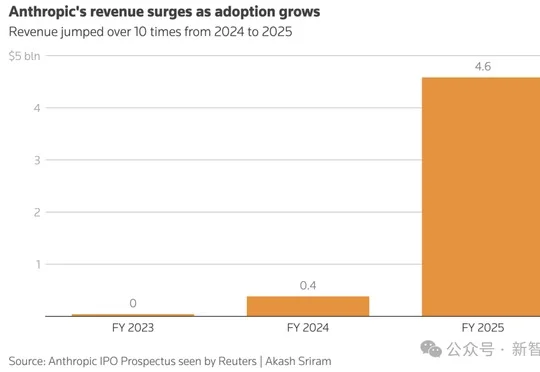
Anthropic招股书披露,其背负未来5180亿美元算力与基建长期支出承诺,2025年营收近46亿美元却净亏约420亿美元,公司正冲击或超2万亿美元的IPO估值,但客户集中度高且订单缺乏长期合同保障,能否撑住天价估值取决于收入增长能否持续跑赢算力成本。