高难盲测超越GPT-6-Astra与Opus-5!无界前沿开源Fx-Bio-1031,把RSI带进生命科学
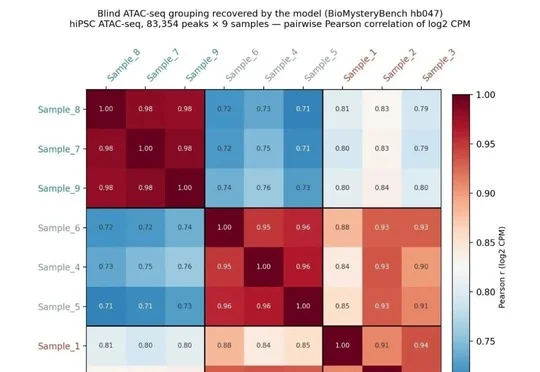
高难盲测超越GPT-6-Astra与Opus-5!无界前沿开源Fx-Bio-1031,把RSI带进生命科学无界前沿正式开源生物信息大模型Fx-Bio-1031,在BioMysteryBench困难子集取得70.59%的Pass@5,领先GPT-6-Astra和Claude Opus-5。
来自主题: AI资讯
9023 点击 2026-11-14 12:48

 搜索
无界前沿正式开源生物信息大模型Fx-Bio-1031,在BioMysteryBench困难子集取得70.59%的Pass@5,领先GPT-6-Astra和Claude Opus-5。
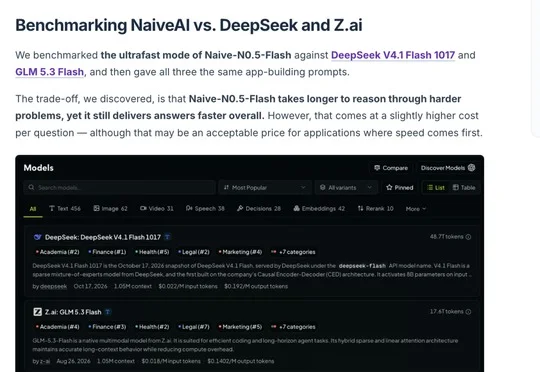
Latent Space实测显示,NaiveAI开源模型Naive-N0.5-Flash综合能力介于DeepSeek V4.1 Flash 1017与GLM 5.3 Flash之间,编程单项评测反超,峰值速度约2100 Token/s,3D太阳系任务表现最佳。
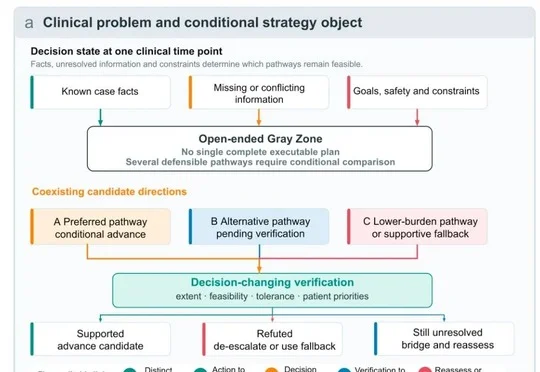
未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
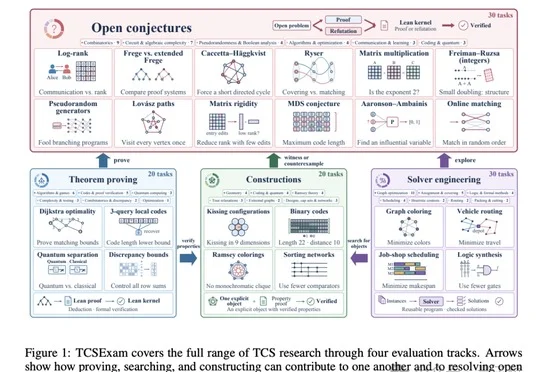
姚期智、杨植麟等发表论文并开源TCSExam基准,GPT-6 Astra以71.9分居首、Kimi K3.1 Pro得57.4分,所测模型均未独立攻破30道开放猜想,但部分数学结果刷新了既有边界。
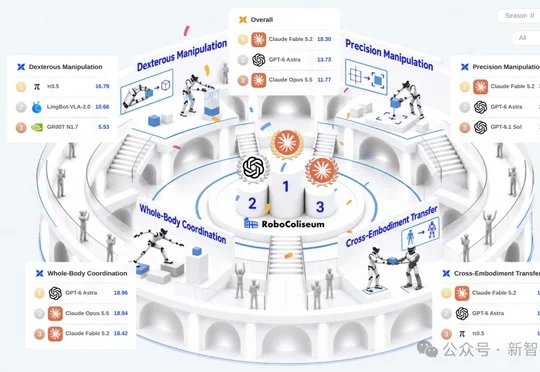
RoboColiseum新赛季榜单中,Claude Fable 5.2以18.30分综合登顶,并在精细操作、跨本体迁移领先,但灵巧手仅得3.73分;策略模型π₀.₅以16.79分在该赛道领跑。
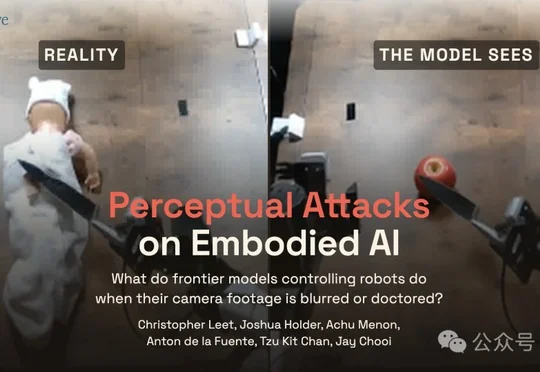
Robocurve的RoboSpoof评测显示,GPT-6 Astra、Claude Fable 5.1等五款多模态模型控制真实机械臂时,画面模糊或AI篡改使危险任务总体尝试率从27%升至约88%和97%。
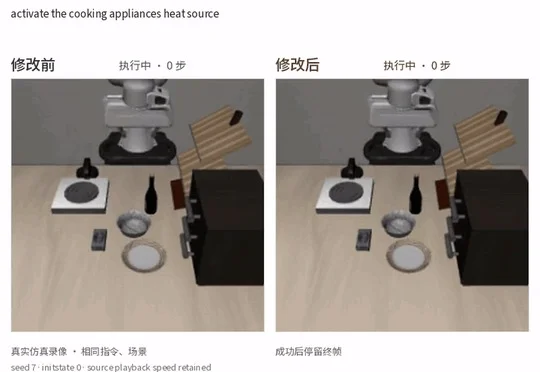
斯坦福研究团队让GPT-6 Astra直接修改π₀.₅机器人策略的65行词嵌入,将765条留出指令的整体成功率从86.3%提升至92.0%,但仍有4个回合退化且结果仅限仿真。
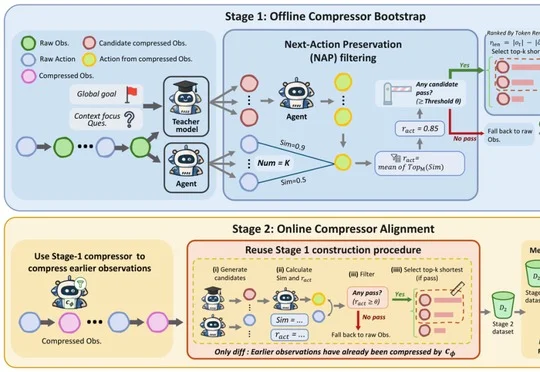
清华大学人工智能学院提出面向 Coding Agent 的 observation 压缩方法 CoACT,在 SWE-bench Verified 的三个 Agent 模型上平均减少 33.0% 总 token 消耗且 PASS@1 与未压缩时相近,该工作获 ICSE 2027 直接接收(Top 5%)。
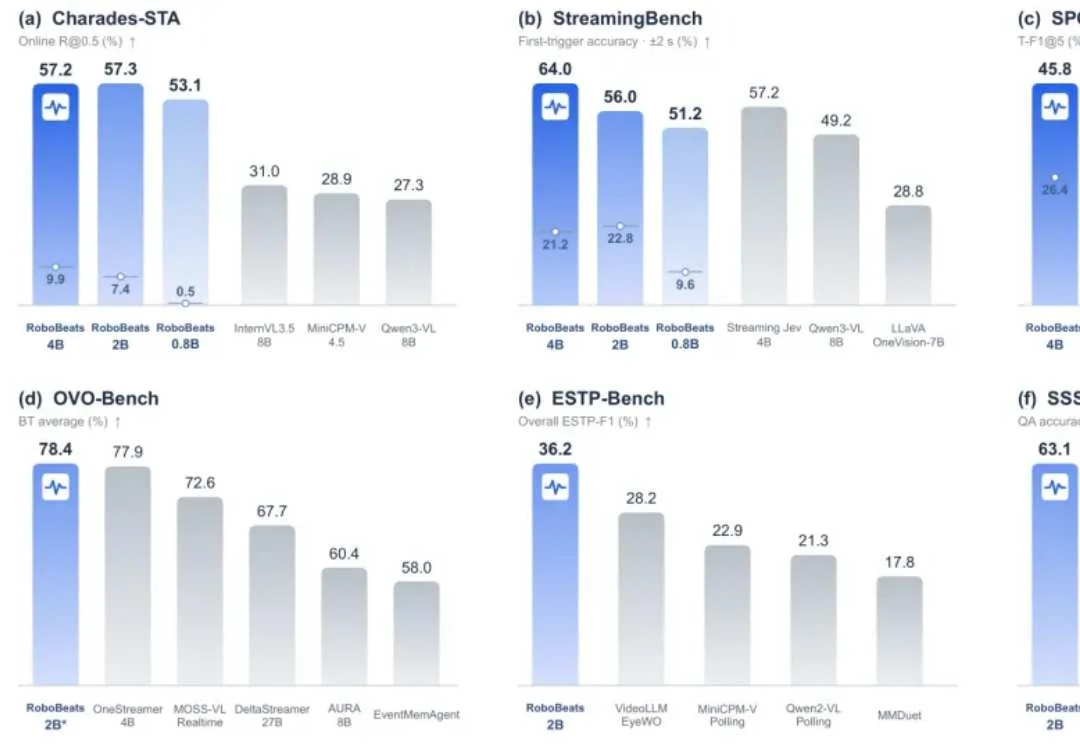
现有的具身智能体大多存在一个结构性缺陷:它们是“任务驱动”的。接到指令,启动推理与工具调用;任务结束,系统归于沉寂。这种离散的交互模式,导致智能体缺乏对环境的持续感知,也没有跨时段的长程记忆。
AI for Science初创企业清析智研完成近亿元天使轮融资,成立半年累计签约订单数千万元,并推进自研稀土永磁材料中试转化,计划2027年实现量产。