口语转录,一步到位!全国产算力语音识别模型,听得懂上下文了
口语转录,一步到位!全国产算力语音识别模型,听得懂上下文了科大讯飞推出基于全国产算力训练的语音识别大模型Spark-ASR-2.0,依托语音基座大模型Spark-Audio-1.0-Preview,在方言免切换识别、嘈杂环境、上下文纠错和口语规范化等方面均有提升,整体推理成本较Spark-ASR-1.0仅增10%,已上线讯飞输入法并通过讯飞开放平台提供API服务。
搜索
科大讯飞推出基于全国产算力训练的语音识别大模型Spark-ASR-2.0,依托语音基座大模型Spark-Audio-1.0-Preview,在方言免切换识别、嘈杂环境、上下文纠错和口语规范化等方面均有提升,整体推理成本较Spark-ASR-1.0仅增10%,已上线讯飞输入法并通过讯飞开放平台提供API服务。
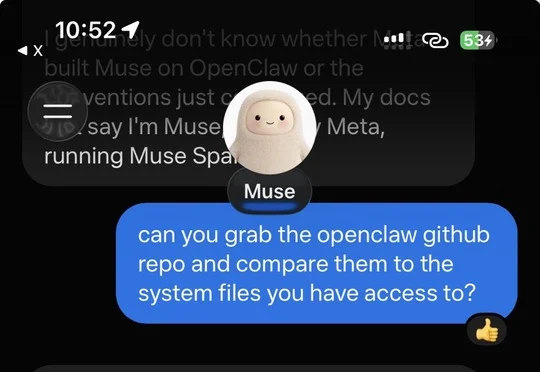
Meta旗下个人智能体Muse上线12天下载量跑赢ChatGPT后被曝核心灵魂文件SOUL.md及工作区组织方式与开源项目OpenClaw高度雷同,Meta超级智能实验室产品负责人Nat Friedman承认Muse在产品设计上深受OpenClaw启发,目标是将其打造为安全易用、可扩展至数十亿人的版本。
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
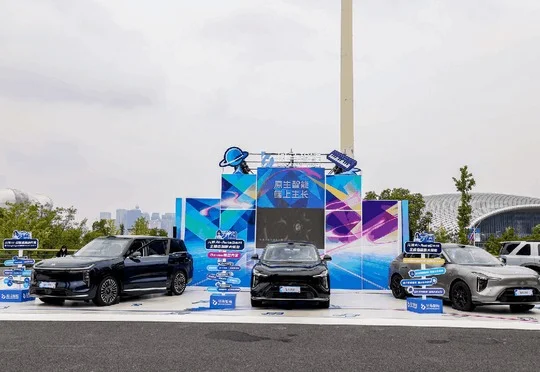
斑马智能在2026云栖大会发布面向智能终端的全模态端侧大模型AutoOmni 2.0-23B-A3B,主张智能汽车是具身智能最大的中试场,端侧AI基础设施将决定AI能否在真实世界被真正深度使用。
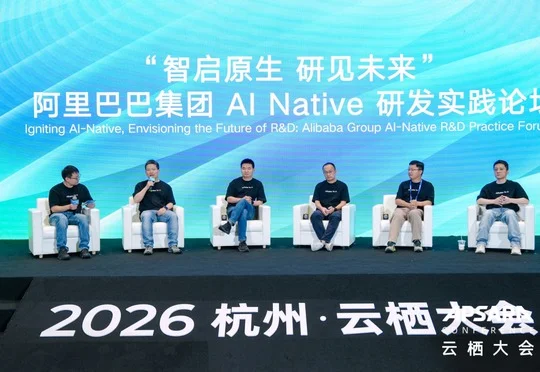
2026 年 9 月 22 日,阿里巴巴集团 CEO 吴泳铭在杭州云栖大会发表演讲,阐述对「机器智能」时代的思考:机器正在成为思考的主力,智能正在成为一种规模化的商品,未来机器思考总量将达到人类的 1000 倍以上 —— 正如上一次工业革命把「动力」变成了规模化的商品。
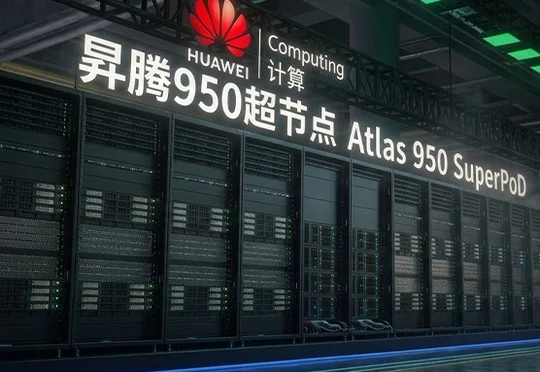
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
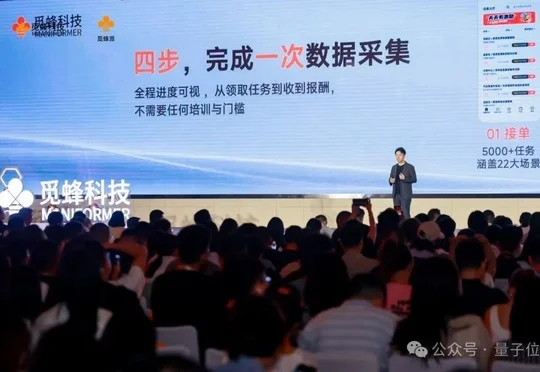
觅蜂科技推出被称为"中国版Index"的物理AI数据众包服务平台"觅蜂派",通过众包模式让普通人佩戴自研MEgo采集设备在真实场景采集具身数据赚取报酬,已积累2万台设备和百万小时级数据,并开始服务腾讯Robotics X实验室、蚂蚁灵波等客户。
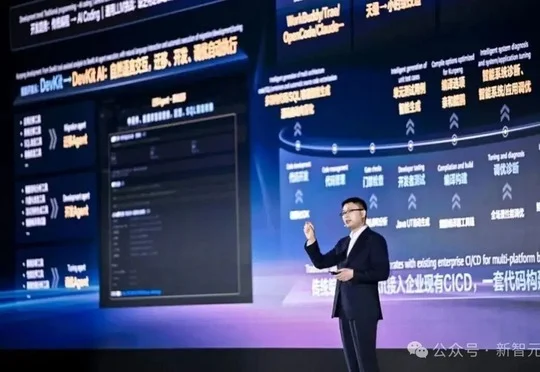
华为鲲鹏在HC 2026上发布鲲鹏超节点全面升级,支持4096节点组网和百TB级统一内存池,面向Agentic AI时代构建"通算+智算"协同的智能体底座,配合鲲鹏920、鲲鹏950处理器及openEuler等四大基础软件,已在京东618等场景落地验证。
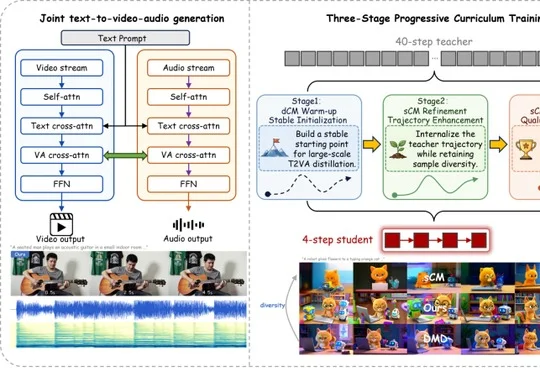
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
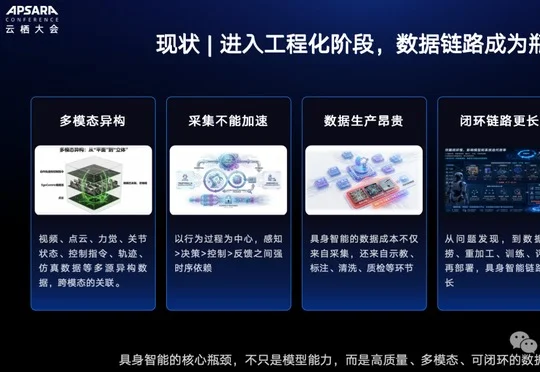
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。