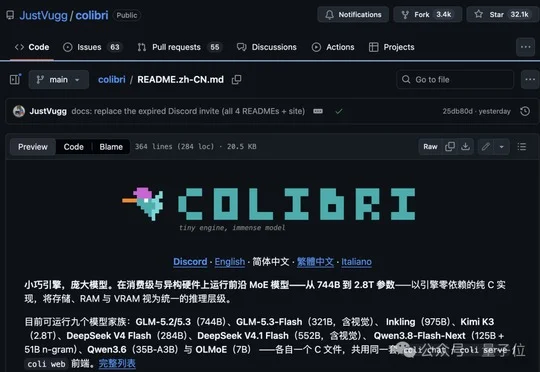
笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHub
笔记本跑7000亿参数GLM!无GPU也行? SSD当显存用火爆GitHubGitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
来自主题: AI资讯
9925 点击 2026-09-26 15:01

 搜索
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
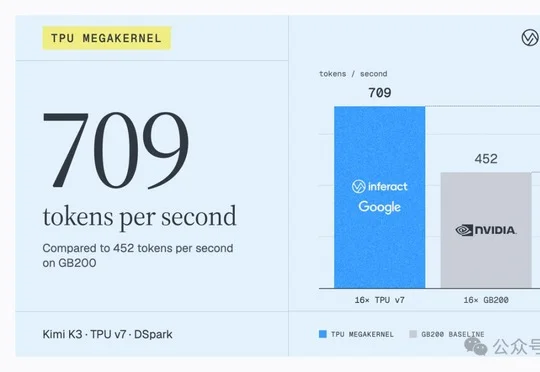
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
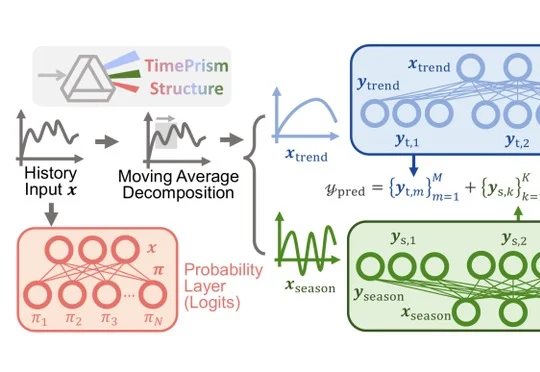
Jev刷屏之际,香港中文大学徐强团队早在12个月前就发表了论文《From Samples to Scenarios》并提出TimePrism验证模型,两者在不同领域分别走向了"显式概率、并行输出、面向决策"的相似设计思路。
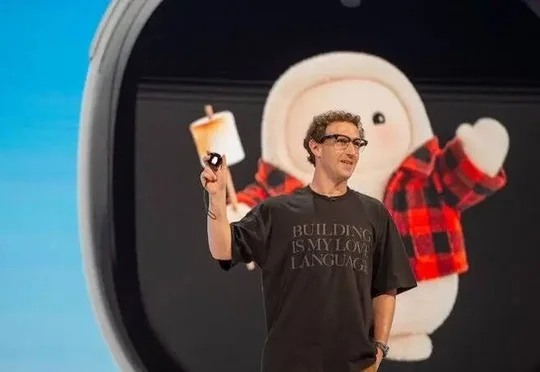
Meta的个人智能体产品Muse上线12天下载量超越ChatGPT,掀起Personal Agent热潮,但受中美生态差异及算力成本等制约,字节、阿里、腾讯等国内大厂难以直接复制其成功路径。
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
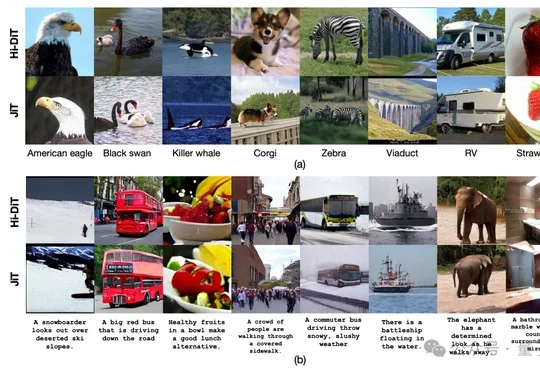
中科大与智象HiDream.ai团队提出Hi-DiT,采用时间门控机制在共享Transformer中分阶段协调Latent与Pixel双流以兼顾生成效率与细节保留,在ImageNet 256×256上达到1.06 FID,论文已被ECCV 2026接收。
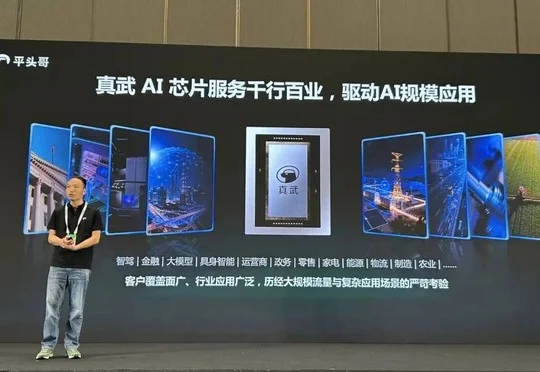
henry 发自 凹非寺 量子位 | 公众号 QbitAI “这是目前中国算力性能最强的AI芯片,性能达到M890的3倍。” 9月22日的云栖大会上,阿里巴巴集团CEO吴泳铭这样介绍新一代真武V900
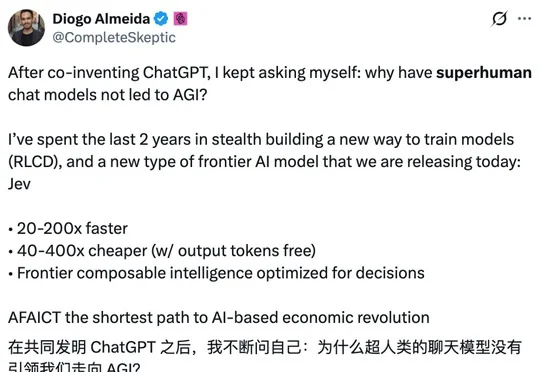
AI模型Jev开发商TypeSafe AI在9天内估值从2亿美元暴涨50倍至100亿美元以上,正洽谈逾10亿美元融资,Jev作为专为软件和Agent提供快速低成本判断的"System One模型"凭借Vercel等平台的快速采用获得投资人追捧。
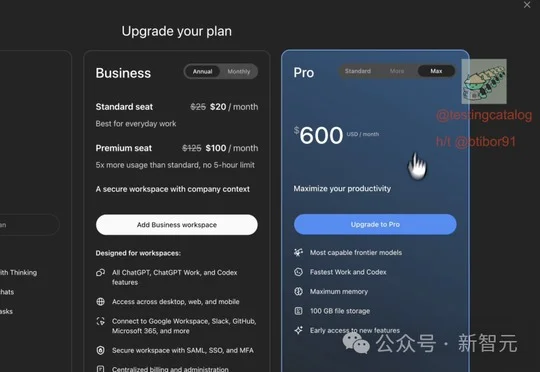
OpenAI被传正在筹备月费高达500美元的ChatGPT Pro Max订阅套餐,核心卖点为"最快的Work与Codex",涨价诱因是GPT-6 Astra上线后算力告罄导致OpenAI叫停了200美元Pro档新订阅,该套餐最早可能在下周DevDay上正式公布。
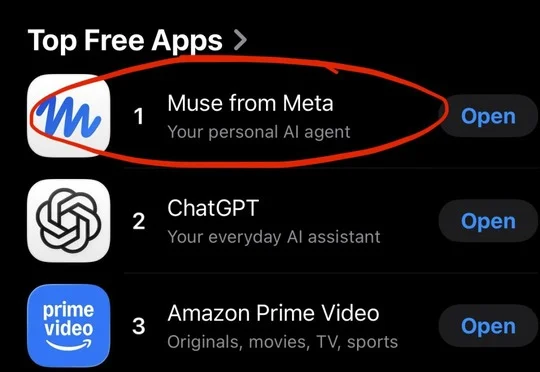
Meta在Connect大会上发布由前苹果界面设计主管、液态玻璃缔造者Alan Dye操刀的掌上AI设备Muse Charm,内置2英寸触摸屏和5G调制解调器,可让AI助手Muse脱离手机独立运行,计划于今年12月假日购物季发售。