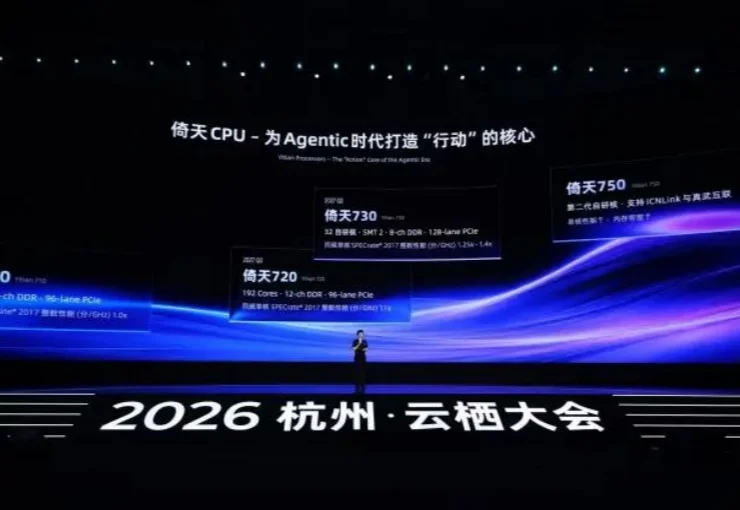
从单卡到千卡互联,平头哥真武 V900 背后的 AI 算力变局
从单卡到千卡互联,平头哥真武 V900 背后的 AI 算力变局从真武 V900 到新一代磐久超节点服务器,平头哥八年来陆续布局的 AI 芯片、CPU、scale up 互联、scale out 网络和存储芯片,开始被装进同一套算力系统。
来自主题: AI资讯
8999 点击 2026-09-23 09:56

 搜索
从真武 V900 到新一代磐久超节点服务器,平头哥八年来陆续布局的 AI 芯片、CPU、scale up 互联、scale out 网络和存储芯片,开始被装进同一套算力系统。
在华为2026年全联接大会上,华为发布"灵衢"统一互联总线协议及昇腾960超节点、OceanStor M900 AI记忆存储等AI基础设施新品,使10万卡集群模型浮点算力利用率从20%提升至35%,并支持单集群100万颗AI处理器。
华为今年全联接大会,最重磅的首先是一组芯片时间表。昇腾960DT研发进度比原计划提前三个季度,单芯片算力实现倍增,960DT支持2 PFLOPS FP8、4 PFLOPS FP4,HBM容量最高288GB、带宽9.6TB/s。
YC 2026 夏季批次的 236 家公司中,91% 与 AI 相关,创业重心从应用层向算力、芯片、训练环境和物理世界显著下沉,Agent 已淡出主叙事,取而代之的是算力建设、推理成本优化、AI 原生服务公司和实体硬件的爆发式增长。
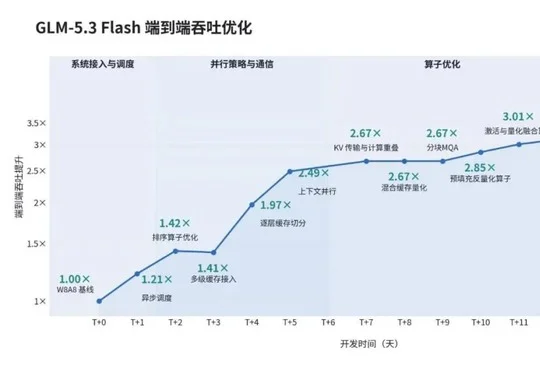
智谱上线 GLM-5.3-FlashX 模型,推理速度最高达 200 tokens/s,较 GLM-5.3-Flash 提速 5 倍、提价 2.5 倍,API 同步开放,该模型在 10 万张国产芯片提供的推理算力基础上,由 GLM-5.3 驱动 Agent 在两周内完成端到端构建并通过 Infra 侧优化将吞吐提升至初始基线的 3 倍。
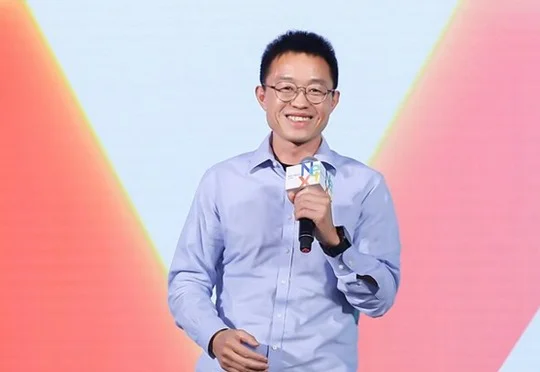
智谱创始人唐杰发文披露RSI最新进展,称由GLM-5.3驱动的Infra Agent在超过10万卡国产芯片集群上不到两周内完成GLM-5.3 Flash生产级推理服务搭建,将端到端吞吐提升至初始基线的3倍,表明RSI最小闭环已经形成但距离递归自我改进仍很遥远。
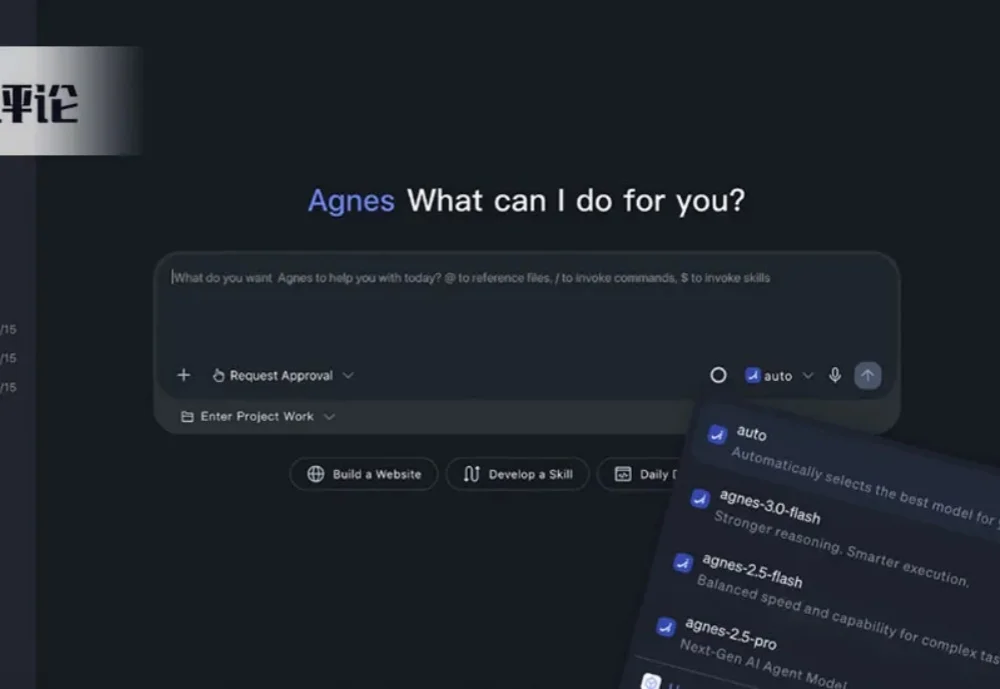
AgnesCode在部分芯片上跑出更高性能,免费模型完成专业级交付。
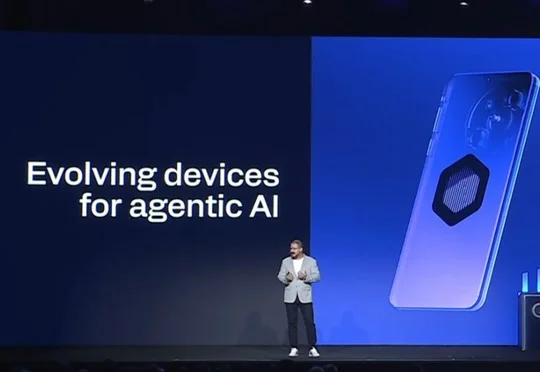
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
寒武纪正式成为PyTorch基金会最高级别白金成员并获得理事会席位,其AI框架高级总监王进加入理事会、PyTorch核心维护者朱靖进入技术咨询委员会,标志着中国AI芯片从框架适配者转变为全球AI开源生态的参与者。
AI算力调度公司Gimlet Labs获3亿美元融资,估值达30亿美元,由Andreessen Horowitz领投,Arm Holdings、微软M12等参投,公司目前专注于将AI工作负载分配至不同类型芯片并帮助客户搭建数据中心。