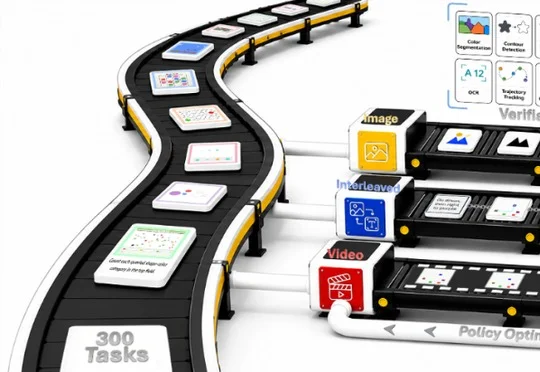
给视频模型建一座「全能训练场」:300项任务、可验证奖励,VBVR-Pro系统探索视觉推理
给视频模型建一座「全能训练场」:300项任务、可验证奖励,VBVR-Pro系统探索视觉推理NTU、CMU、Berkeley等高校联合推出VBVR-Pro视觉推理系统,构建300项任务与100项可验证打分器的训练评测平台,测试30余个多模态模型,并验证其打分器可直接作为强化学习奖励。
来自主题: AI技术研报
7396 点击 2026-09-20 15:08

 搜索
NTU、CMU、Berkeley等高校联合推出VBVR-Pro视觉推理系统,构建300项任务与100项可验证打分器的训练评测平台,测试30余个多模态模型,并验证其打分器可直接作为强化学习奖励。
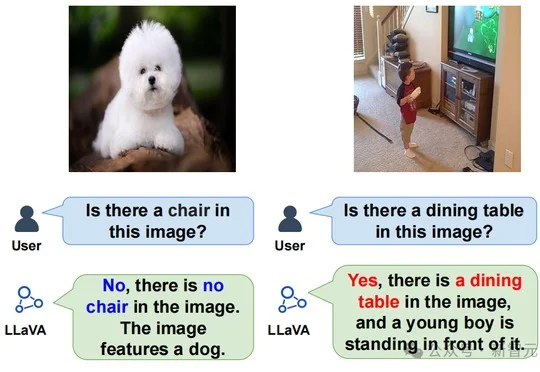
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
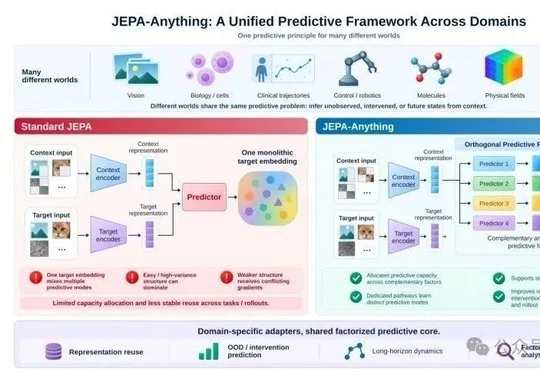
PhAI Labs联合牛津、斯坦福等高校推出跨领域预测框架JEPA-Anything,通过正交预测分解(OPF)机制将预测容量分配到多个互补子空间,并在视觉、生物、临床、控制、分子、物理场和天气七类系统中验证,同时在肝癌研究中从内部因子筛选出可实验验证的候选干预方案,在行星轨道模拟中提取出与开普勒第三定律高度吻合的尺度规律。
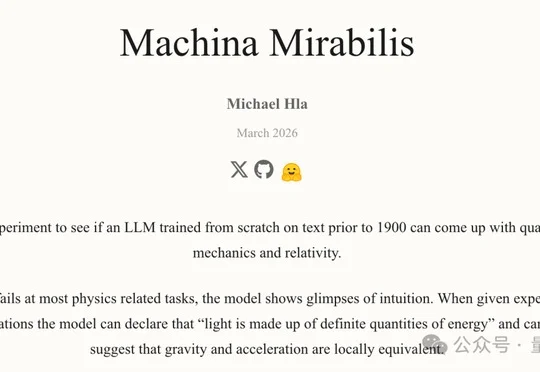
Nature报道独立研究者训练的历史语言模型GPT-1900在仅掌握1900年前知识的条件下,虽在光电效应问题上冒出类似爱因斯坦光量子的表述,但因高度依赖人类整理的提示且训练过程未能完全隔绝现代AI影响,在多数物理任务上表现失败,揭示当前大模型仍缺乏提出全新解释框架的"溯因飞跃"能力,距离真正科学家仍有距离。
研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。
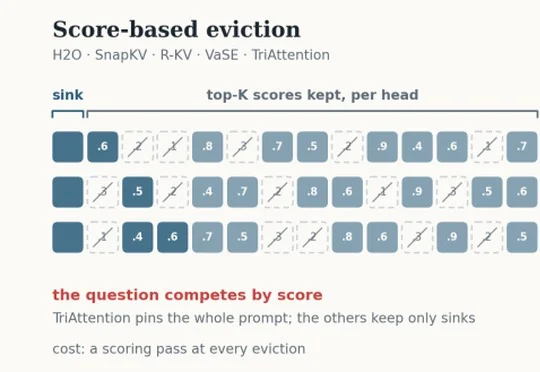
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
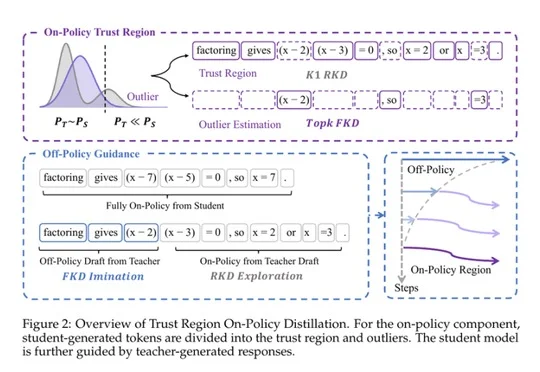
三星大模型团队联合牛津大学、北京大学提出TrOPD方法,通过信任域机制让端侧模型更稳定高效地继承大模型推理能力,在数学、代码、指令遵循、STEM基准上全面超越现有OPD方法,为前沿智能以更低成本走向数亿终端提供新路径。
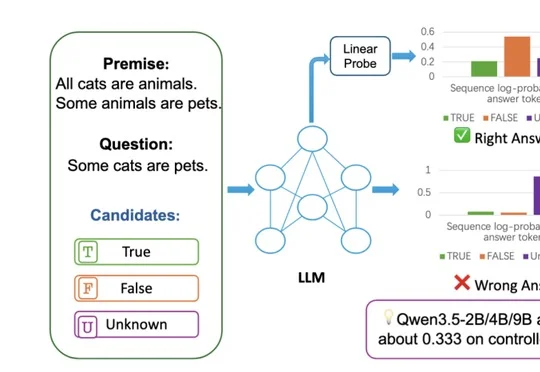
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
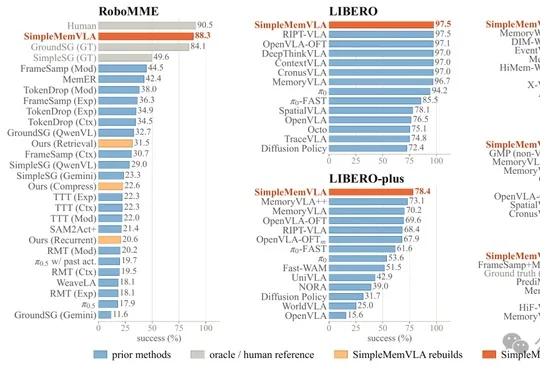
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
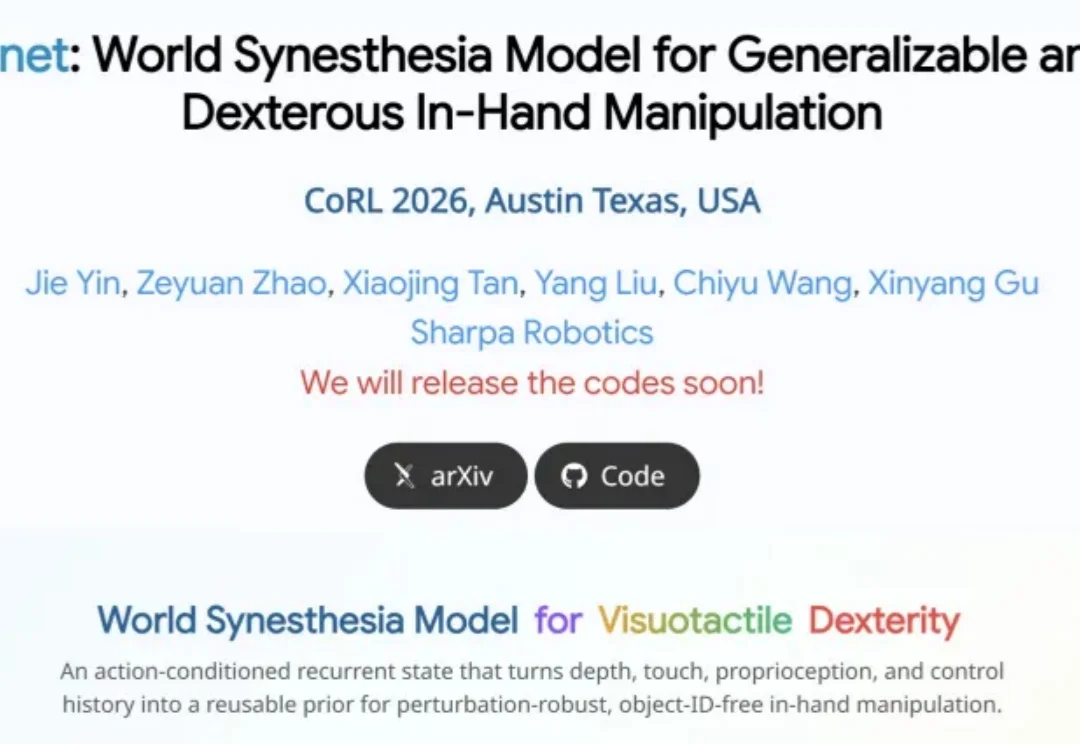
灵巧手从 demo 走向真实应用,关键不只是 “会不会动”,而是能否在 noisy depth、稀疏触觉、外力扰动和未见物体下稳定泛化。现有 in-hand manipulation 往往依赖固定物体、定初始位姿或理想传感器。而一旦遇到真实深度噪声、形状变化和接触状态不可见,这些策略就容易退化成近乎开环的 “手指套路”。