七校联合开源OpenWAM:机器人的「世界模拟器」来了
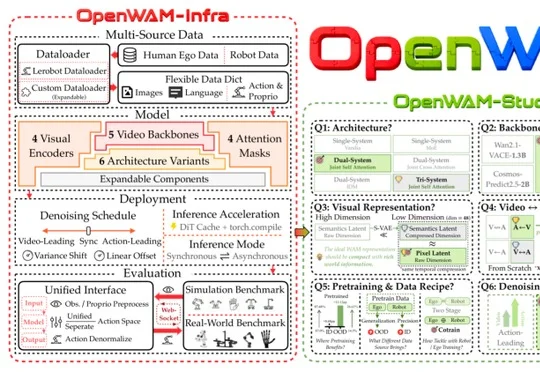
七校联合开源OpenWAM:机器人的「世界模拟器」来了新加坡国立大学、清华大学、北京大学等七所高校联合开源世界动作模型 OpenWAM,由 OpenWAM-Infra 模块化基础设施、OpenWAM-Study 受控实验与 OpenWAM-α 大规模预训练基座模型组成,整合视频生成的世界动态先验与机器人动作学习,在多个仿真基准和真实机器人平台上验证了机器人预测环境变化并执行动作的能力。
搜索
新加坡国立大学、清华大学、北京大学等七所高校联合开源世界动作模型 OpenWAM,由 OpenWAM-Infra 模块化基础设施、OpenWAM-Study 受控实验与 OpenWAM-α 大规模预训练基座模型组成,整合视频生成的世界动态先验与机器人动作学习,在多个仿真基准和真实机器人平台上验证了机器人预测环境变化并执行动作的能力。
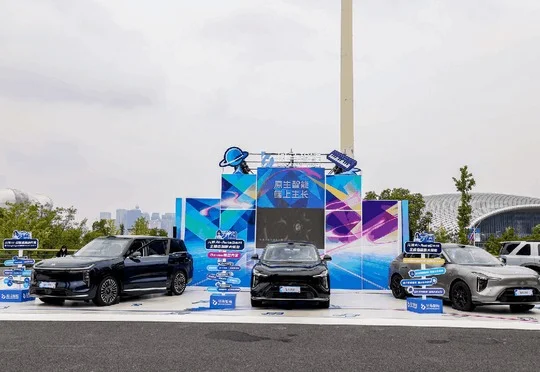
斑马智能在2026云栖大会发布面向智能终端的全模态端侧大模型AutoOmni 2.0-23B-A3B,主张智能汽车是具身智能最大的中试场,端侧AI基础设施将决定AI能否在真实世界被真正深度使用。
实测Anthropic的Opus 5.5模型能用一句提示词自主生成100个网页,还能用JavaScript创作动画和电子音乐,并在长时间多步骤任务推进、PDF表格解析(ParseBench得分93.9%)及写作风格自然度上较Opus 5有明显提升。
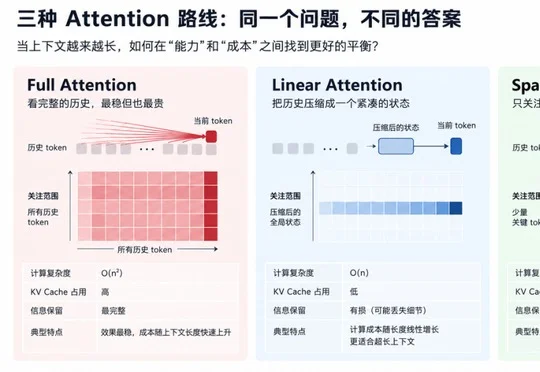
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
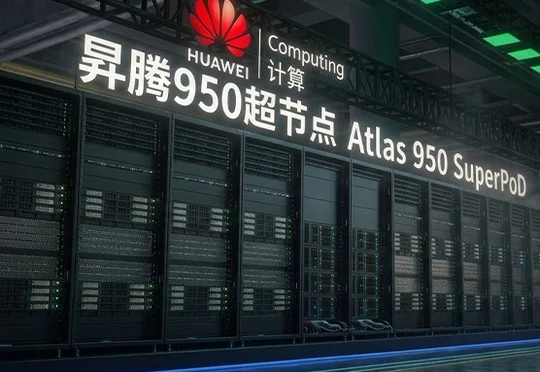
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。
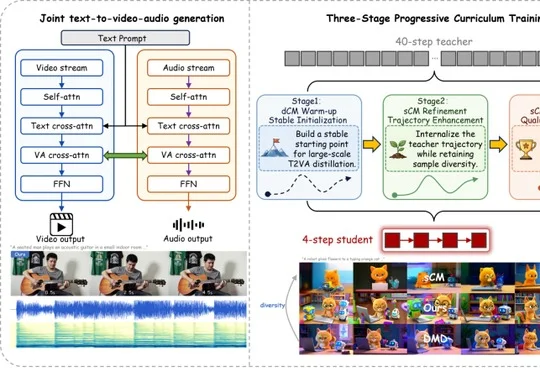
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
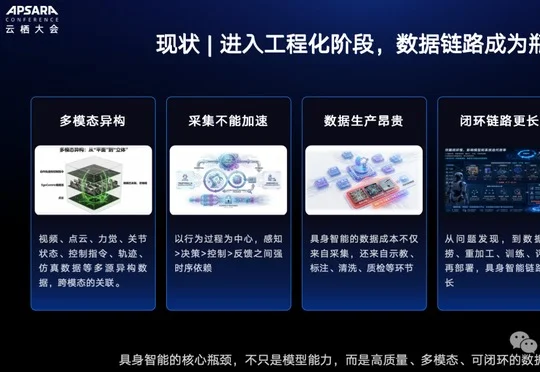
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
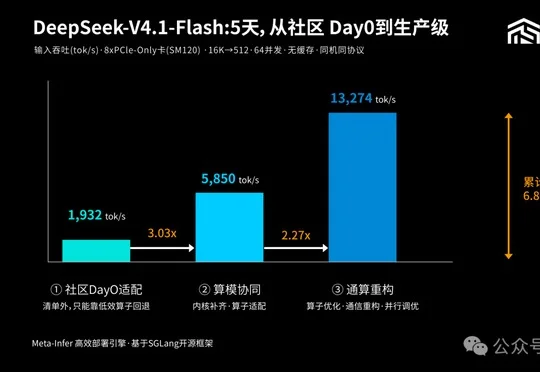
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
爱诗科技(AIsphere)发布的实时世界模型PixVerse R2上线即登上X(Twitter)趋势榜,通过Omni Causal AR与Real-Time Acceleration框架将世界建模能力与实时运行结合,实现用户对AI生成世界的持续操控与互动。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。