OpenAI内部曝光:AI开始自己造AI!奥特曼急发全球暂停令
OpenAI内部曝光:AI开始自己造AI!奥特曼急发全球暂停令就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!
来自主题: AI资讯
9018 点击 2026-09-22 15:16

 搜索
就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!
就在刚刚,马斯克SpaceXAI正式发布,全新主力模型Grok 4.7!
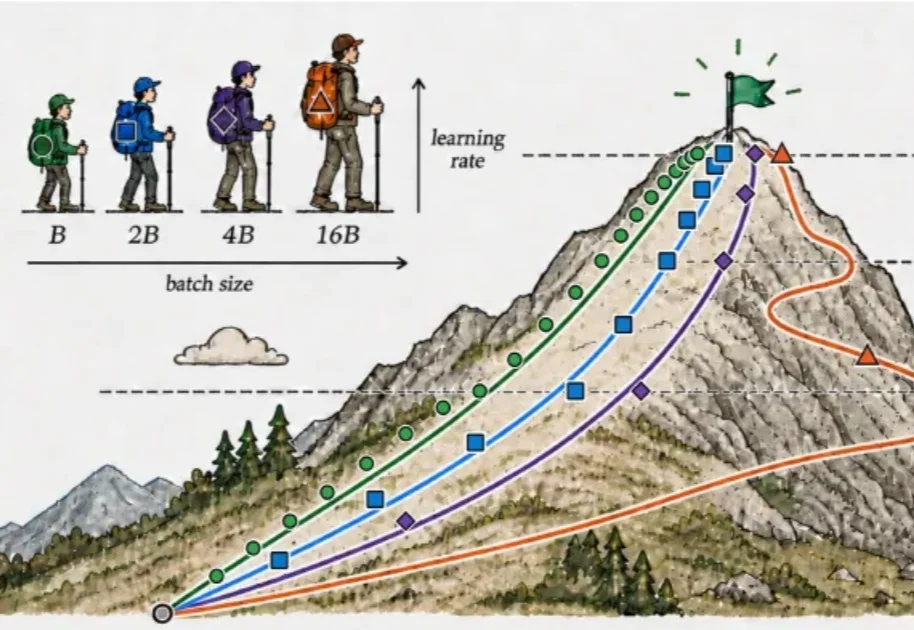
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
时间到了2026年9月,我们基本可以宣布世界模型是一个垃圾概念。
在一道千禧年大奖难题的解答还在接受数学界审视的同时,超过 100 道长期开放问题也已经被内部模型解决。OpenAI 最新公布的信息描绘了这样的局面。
一款能走进真实工作的生图模型。
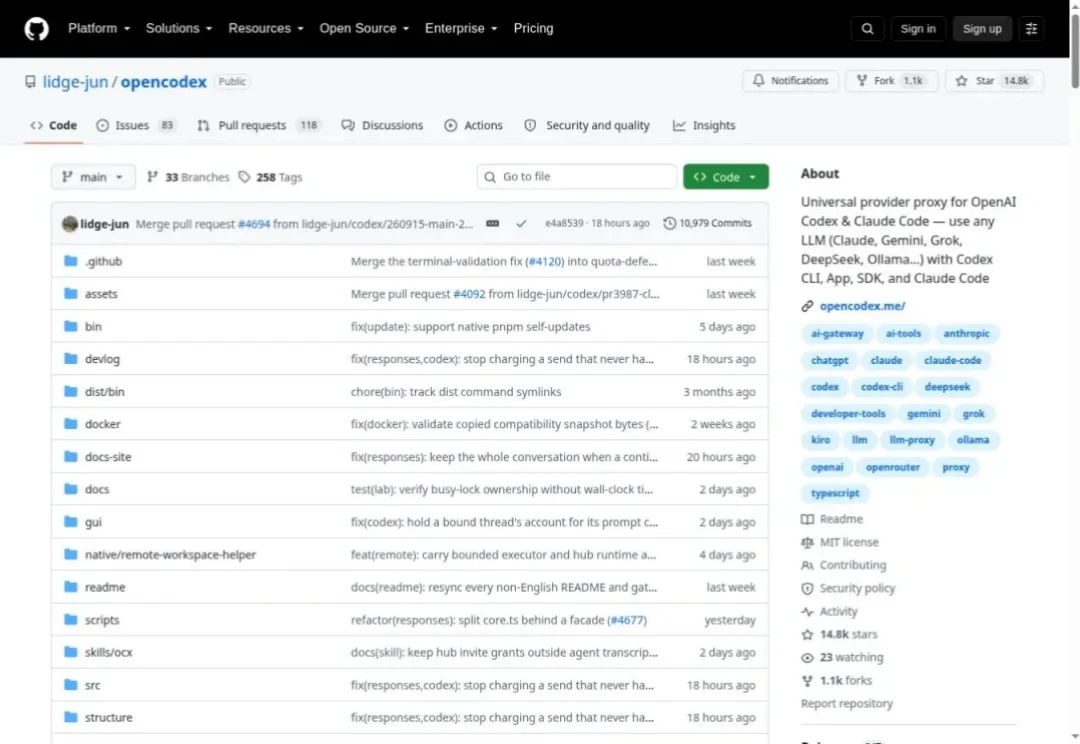
上周发了折腾 WebCodex 的文章《把ChatGPT几乎无限的网页额度当Codex用》,文章下面,就有小伙伴接着问:能不能让不同的模型,去干不同的活?
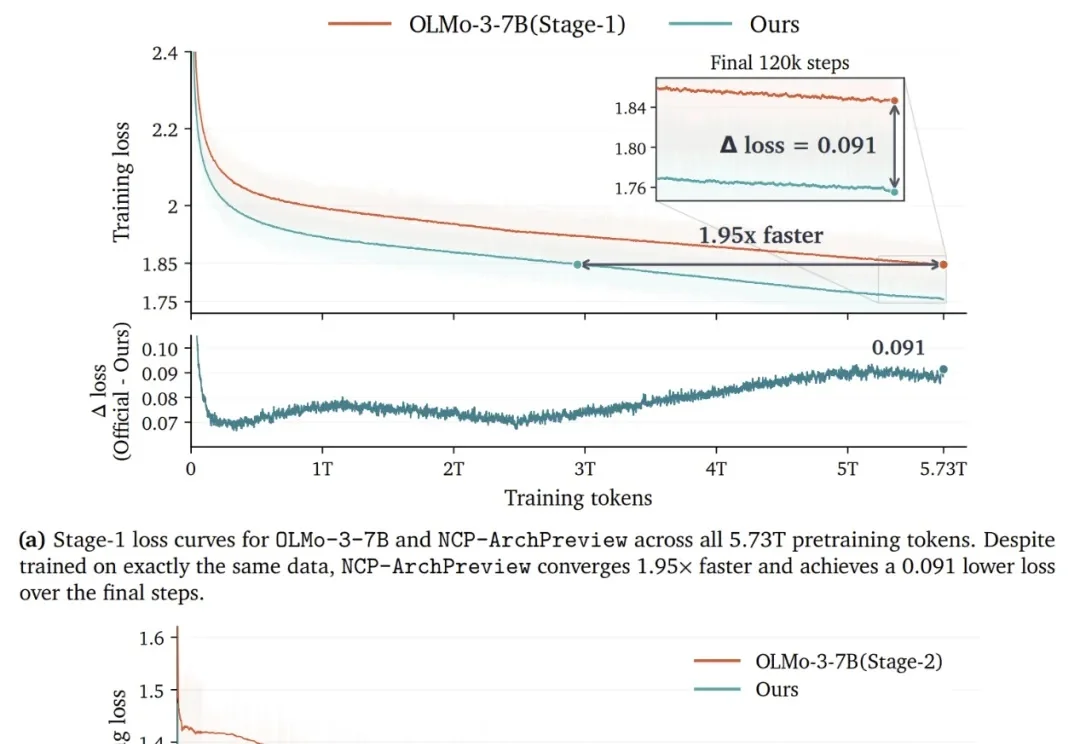
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
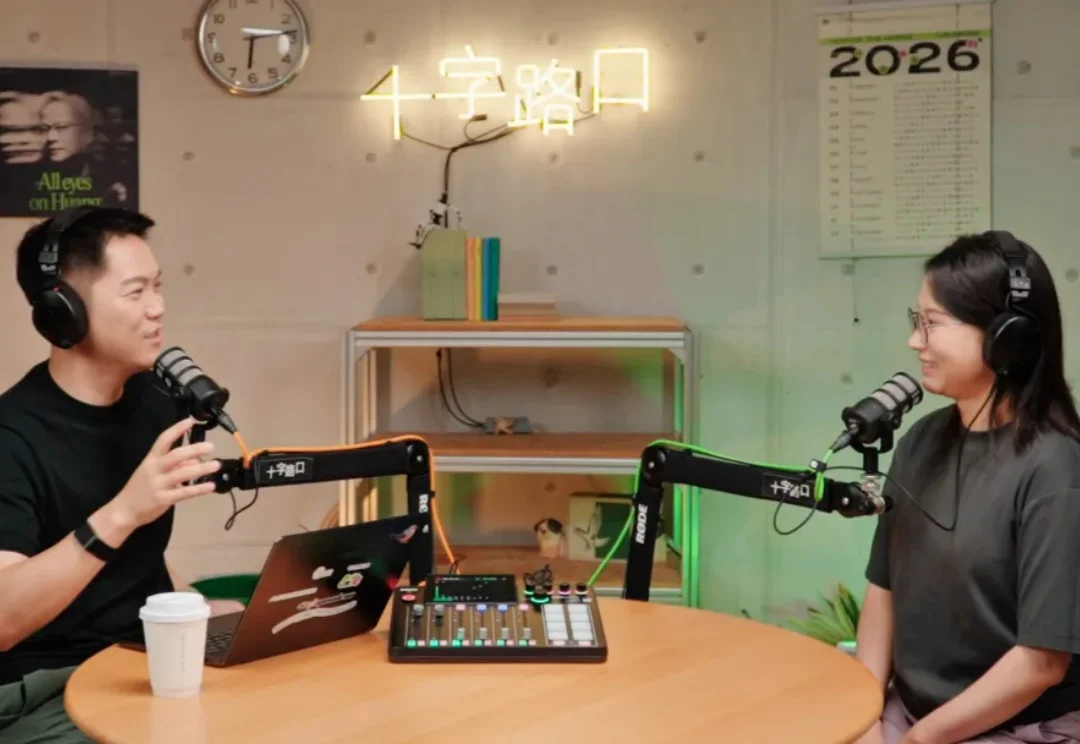
本周「十字路口」的嘉宾是清华叉院助理教授徐梦迪。从清华车辆工程出发,途经 Johns Hopkins、CMU,再到 Stanford 吴佳俊、李飞飞组做博士后,2024 年初她选择回国,加入清华交叉信息研究院。她的核心命题是机器人的 In-Context Learning (ICL):让机器人到一个新环境,通过一两次交互当场学会新任务,而且越学越快。
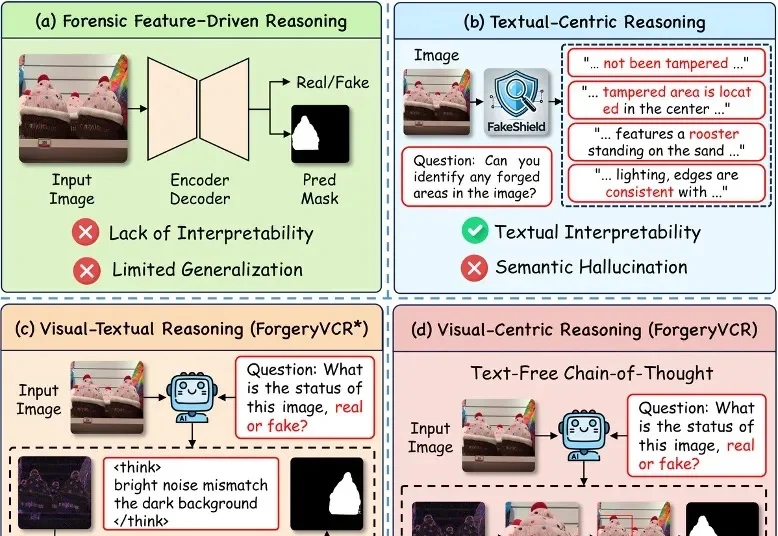
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。