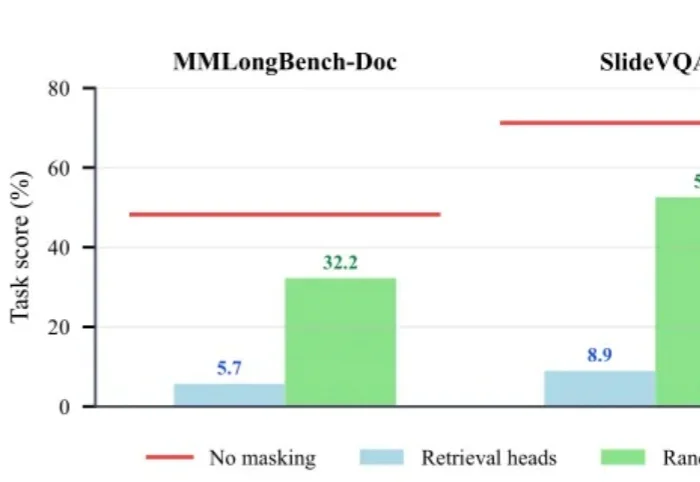
多模态检索头首次被锁定:揭开大模型长文档内部检索真相 | EMNLP'26
多模态检索头首次被锁定:揭开大模型长文档内部检索真相 | EMNLP'26随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
来自主题: AI技术研报
10502 点击 2026-09-08 15:05

 搜索
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
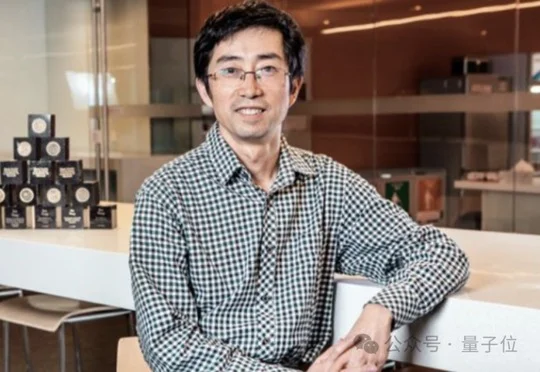
图形学宗师童欣正式加盟胡渊鸣创办的AI 3D公司Meshy出任首席科学家,将负责制定长期科研战略,与胡渊鸣共同推进多模态世界模型与实时交互系统突破,朝着"AI for Fun"的愿景迈进。
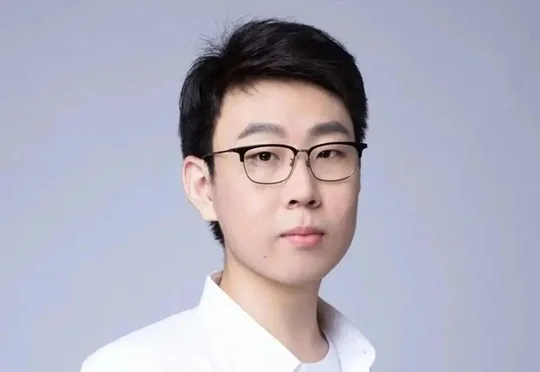
前DeepSeek核心研究员魏浩然近日带队加入百度基础模型研发部,出任文心大模型多模态算法负责人,负责端到端OCR等方向,其此前主导的Unlimited OCR模型曾在OmniDocBench评测中取得全球第一。
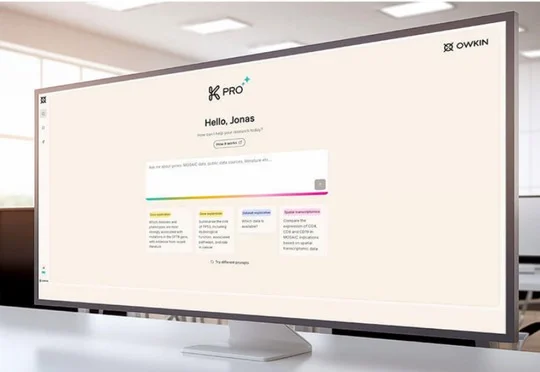
AI制药公司Owkin与勃林格殷格翰达成许可协议,将人工智能科学家K Pro及多模态患者数据用于肿瘤学和免疫学多个适应症的药物发现,K Pro已将Owkin内部药物靶点识别速度提升70%。
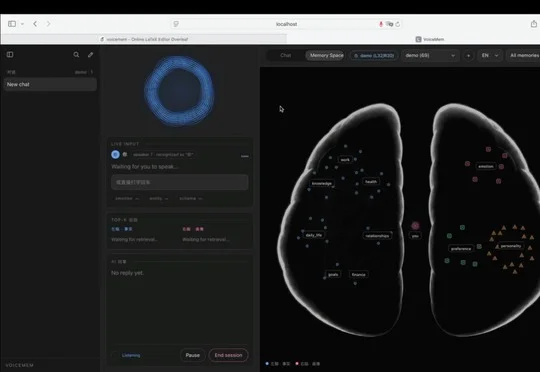
颜水成团队发布语音领域首个实时“流式双脑架构”记忆框架,左脑记信息,右脑记住你。 编辑丨岑峰 科幻电影曾无数次预演过AI与人类共生的场景。但在2026年的今天,尽管GPT-4o、全双工模型、Inter
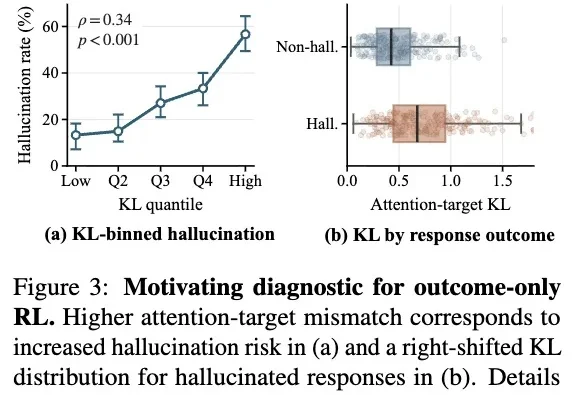
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
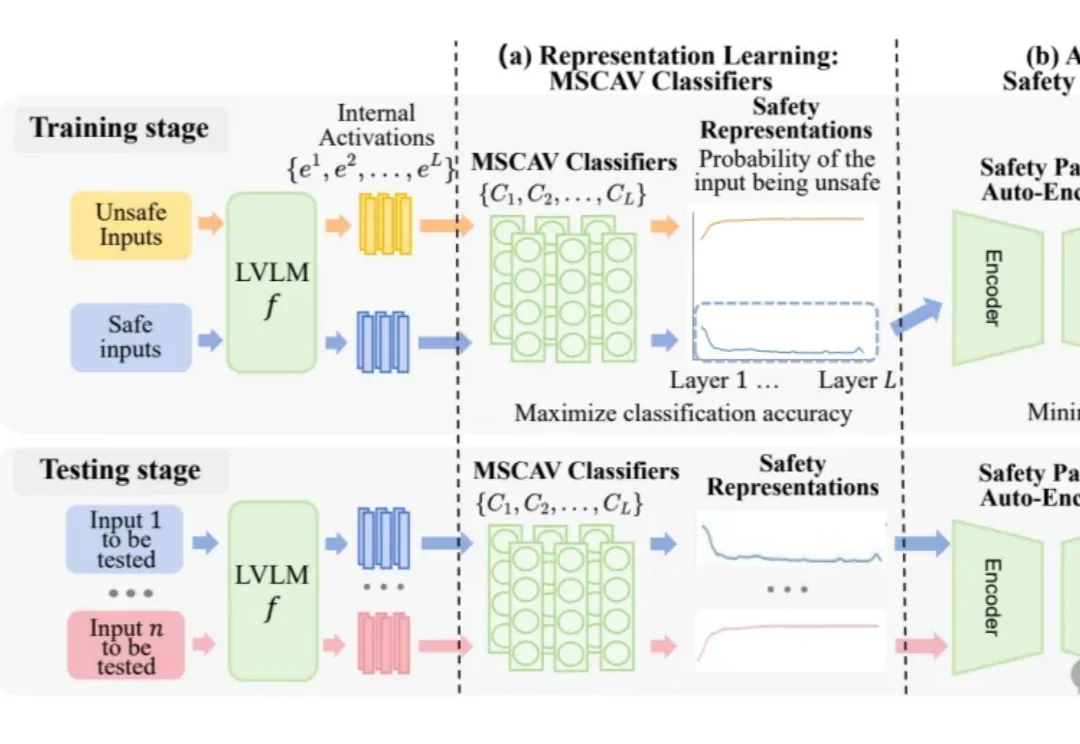
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。
「全球首个」多模态世界模型,来了!
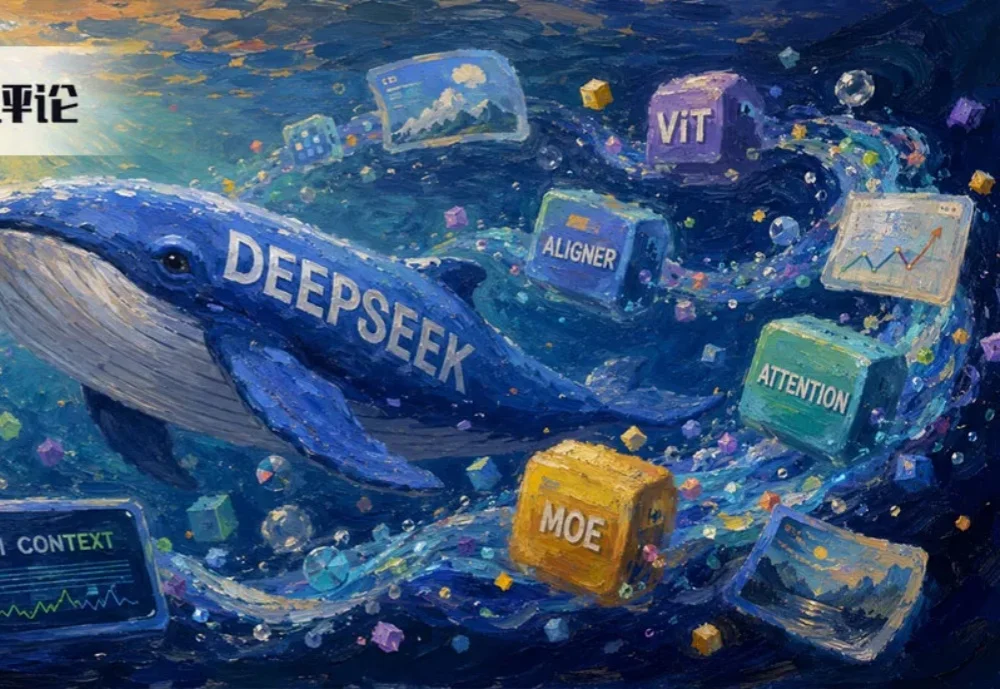
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
DeepSeek-V4-Flash-Vision-Exp多模态模型正式开源,该模型为DeepSeek-V4系列首个实验性多模态模型,基于DeepSeek-V4-Flash架构集成视觉模块,在真实世界软件工程测试DeepSWE中以59.3%反超Opus-4.8登顶,并在零样本视觉推理测试ZeroBench中击败Opus-4.8。