
Jamba 1.5发布,最长上下文,非Transformer架构首次成功领先
Jamba 1.5发布,最长上下文,非Transformer架构首次成功领先Jamba是第一个基于 Mamba 架构的生产级模型。Mamba 是由卡内基梅隆大学和普林斯顿大学的研究人员提出的新架构,被视为 Transformer 架构的有力挑战者。
来自主题: AI资讯
10325 点击 2024-08-24 10:07

 搜索
Jamba是第一个基于 Mamba 架构的生产级模型。Mamba 是由卡内基梅隆大学和普林斯顿大学的研究人员提出的新架构,被视为 Transformer 架构的有力挑战者。
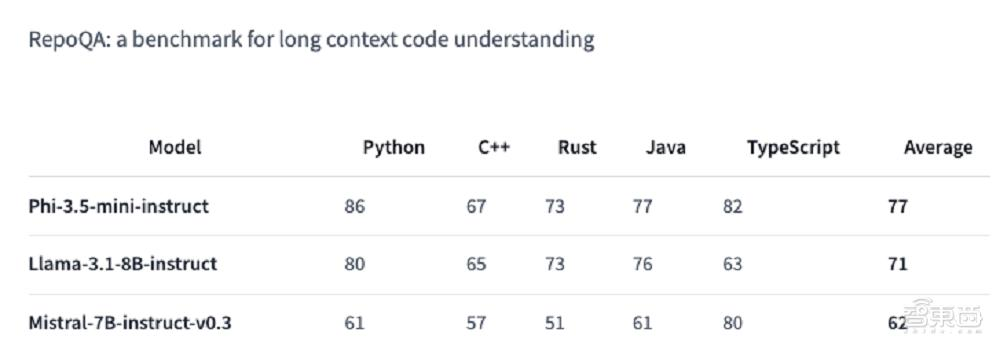
轻量级模型的春天要来了吗?
现在,长上下文视觉语言模型(VLM)有了新的全栈解决方案 ——LongVILA,它集系统、模型训练与数据集开发于一体。
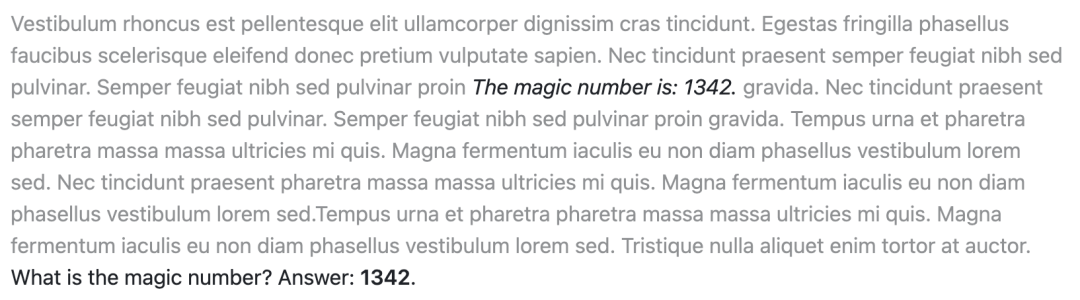
长文本处理能力对LLM的重要性是显而易见的。在2023年初,即便是当时最先进的GPT-3.5,其上下文长度也仅限于2k,然而今日,128k的上下文长度已经成为衡量模型技术先进性的重要标志之一。那你知道LLMs的长文本阅读能力如何评估吗?

国产多模态大模型,也开始卷上下文长度。
当今的LLM已经号称能够支持百万级别的上下文长度,这对于模型的能力来说,意义重大。但近日的两项独立研究表明,它们可能只是在吹牛,LLM实际上并不能理解这么长的内容。
小模型,正在成为 AI 巨头的新战场。
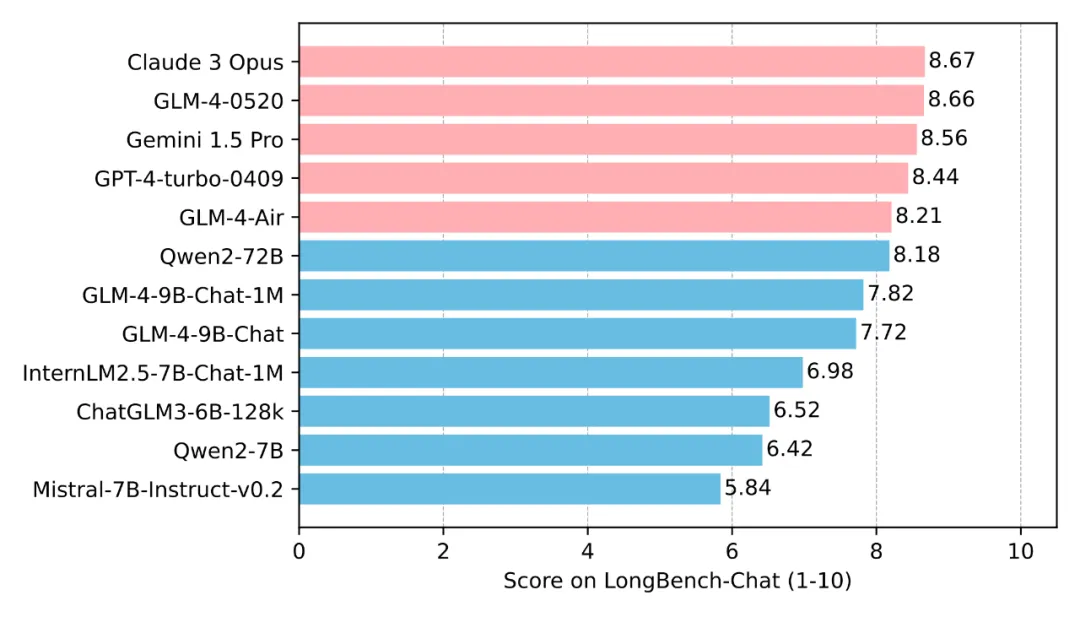
在2023年初,即便是当时最先进的GPT-3.5,其上下文长度也仅限于2k。然而,时至今日,1M的上下文长度已经成为衡量模型技术先进性的重要标志之一。
视频生成也能参考“上下文”?!

长上下文大模型帮助机器人理解世界。