斯坦福华人研究火了:45分钟让你的论文变身AI智能体!
斯坦福华人研究火了:45分钟让你的论文变身AI智能体!斯坦福大学研究人员提出了Paper2Agent,将静态论文转化为可交互的AI智能体,让学术成果可以直接被「调用」,为科研知识传播开辟了新模式,并为构建AI共研生态奠定基础。
来自主题: AI技术研报
11247 点击 2025-10-08 11:44

 搜索
斯坦福大学研究人员提出了Paper2Agent,将静态论文转化为可交互的AI智能体,让学术成果可以直接被「调用」,为科研知识传播开辟了新模式,并为构建AI共研生态奠定基础。
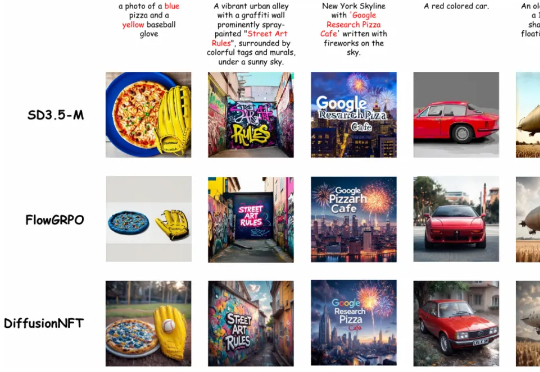
清华大学朱军教授团队,NVIDIA Deep Imagination 研究组与斯坦福 Stefano Ermon 团队联合提出了一种全新的扩散模型强化学习(RL)范式 ——Diffusion Negative-aware FineTuning (DiffusionNFT)。该方法首次突破现有 RL 对扩散模型的基本假设,直接在前向加噪过程(forward process)上进行优化
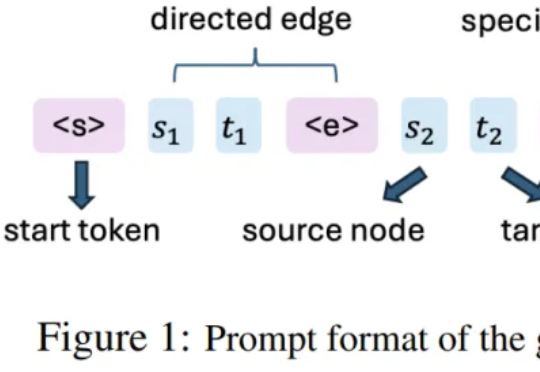
该团队 2025 年的研究《Reasoning by superposition: A theoretical perspective on chain of continuous thought》已从理论上指出,连续思维链的一个关键优势在于它能使模型在叠加(superposition)状态下进行推理:当模型面对多个可能的推理路径而无法确定哪一个是正确时,它可以在连续空间中并行地保留所有可能的路
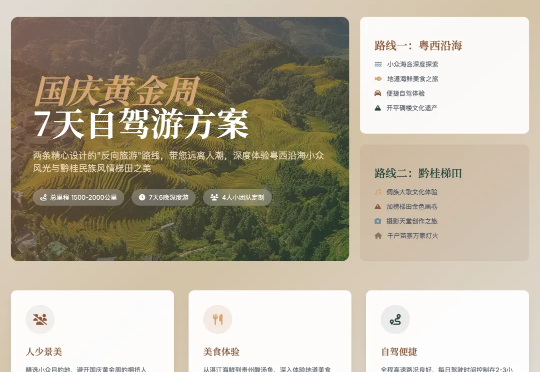
国庆长假,AI 大模型献礼的方式是一波接一波的更新。OpenAI 突然发布 Sora2,DeepSeek 更新了 V3.2,智谱更新了 GLM-4.6,Kimi 则是更新了 App,然后默默在自己的版本记录里面,写下了这句话。
近日,DeepMind 最新推出了一种全新的用于代码安全的 AI Agent—CodeMender,它使用 Gemini Deep Think 自动修补关键软件漏洞。它会检查补丁是否正确、是否能够修复根本原因,并且不会引起其他任何破坏。这确保只有高质量的解决方案才会被发送给人工审核。

科技与信仰之间的张力持续存在。 封面图片由AI生成 出品|白鲸出海编辑部 最近的《月流水上涨数倍、多品类爆发,AI 产品在移动端越来越赚钱?》选题中我们观察到一款名为 Bible Chat:Daily
论文提出的方法名为 RL4HS,它使用了片段级奖励(span-level rewards)和类别感知的 GRPO(Class-Aware Group Relative Policy Optimization),从而避免模型偷懒、只输出无错误预测。
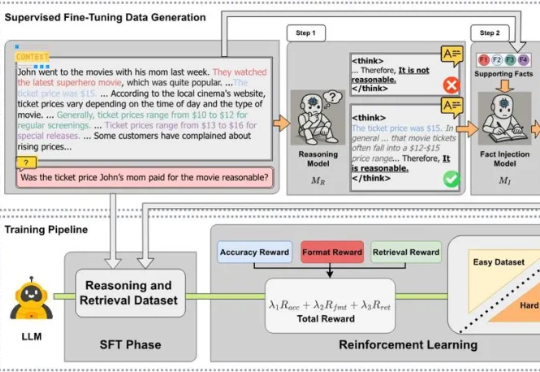
近日,来自 MetaGPT、蒙特利尔大学和 Mila 研究所、麦吉尔大学、耶鲁大学等机构的研究团队发布 CARE 框架,一个新颖的原生检索增强推理框架,教会 LLM 将推理过程中的上下文事实与模型自身的检索能力有机结合起来。该框架现已全面开源,包括训练数据集、训练代码、模型 checkpoints 和评估代码,为社区提供一套完整的、可复现工作。
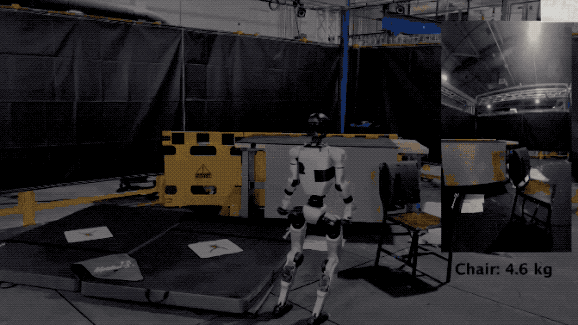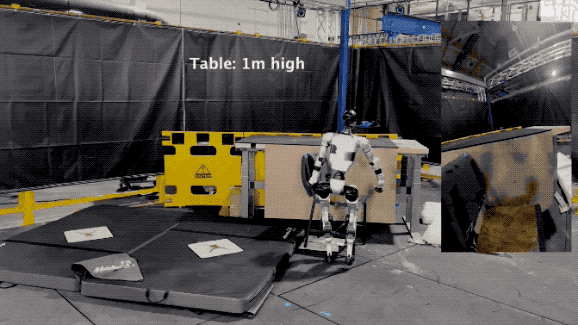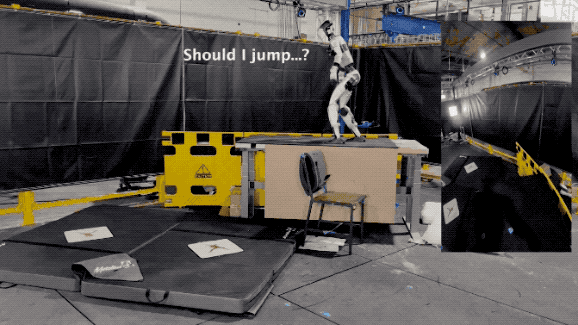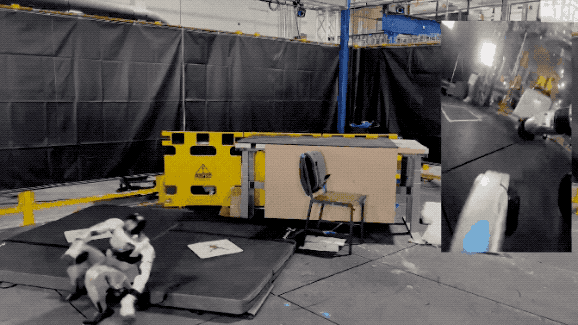
你见过这样的“盲眼”机器人demo吗?这些丝滑小连招来自亚马逊机器人团队FAR(Frontier AI for Robotics)发布的首个人形机器人(足式)研究成果——OmniRetarget!
早在 2021 年,研究人员就已经发现了深度神经网络常常表现出一种令人困惑的现象,模型在早期训练阶段对训练数据的记忆能力较弱,但随着持续训练,在某一个时间点,会突然从记忆转向强泛化。