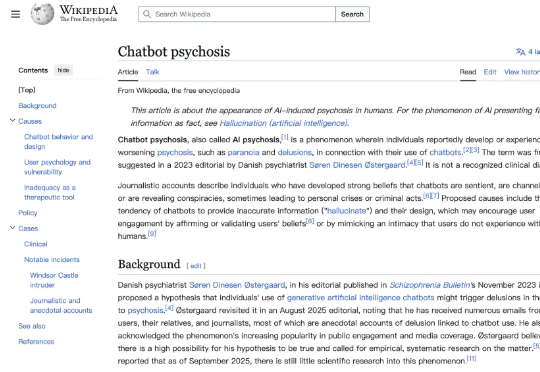
每天都和 AI 聊天,你可能已经是个「神经病」
每天都和 AI 聊天,你可能已经是个「神经病」维基百科的「ChatBot 精神病」这一词条,诞生自今年 6 月。在过去 4 个月里,被编辑了超过 300 次,参考资料 24 条,著名案例有 TikToker、硅谷投资人、未成年用户……
来自主题: AI资讯
9537 点击 2025-11-04 16:15

 搜索
维基百科的「ChatBot 精神病」这一词条,诞生自今年 6 月。在过去 4 个月里,被编辑了超过 300 次,参考资料 24 条,著名案例有 TikToker、硅谷投资人、未成年用户……
大语言模型(LLM)的「炼丹师」们,或许都曾面临一个共同的困扰:为不同任务、不同模型手动调整解码超参数(如 temperature 和 top-p)。这个过程不仅耗时耗力,而且一旦模型或任务发生变化,历史经验便瞬间失效,一切又得从头再来。
当我们还在调侃「AI写错代码」时,实验室里的科学家却看到它能独立完成几个小时的复杂任务。AlphaGo作者Julian罕见发声:公众对AI的认知,至少落后一个世代。最新数据更显示,AI正以指数速度逼近专家水准,2026或许就是临界点。我们,是在见证未来,还是在自欺欺人?
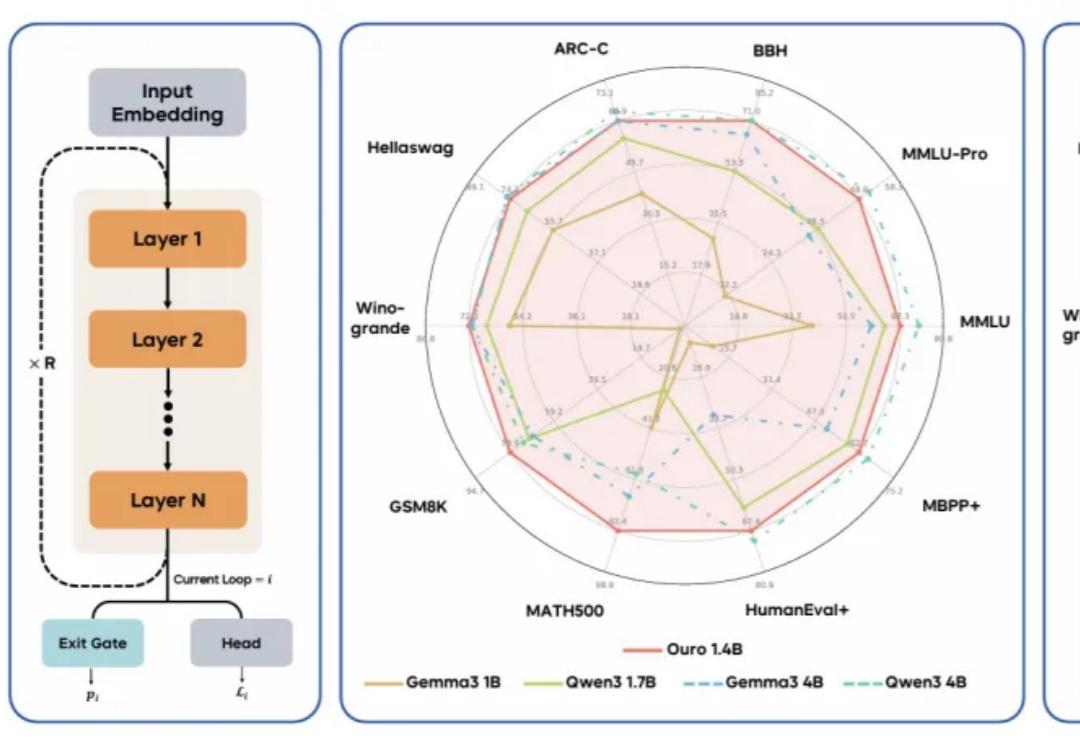
现代 LLM 通常依赖显式的文本生成过程(例如「思维链」)来进行「思考」训练。这种策略将推理任务推迟到训练后的阶段,未能充分挖掘预训练数据中的潜力。
AI万亿赌局,马斯克们正越来越富,但人类在集体失业?Hinton最新末日警告,科技巨头不裁员,根本赚不到钱。
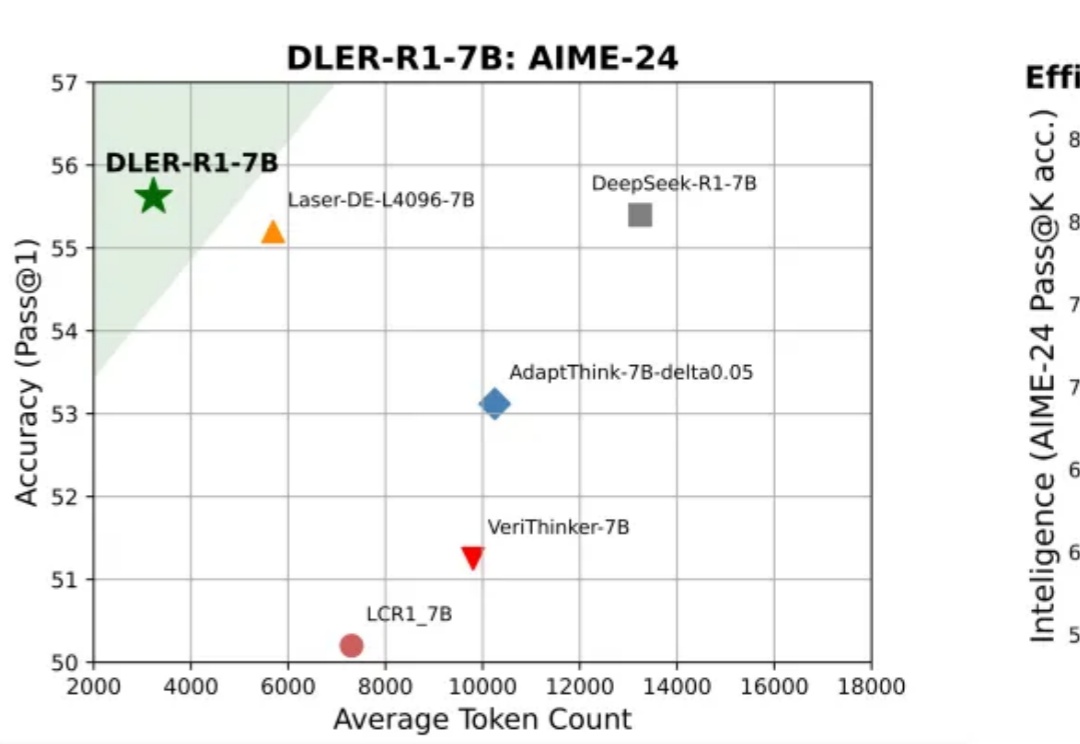
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
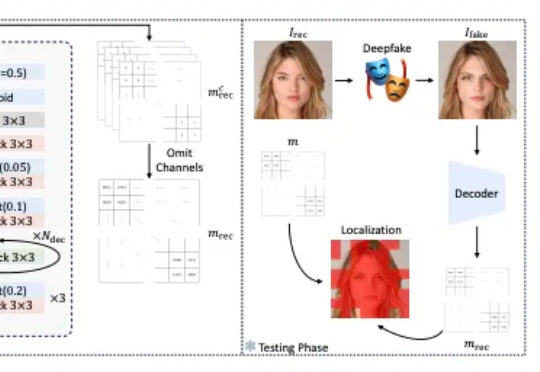
该论文提出 FractalForensics,一种基于分形水印的主动深度伪造检测与定位方法。不同于以往的水印向量,为达成伪造定位的功能,论文提出的水印以矩阵形式出现。

精彩,实在是精彩!硅谷“甄嬛传”——老马、奥特曼和llya的爱恨情仇又更新了。
昨天一大早,就发现美团开源了他们首款全模态实时交互大模型:LongCat-Flash-Omni。
擎天柱靓丽演示背后,是近百号员工每日8小时,疯狂重复固定动作,擦桌子、扮大猩猩等,他们正用体力「喂饱」擎天柱。