提前对齐,视频问答新SOTA!北大全新Video-LLaVA视觉语言大模型,秒懂视频笑点
提前对齐,视频问答新SOTA!北大全新Video-LLaVA视觉语言大模型,秒懂视频笑点最近,来自北京大学等机构研究者提出了一种全新视觉语言大模型——Video-LLaVA,使得LLM能够同时接收图片和视频为输入。Video-LlaVA在下游任务中取得了卓越的性能,并在图片、视频的13个基准上达到先进的性能。这个结果表明,统一LLM的输入能让LLM的视觉理解能力提升。
搜索
最近,来自北京大学等机构研究者提出了一种全新视觉语言大模型——Video-LLaVA,使得LLM能够同时接收图片和视频为输入。Video-LlaVA在下游任务中取得了卓越的性能,并在图片、视频的13个基准上达到先进的性能。这个结果表明,统一LLM的输入能让LLM的视觉理解能力提升。
全面兼容Stable Diffusion生态,LCM模型成功实现5-10倍生成速度的提升,实时AI艺术时代即将到来,所想即所得!
在科技圈还在为OpenAI所贡献出的年度大戏唏嘘不已时,中国的互联网云厂商们正在经历着新一轮的变化。近期阿里云、百度云与腾讯云纷纷拿出了自己的三季度成绩单,利润端的提升成为亮点。于此同时,中止分拆后的阿里云调整最新的组织架构,以适应阿里巴巴新CEO吴泳铭口中的「AI驱动、公共云优先」的战略。
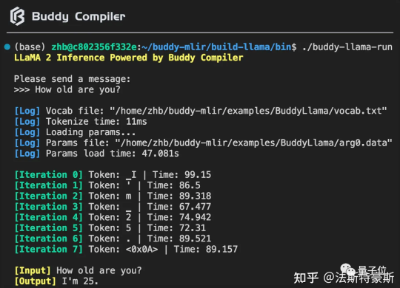
Buddy Compiler 端到端 LLaMA2-7B 推理示例已经合并到 buddy-mlir仓库[1]主线。我们在 Buddy Compiler 的前端部分实现了面向 TorchDynamo 的第三方编译器,从而结合了 MLIR 和 PyTorch 的编译生态。
本文探讨了AI对齐在OpenAI公司中被忽视的一部分,以及AI对齐在大模型训练中的重要性和影响。文章揭示了OpenAI内部因AI对齐而产生的分歧,并阐述了AI对齐在保证AI按照人类意图和价值观运作方面的作用。同时,文章指出AI对齐在大模型训练中存在的性能阉割和对齐税等问题,以及AI对齐在大模型发展中的隐藏模型和重要性。
据知名人士爆料,苹果内部对iOS 18将带来的更新「雄心勃勃」,并且,苹果自己的生成式AI也将很快与大家见面,我们的Siri会更加聪明吗?
在金融领域,投资决策一直是核心问题。随着人工智能技术的不断发展,越来越多的金融机构开始利用人工智能来辅助投资决策和加强风险控制。本文采访了巴黎HEC商学院创业学教授Thomas stebro,将探讨人工智能在风险投资(VC)和私募股权投资(PE)中的应用,并展望未来的发展趋势。
连续五天的OpenAI管理层冲突及谈判后,Sam Altman最终回归OpenAI。但皆大欢喜之际,是时候聊聊这次事件的另外一边声音了:OpenAI技术灵魂人物Ilya Sutskeve对AI安全的恐惧和他对技术发展的信念。
自从有了这个「2号分身」,隔壁小王的搬砖效率,已经碾压一众同事了。
Stable Diffusion官方终于对视频下手了——发布生成式视频模型Stable Video Diffusion(SVD)。