时序=图像?无需微调,视觉MAE跨界比肩最强时序预测大模型
时序=图像?无需微调,视觉MAE跨界比肩最强时序预测大模型近期,浙大和 Salesforce 学者进一步发现:语言模型或许帮助有限,但是图像模型能够有效地迁移到时序预测领域。
来自主题: AI资讯
6308 点击 2024-09-19 15:24

 搜索
近期,浙大和 Salesforce 学者进一步发现:语言模型或许帮助有限,但是图像模型能够有效地迁移到时序预测领域。

Transformer 是现代深度学习的基石。传统上,Transformer 依赖多层感知器 (MLP) 层来混合通道之间的信息。
APP内“智能体”数量大增,如通义已经超过14000个、讯飞星火超过11000个、豆包超过5000个
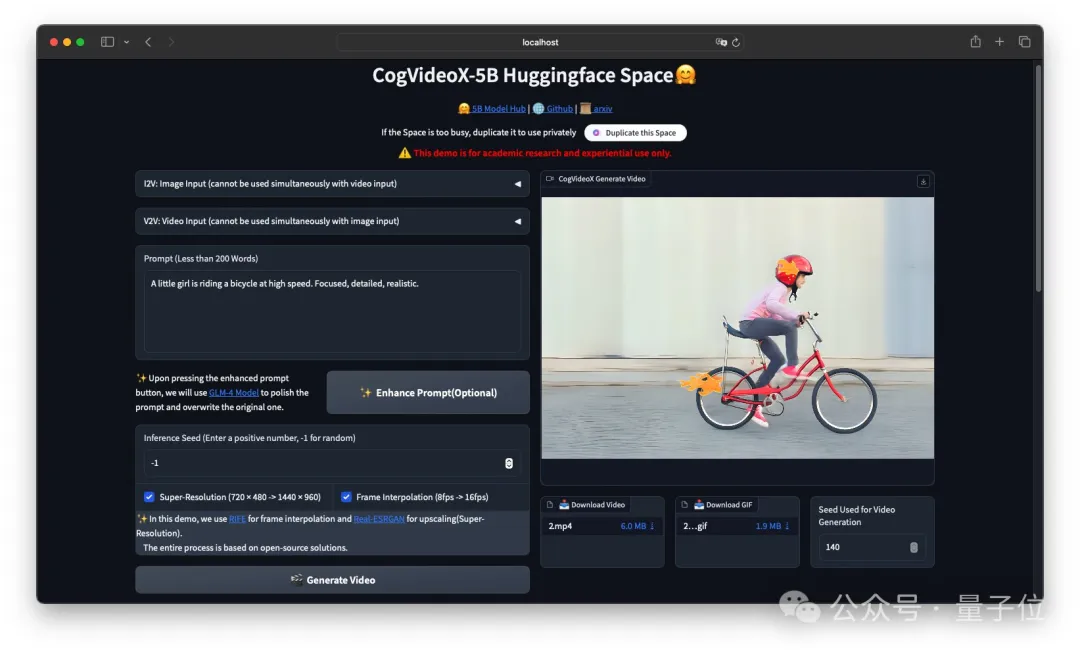
刚刚,智谱把清影背后的图生视频模型CogVideoX-5B-I2V给开源了!(在线可玩) 一起开源的还有它的标注模型cogvlm2-llama3-caption。

英伟达拟以1.65亿美元收购AI公司OctoAI。

阿里开源,又拿第一了。
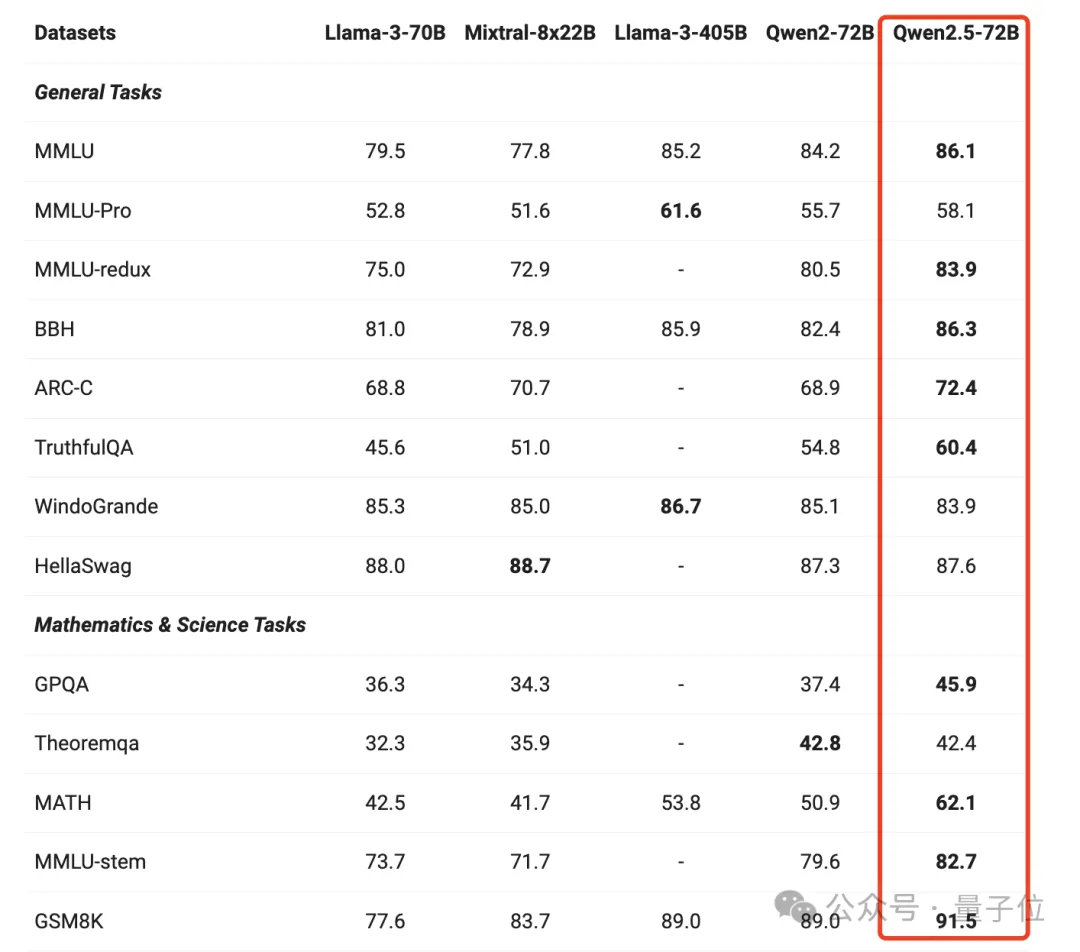
击败LIama3!Qwen2.5登上全球开源王座。 而后者仅以五分之一的参数规模,就在多任务中超越LIama3 405B。
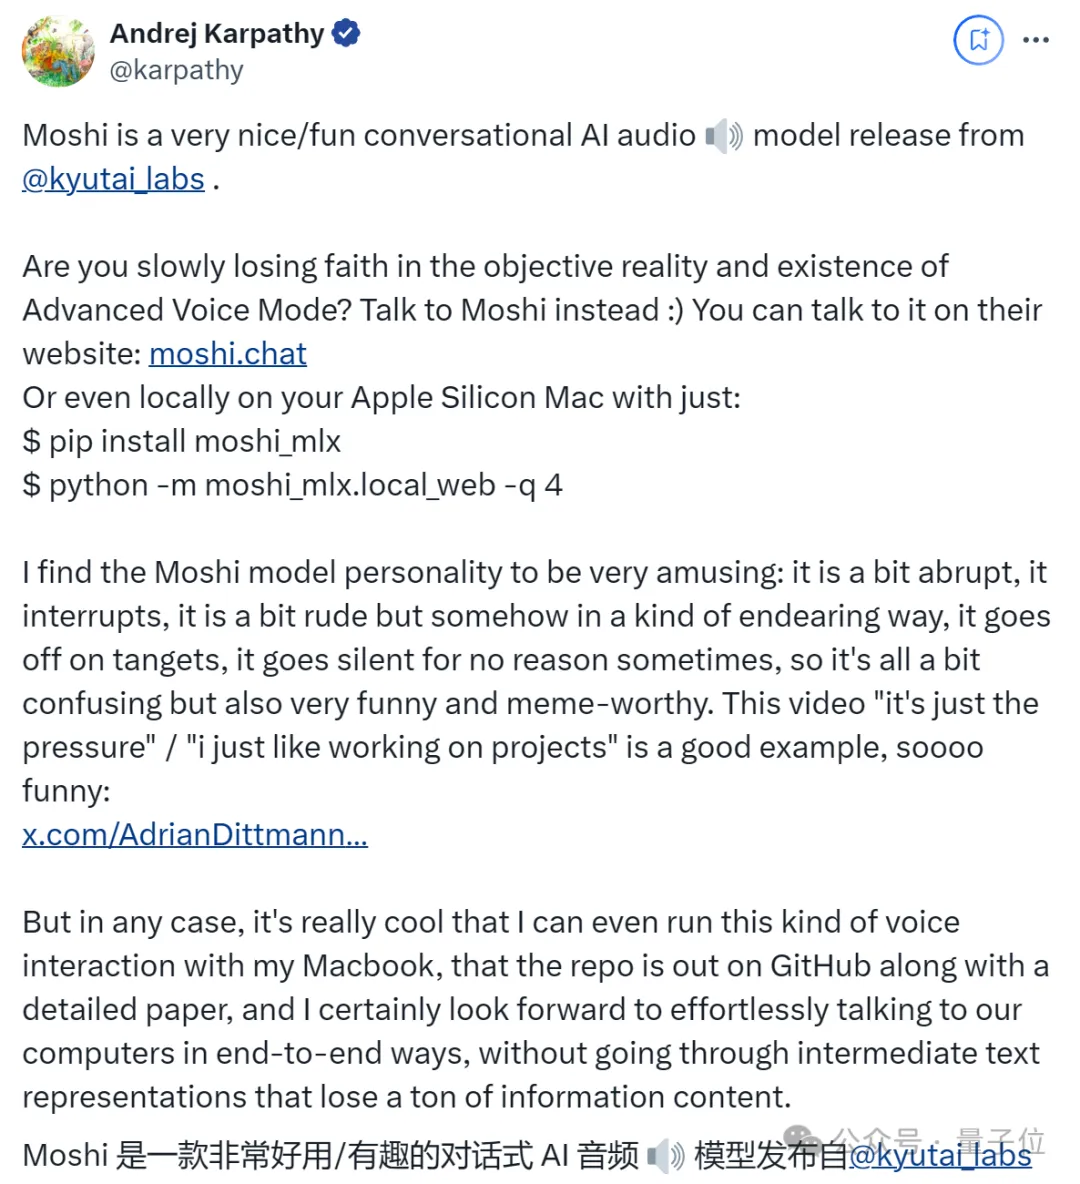
大神Karpathy鼎力推荐,开源版「Her」Moshi再引关注!
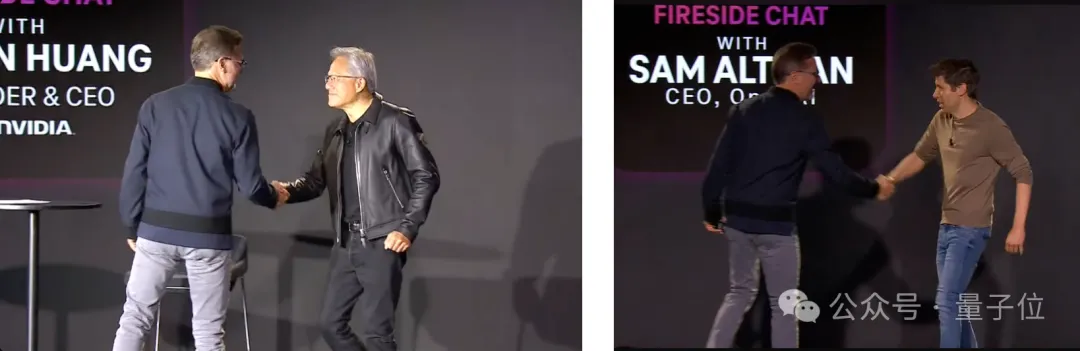
AI界最有影响力的两个人,同时出现在一场活动: OpenAI CEO奥特曼,暗示了o1满血版将在接下来几个月发布。
本论文第一作者倪赞林是清华大学自动化系 2022 级直博生,师从黄高副教授,主要研究方向为高效深度学习与图像生成。他曾在 ICCV、CVPR、ECCV、ICLR 等国际会议上发表多篇学术论文。