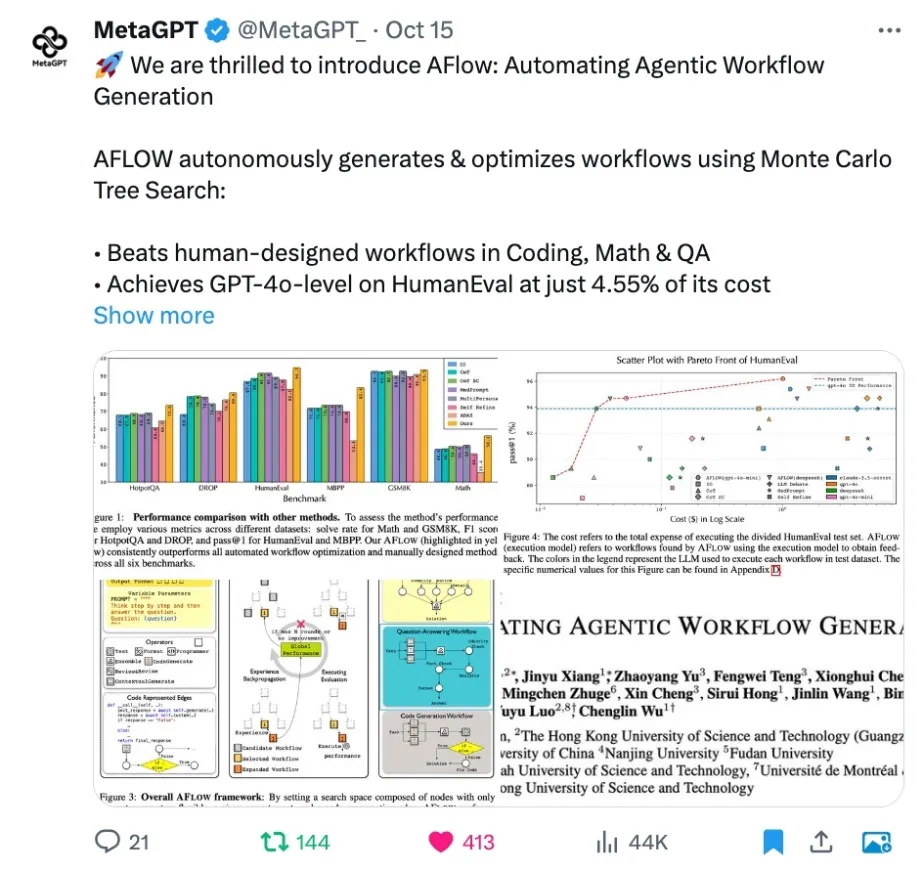
MetaGPT开源自动生成智能体工作流,4.55%成本超GPT-4o
MetaGPT开源自动生成智能体工作流,4.55%成本超GPT-4o对于 LLM 从业者来说,让 LLM 落地应用并发挥作用需要手动构建并反复调试 Agentic Workflow,这无疑是个繁琐过程,一遍遍修改相似的代码,调试 prompt,手动执行测试并观察效果,并且换个 LLM 可能就会失效,有高昂的人力成本。许多公司甚至专职招聘 Prompt Engineer 来完成这一工作。
搜索
对于 LLM 从业者来说,让 LLM 落地应用并发挥作用需要手动构建并反复调试 Agentic Workflow,这无疑是个繁琐过程,一遍遍修改相似的代码,调试 prompt,手动执行测试并观察效果,并且换个 LLM 可能就会失效,有高昂的人力成本。许多公司甚至专职招聘 Prompt Engineer 来完成这一工作。
为提高生产力、优化流程和创造更加安全的空间,埃森哲、戴尔科技和联想等公司正在使用全新 NVIDIA AI Blueprint 开发视觉 AI 智能体。
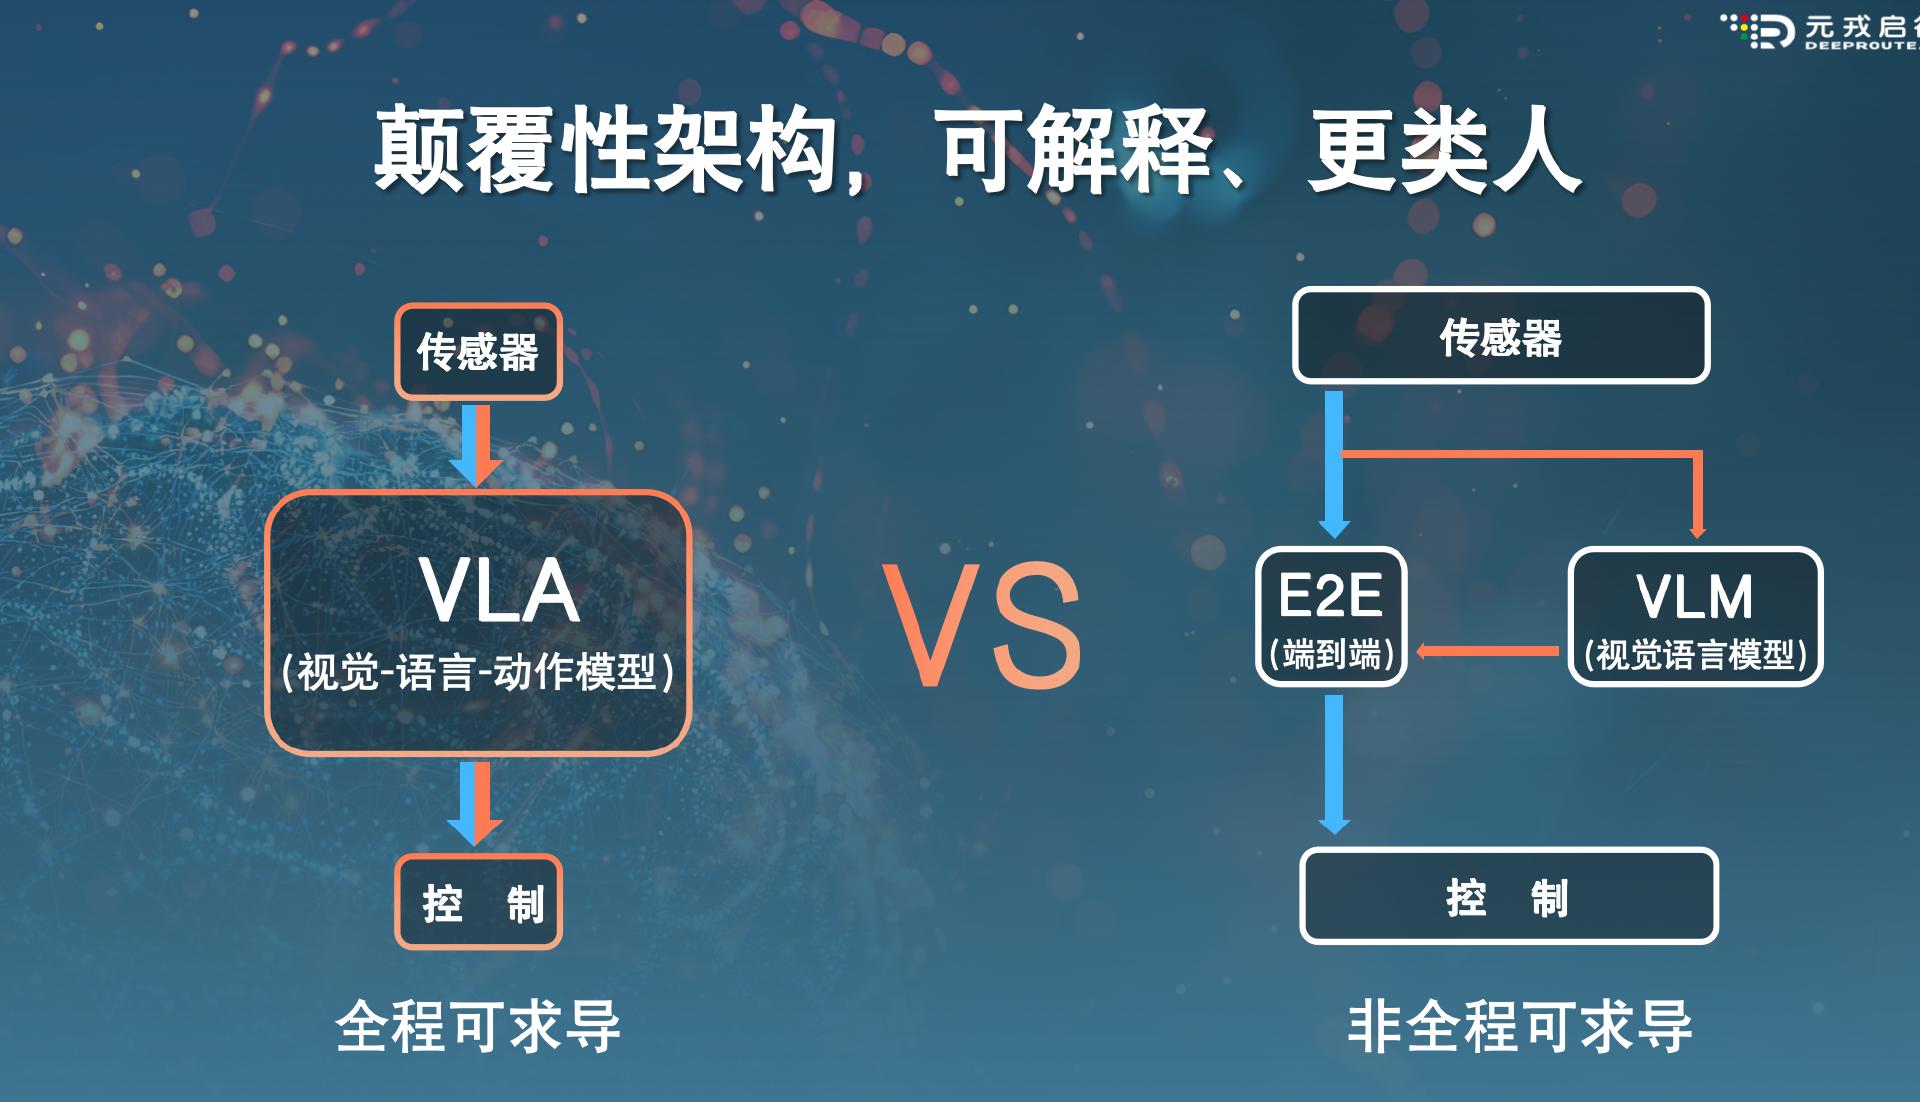
近期,智驾行业出现了一个融合了视觉、语言和动作的多模态大模型范式——VLA(Vision-Language-Action Model,即视觉-语言-动作模型),拥有更高的场景推理能力与泛化能力。不少智驾人士都将VLA视为当下“端到端”方案的2.0版本。
智东西11月8日消息,据外媒The Information报道,亚马逊正讨论向美国AI大模型独角兽Anthropic进行第二笔数十亿美元的投资。
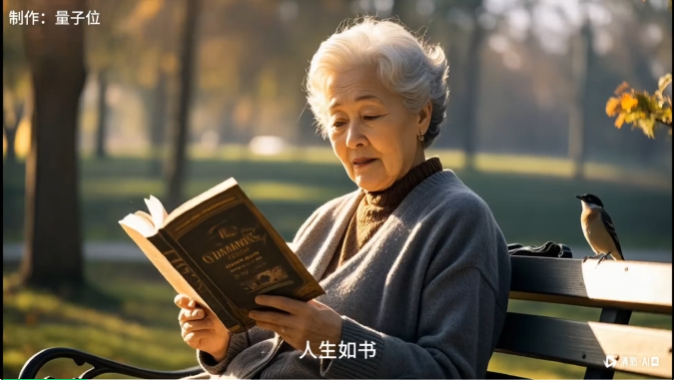
国产AI,正式把视频生成拉进了有声电影时代。 自从Sora引爆视频生成之后,基本上所有AI生成的视频都属于“默片”的效果,也就是没有对应的音效(注意不是配乐)。
历时四年,微软亚研院AI for Science团队发布AI驱动的从头算(ab initio)生物分子动力学模拟系统。 直接登上Nature正刊。
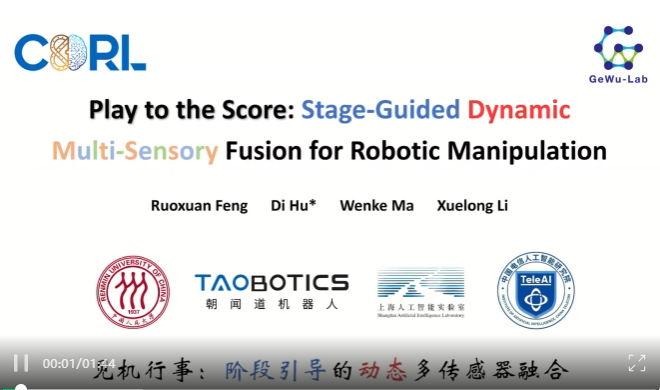
中国人民大学高瓴人工智能学院 GeWu 实验室、朝闻道机器人和 TeleAI 最近的合作研究揭示并指出了 “模态时变性”(Modality Temporality)现象,通过捕捉并刻画各个模态质量随物体操纵过程的变化,提升不同信息在具身多模态交互的感知质量,可显著改善精细物体操纵的表现。论文已被 CoRL2024 接收并选为 Oral Presentation。
随着大语言模型在长文本场景下的需求不断涌现,其核心的注意力机制(Attention Mechanism)也获得了非常多的关注。
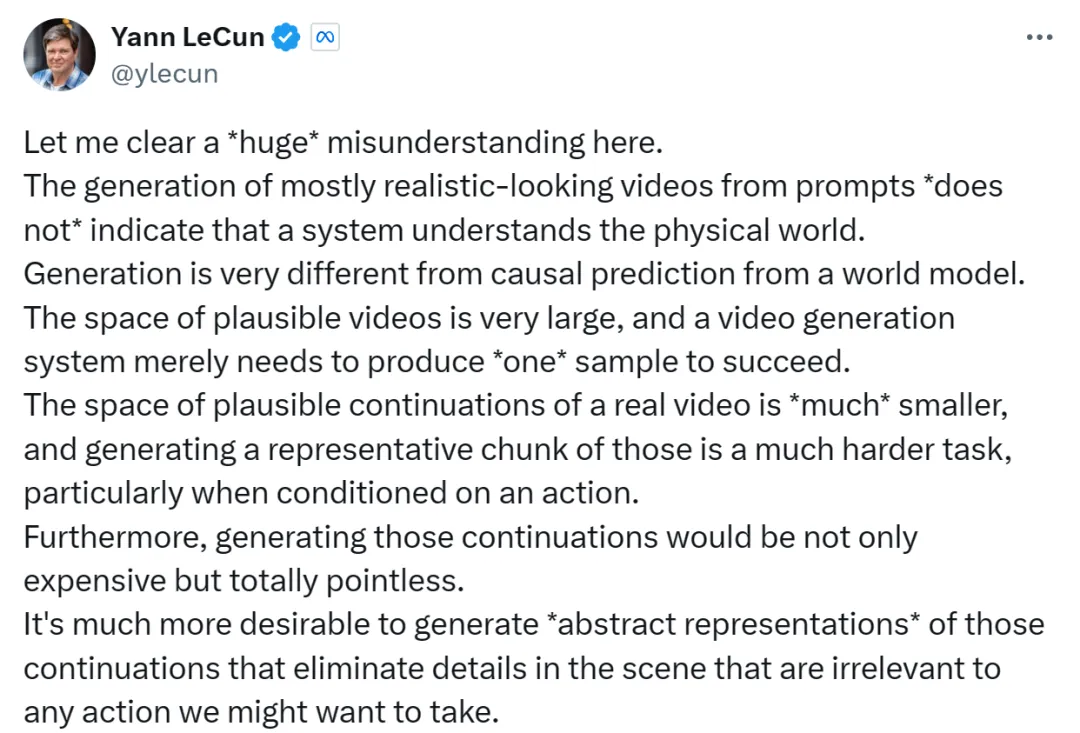
自从 Sora 横空出世,业界便掀起了一场「视频生成模型到底懂不懂物理规律」的争论。图灵奖得主 Yann LeCun 明确表示,基于文本提示生成的逼真视频并不代表模型真正理解了物理世界。之后更是直言,像 Sora 这样通过生成像素来建模世界的方式注定要失败。
OpenAI 的快速增长继续提升供应商和其他商业伙伴的前景,他们的销售也在迅速增长。