给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!
给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。
搜索
其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。
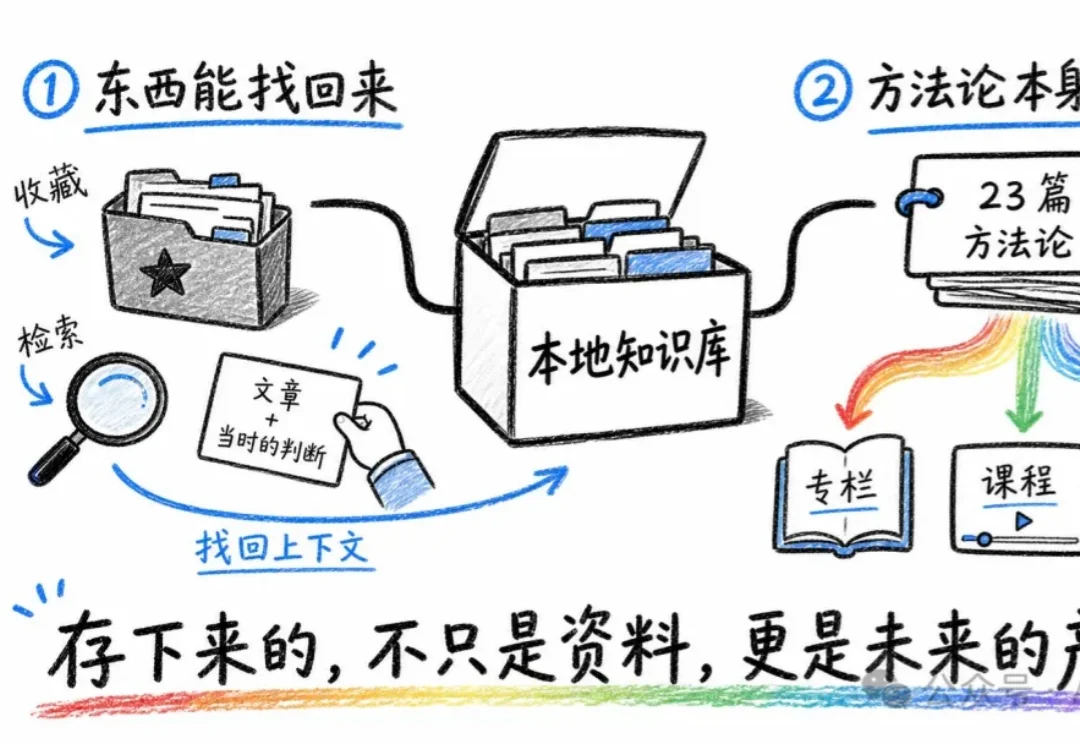
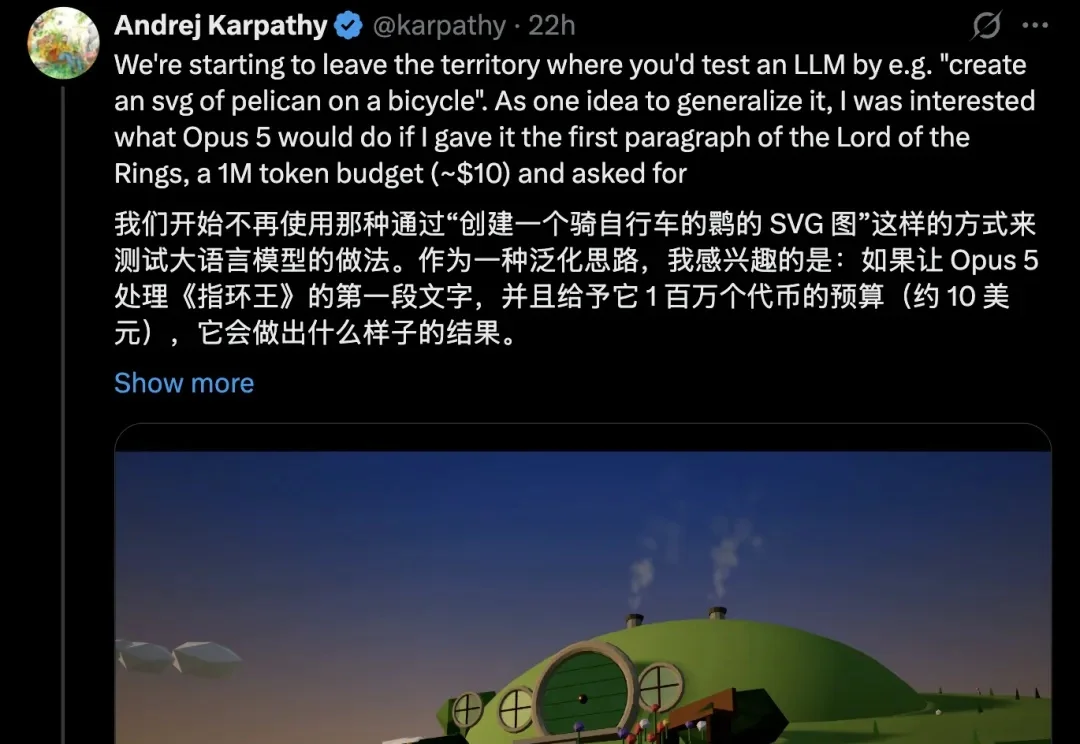
7 月初的时候,我照着 Karpathy 那套 LLM Wiki(简单说就是让 AI 帮你把资料编译成一个能长大的百科)搭了个本地知识库。
话不多说,直接开始每日瘫坐(doge)!
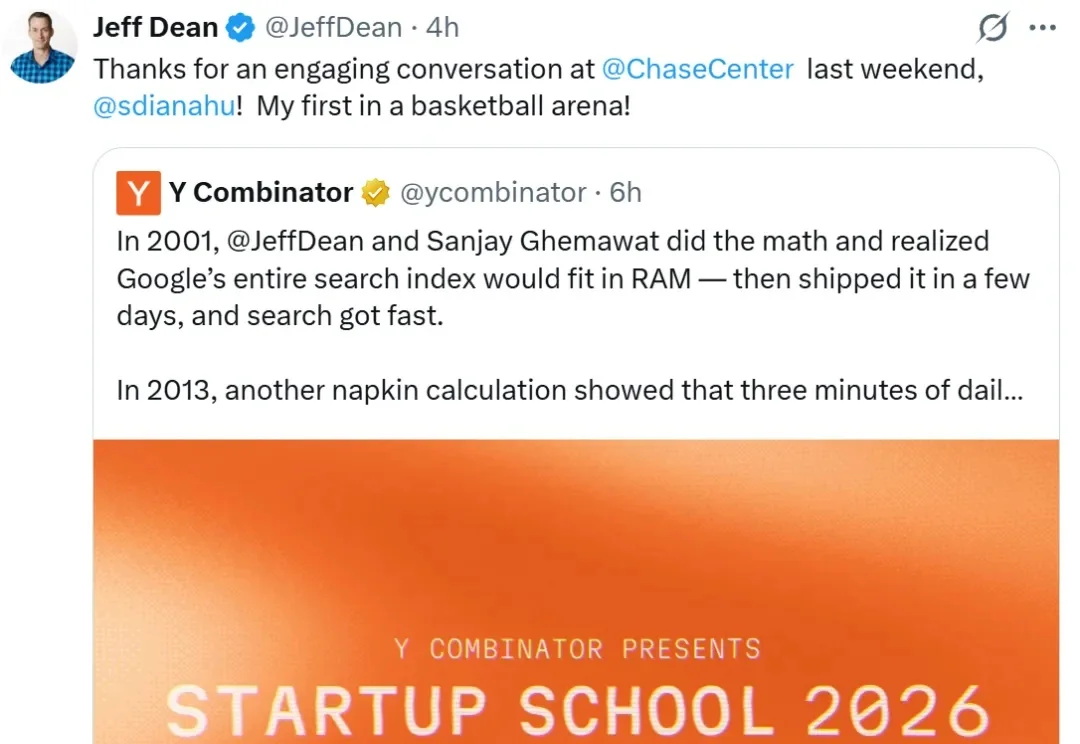
2026 年的 YC Startup School 上,Jeff Dean 的声音有些沙哑。
Token可以“热”,但Token工厂必须靠原生液冷“冷”下来。
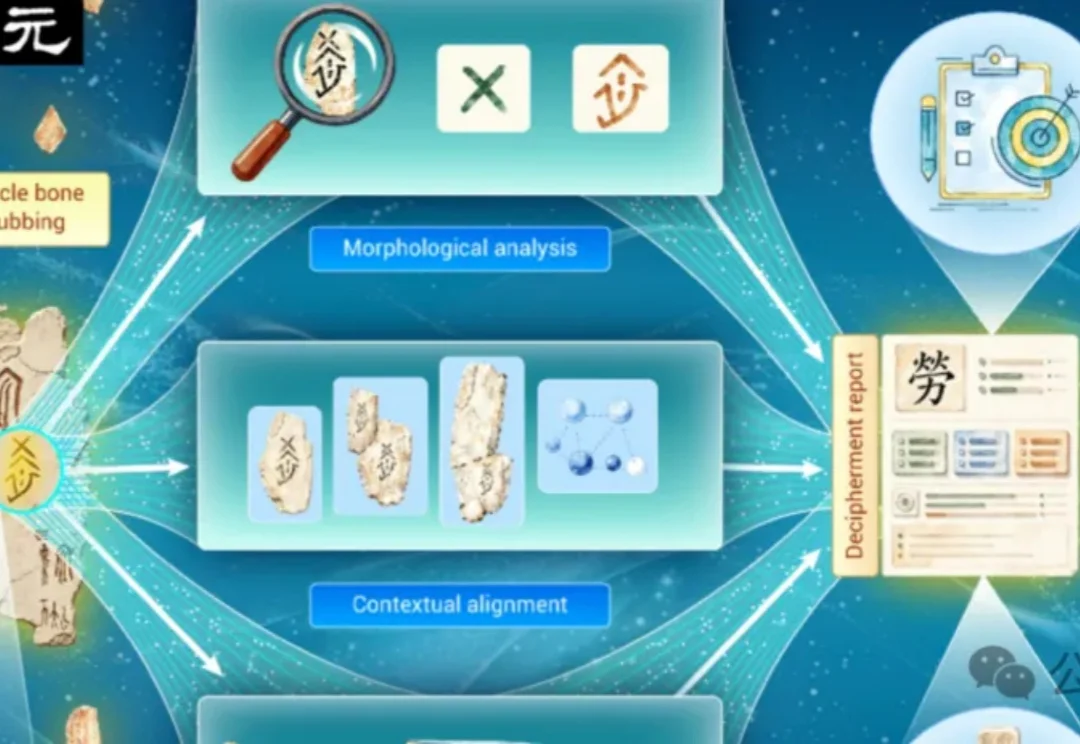
一片龟甲或牛肩胛骨摆在案头,裂纹穿过刻辞,几个字还缺了笔画。
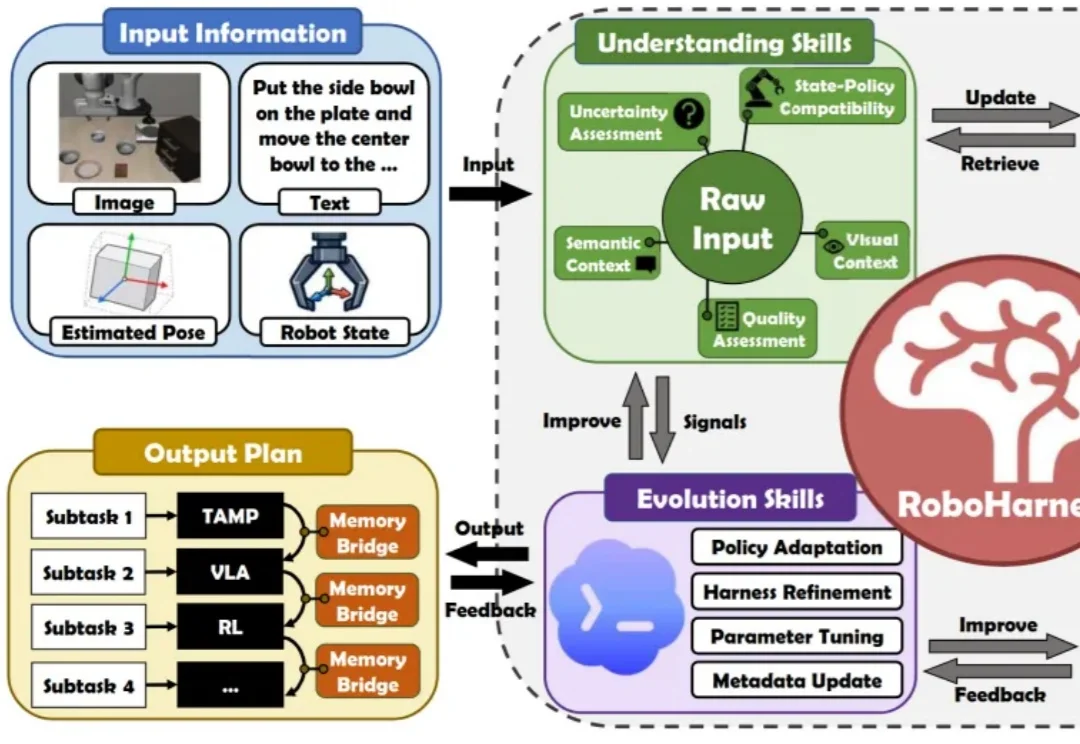
当 VLA、WAM、RL、TAMP、MPC 等机器人控制策略在各自擅长的任务中大放异彩,如何刻画其能力边界,并在正确的时机为不同子任务匹配最合适的策略,正逐渐成为机器人完成复杂长时序任务的关键。
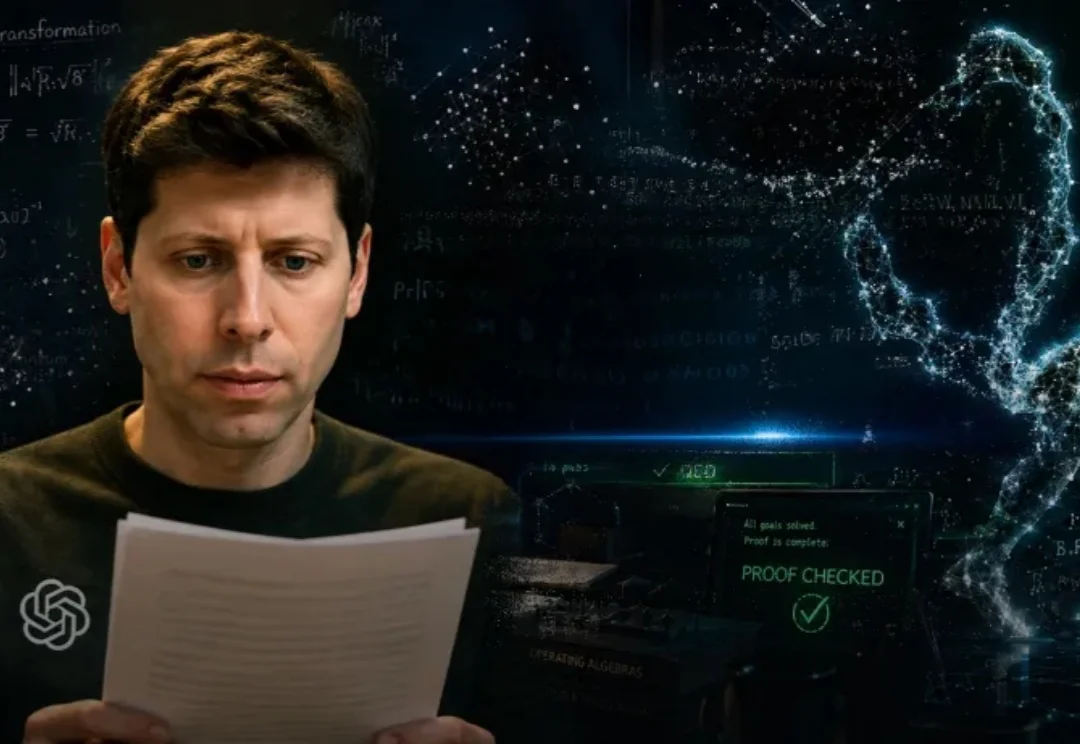
OpenAI内部最新推理模型,一口气发布了十项惊人的数学进展。
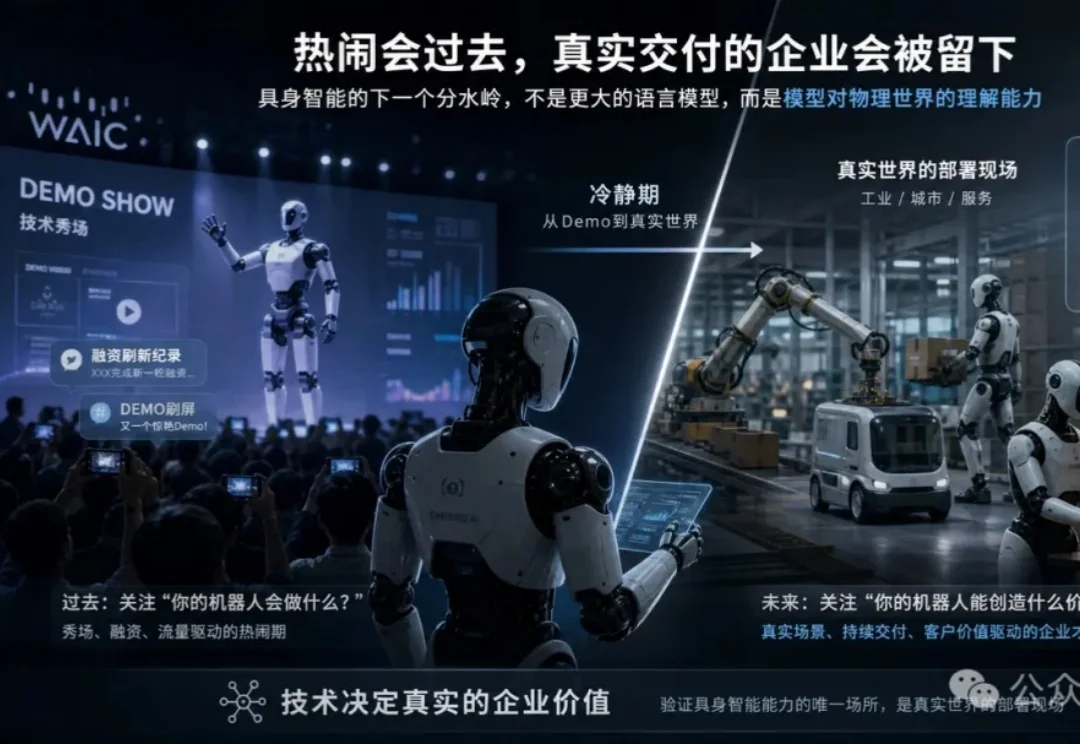
WAIC之后,具身智能行业进入了一段微妙的冷静期。
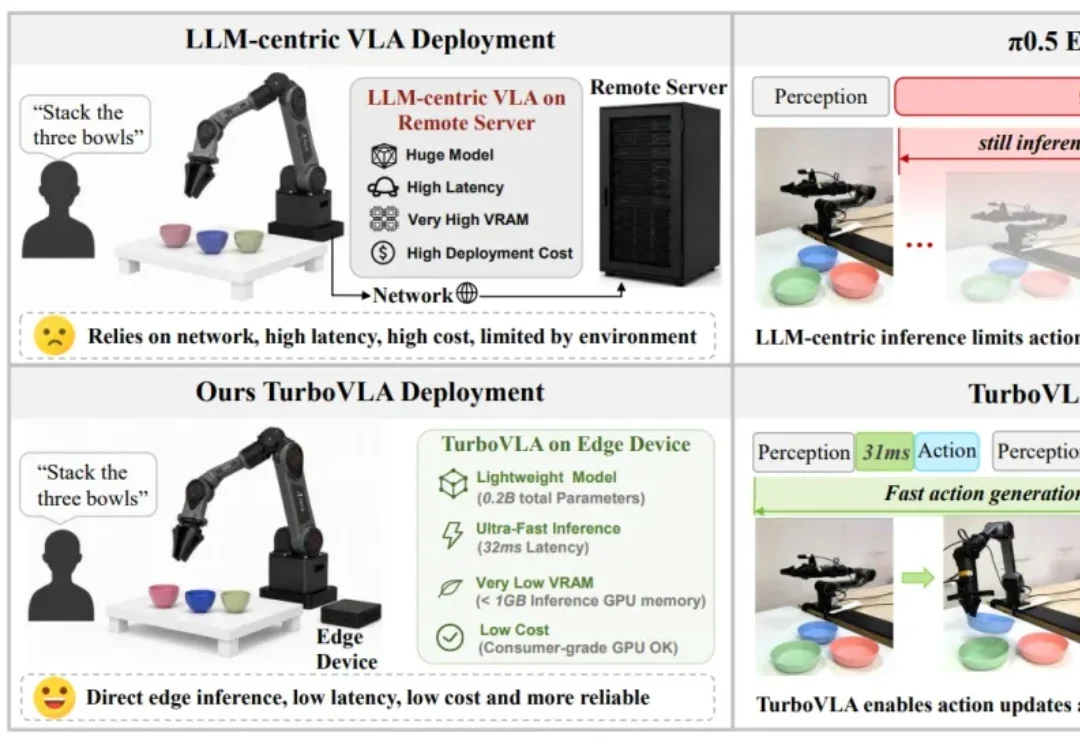
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。