三大竞赛引爆CVPR'25协作智能Workshop全方位探讨多智能体具身系统新机遇,总计1万美元奖金等你来拿
三大竞赛引爆CVPR'25协作智能Workshop全方位探讨多智能体具身系统新机遇,总计1万美元奖金等你来拿IEEE/CVF国际计算机视觉与模式识别会议(CVPR)是人工智能领域最具学术影响力的顶级会议之一,将于今年 6月11日至6月15日在美国田纳西州举行。
来自主题: AI资讯
8290 点击 2025-02-07 19:45

 搜索
IEEE/CVF国际计算机视觉与模式识别会议(CVPR)是人工智能领域最具学术影响力的顶级会议之一,将于今年 6月11日至6月15日在美国田纳西州举行。
AI的新进展频频,人才动态也愈加重磅。 新年第一则大牛人事动向,引发业内关注。 许主洪,IEEE Fellow,新加坡管理大学终身教授,被曝加盟阿里。
各位同学好,我是来自 Unlock-DeepSeek 开源项目团队的骆师傅。先说结论,我们(Datawhale X 似然实验室)使用 3 张 A800(80G) 计算卡,花了 20 小时训练时间,做出了可能是国内首批 DeepSeek R1 Zero 的中文复现版本,我们把它叫做 Datawhale-R1,用于 R1 Zero 复现教学。
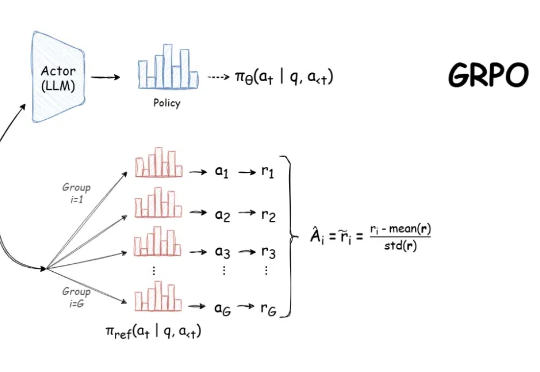
自 DeepSeek-R1 发布以来,群组相对策略优化(GRPO)因其有效性和易于训练而成为大型语言模型强化学习的热门话题。R1 论文展示了如何使用 GRPO 从遵循 LLM(DeepSeek-v3)的基本指令转变为推理模型(DeepSeek-R1)。
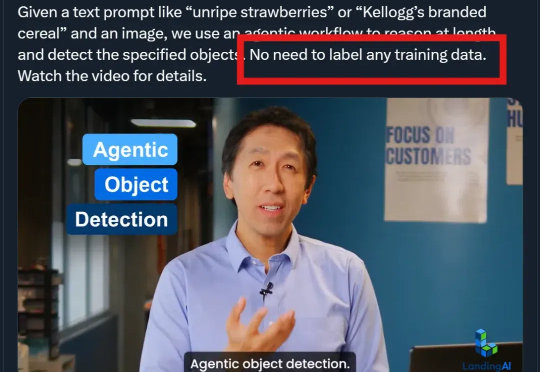
刚刚,AI大牛吴恩达官宣创业公司新成果——Agentic Object Detection
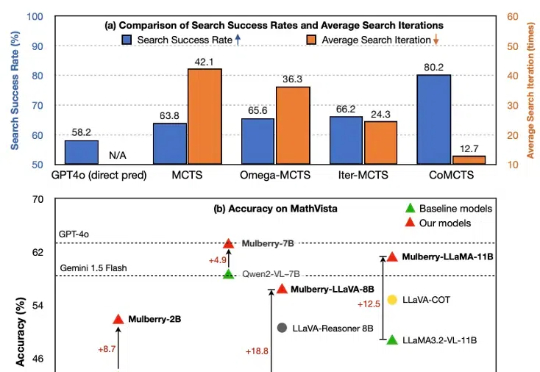
尽管多模态大语言模型(MLLM)在简单任务上最近取得了显著进展,但在复杂推理任务中表现仍然不佳。费曼的格言可能是这种现象的完美隐喻:只有掌握推理过程的每一步,才能真正解决问题。然而,当前的 MLLM 更擅长直接生成简短的最终答案,缺乏中间推理能力。本篇文章旨在开发一种通过学习创造推理过程中每个中间步骤直至最终答案的 MLLM,以实现问题的深入理解与解决。
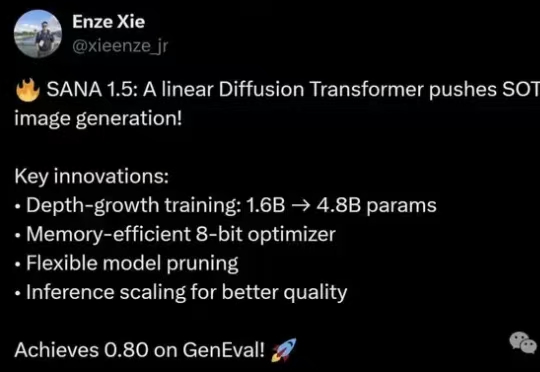
SANA 1.5是一种高效可扩展的线性扩散Transformer,针对文本生成图像任务进行了三项创新:高效的模型增长策略、深度剪枝和推理时扩展策略。这些创新不仅大幅降低了训练和推理成本,还在生成质量上达到了最先进的水平。
新一代 Kaldi 团队是由 Kaldi 之父、IEEE fellow、小米集团首席语音科学家 Daniel Povey 领衔的团队,专注于开源语音基础引擎研发,从神经网络声学编码器、损失函数、优化器和解码器等各方面重构语音技术链路,旨在提高智能语音任务的准确率和效率。
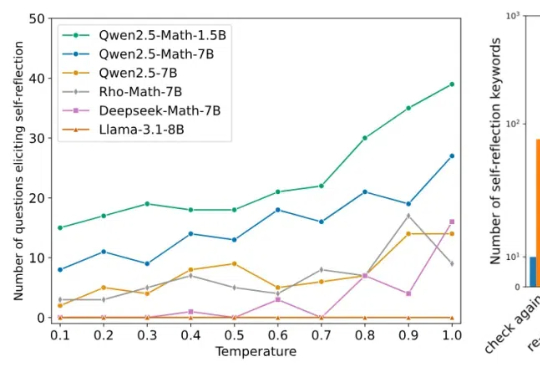
一项非常鼓舞人心的发现是:DeepSeek-R1-Zero 通过纯强化学习(RL)实现了「顿悟」。在那个瞬间,模型学会了自我反思等涌现技能,帮助它进行上下文搜索,从而解决复杂的推理问题。
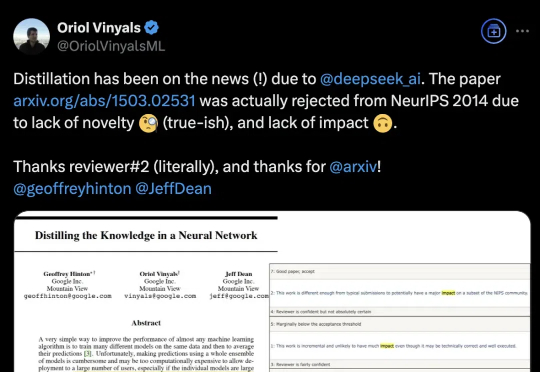
DeepSeek带火知识蒸馏,原作者现身爆料:原来一开始就不受待见。称得上是“蒸馏圣经”、由Hinton、Oriol Vinyals、Jeff Dean三位大佬合写的《Distilling the Knowledge in a Neural Network》,当年被NeurIPS 2014拒收。