
AMD跑DeepSeek性能超H200!128并发Token间延迟不超50ms,吞吐量达H200五倍
AMD跑DeepSeek性能超H200!128并发Token间延迟不超50ms,吞吐量达H200五倍DeepSeek-R1掀起新一轮购卡潮的同时,AMD的含金量也上升了。
来自主题: AI技术研报
11271 点击 2025-03-25 18:01

 搜索
DeepSeek-R1掀起新一轮购卡潮的同时,AMD的含金量也上升了。
AI界「智商大考」ARC-AGI-2重磅出炉了!一个人类用5分钟轻松解开的谜题,却让最顶尖LLM全线崩盘得分挂零,o3更是从曾经76%暴跌至4%。它正式宣告,人类还未实现AGI。
在基于物理世界的真实场景进行视觉问答时,有可能出现参考选项中没有最佳答案的情况,比如以下例子:
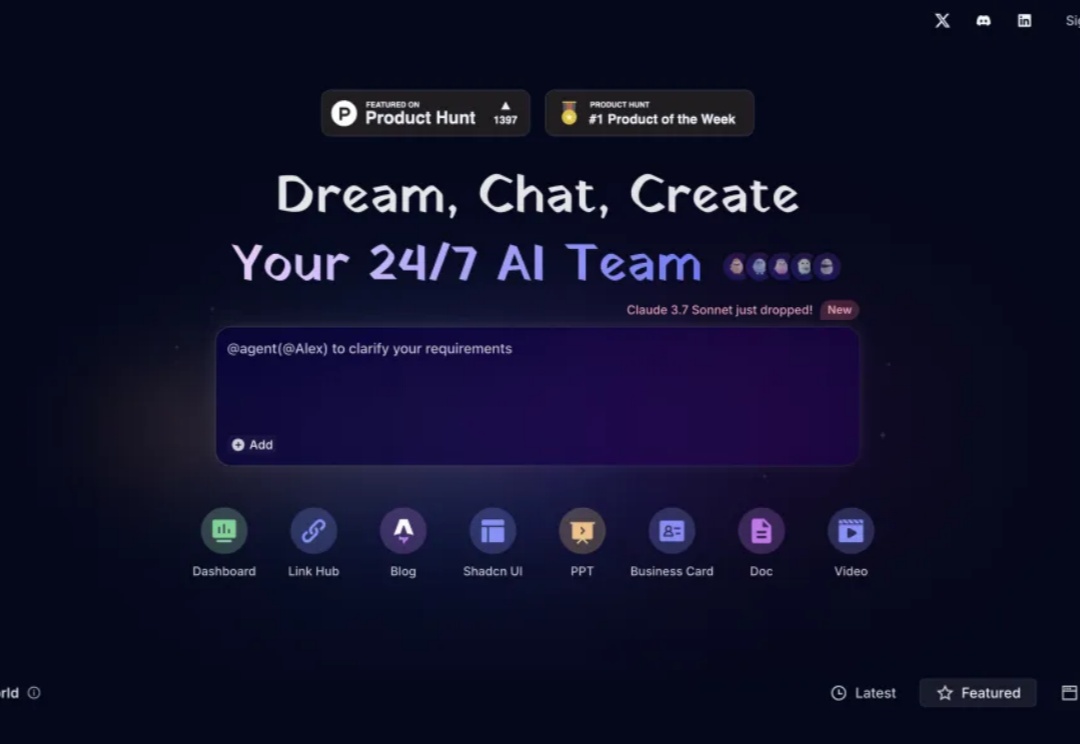
DeepWisdom完成亿元级融资,旗下智能体产品mgx.dev以零推广首月狂揽百万美元ARR,连续四周霸榜Product Hunt全球榜首。它让普通人也能一句话做出自己的APP。
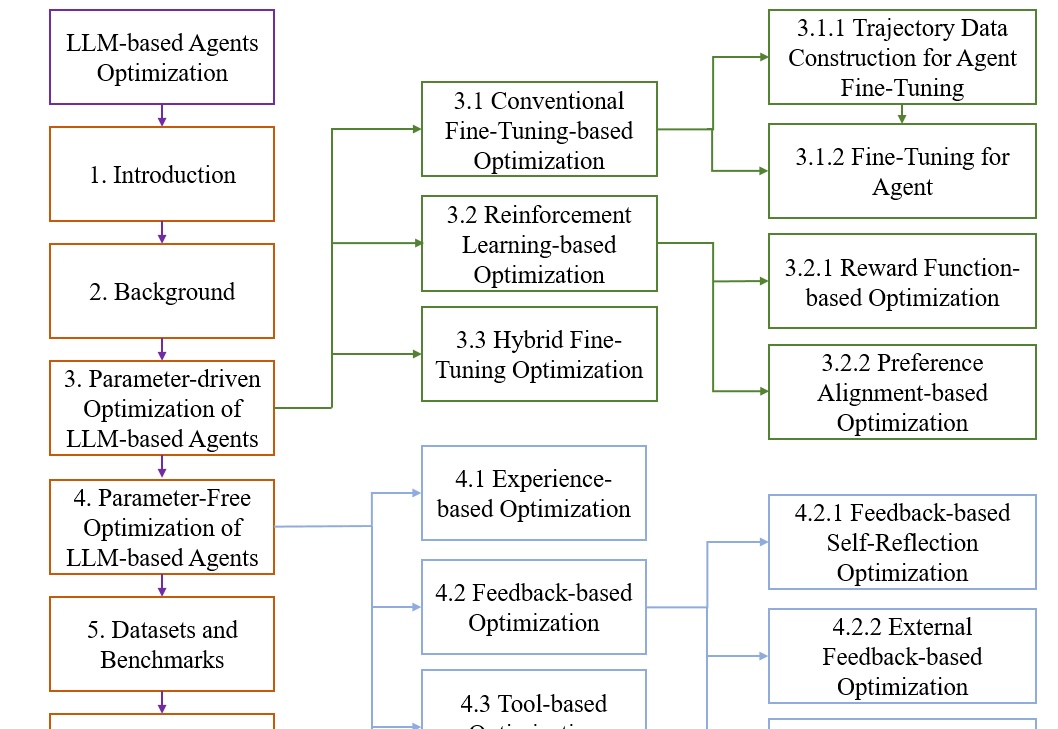
本文基于一项系统性研究《A Survey on the Optimization of Large Language Model-based Agents》,该研究由华东师大和东华大学多位人工智能领域的研究者共同完成。研究团队通过对大量相关文献的分析,构建了一个全面的LLM智能体优化框架,涵盖了从理论基础到实际应用的各个方面。您有兴趣可以找来读一下这篇综述。
据当地媒体报道,韩国 AI 应用芯片初创公司 FuriosaAI 拒绝了 Meta 的 8 亿美元收购,选择继续专注于开发和生产其 AI 芯片。
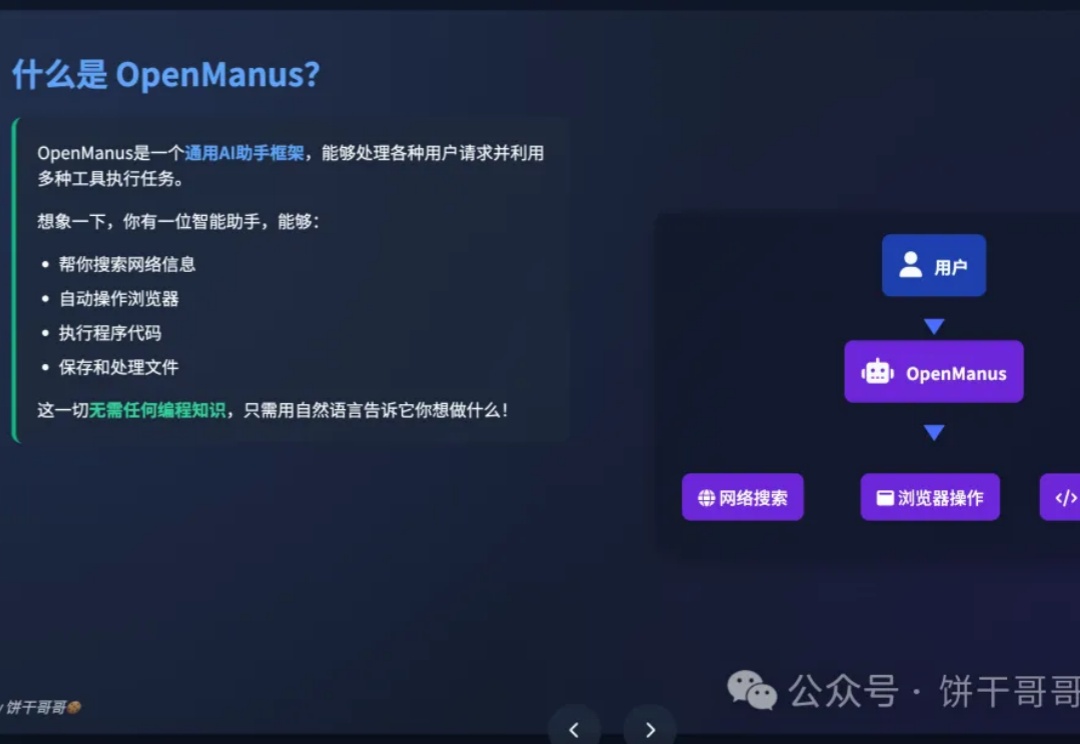
昨天我们介绍了什么是AI Agent,今天介绍一个开源的AI Agent框架,也是一号难求「Manus」的“平替”——OpenManus——曾经3小时完成Manus复刻的「神」
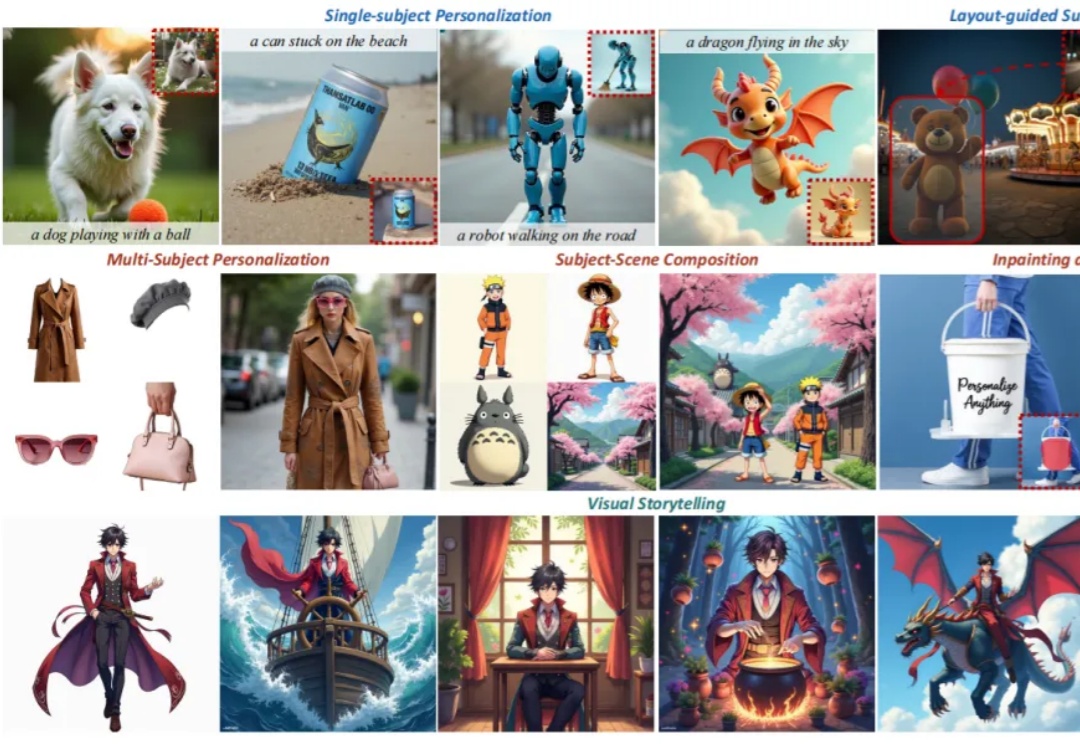
个性化图像生成是图像生成领域的一项重要技术,正以前所未有的速度吸引着广泛关注。它能够根据用户提供的独特概念,精准合成定制化的视觉内容,满足日益增长的个性化需求,并同时支持对生成结果进行细粒度的语义控制与编辑,使其能够精确实现心中的创意愿景。
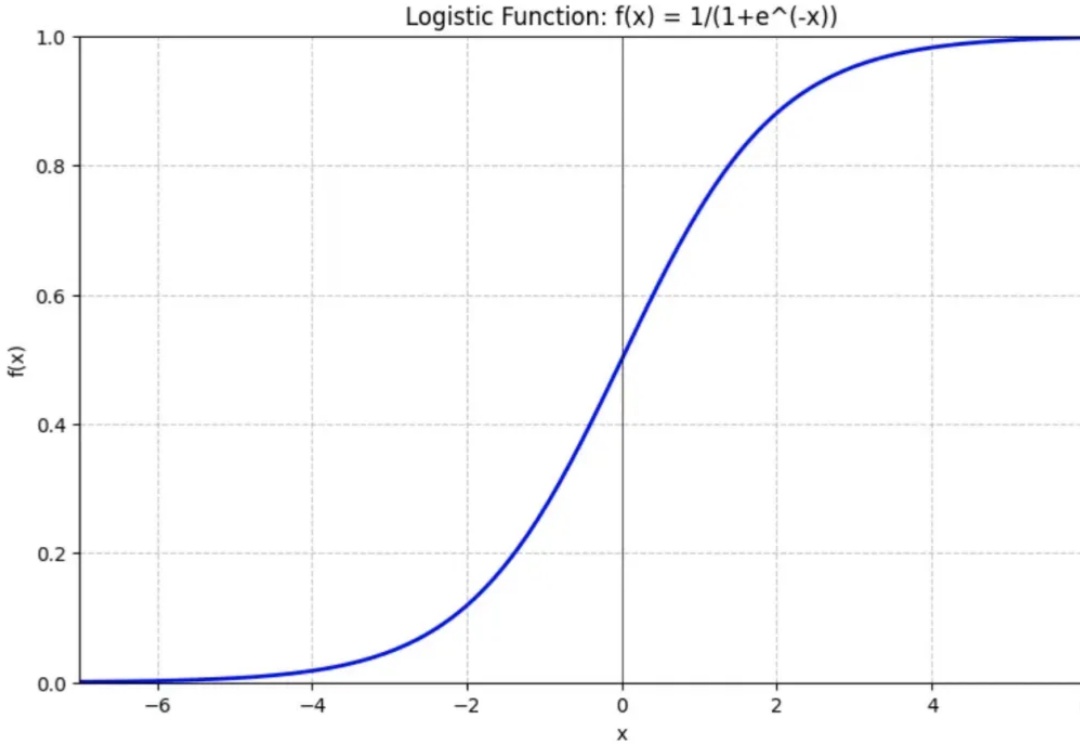
LLM本质上是一个基于概率输出的神经网络模型。但这里的“概率”来自哪里?今天我们就来说说语言模型中一个重要的角色:Softmax函数。(相信我,本文真的只需要初等函数知识)
开发者工具正在随着 AI 的快速发展而改变。因此,那些在其工作流程中更容易采用 AI 的公司正受到广泛关注。2022 年,一家名为 n8n(发音为“enay-ten”)的初创公司将其工作流自动化平台转向更加 AI 友好,该公司表示其收入增长了 5 倍,仅在过去两个月就翻了一番。