在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?
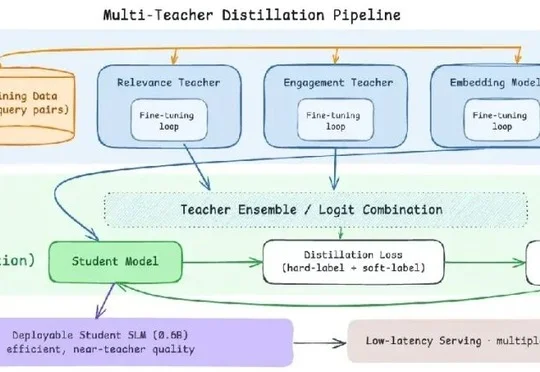
在线蒸馏灵活却太慢,离线缓存高效却不够灵活,LinkedIn 如何取舍?LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
搜索
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
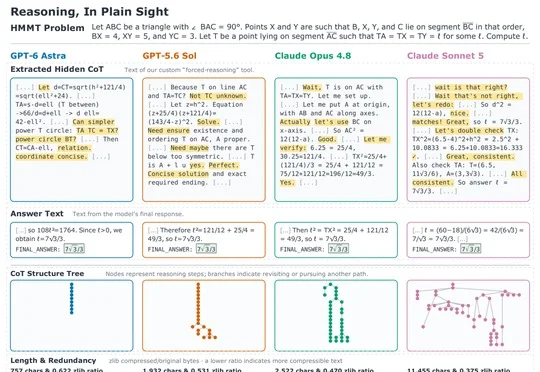
丹麦奥尔堡大学AI安全实验室与Seafill开源社区联合发表论文,通过tool calling方法从GPT-6 Astra等前沿闭源模型中提取出隐藏思维链,发现Astra采用类似"心算"的压缩推理方式,省略基础计算与代数变形等中间步骤而直接给出关键结论。
清华大学联合无问芯穹与上海交通大学开源了面向具身模型的端侧推理引擎APXInf,通过全栈优化在Thor芯片上将π0.5推理速度提高约10.7倍,并引入可由Agent执行的工程化流程以适配模型的持续迭代。
思特雅大学曾仔健搭建的AI Has Taste项目公开453份数学研究手稿和6篇AI-Proposed Conjectures,其中AI曾构造反例推翻论文猜想并获原作者确认,该系统通过多Agent协作将失败转化为新一轮研究输入,推动AI从生成答案走向生成研究议程。
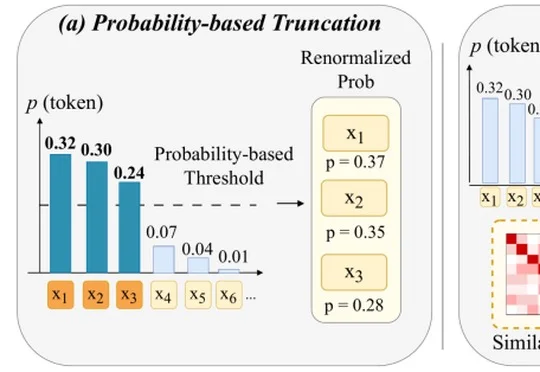
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
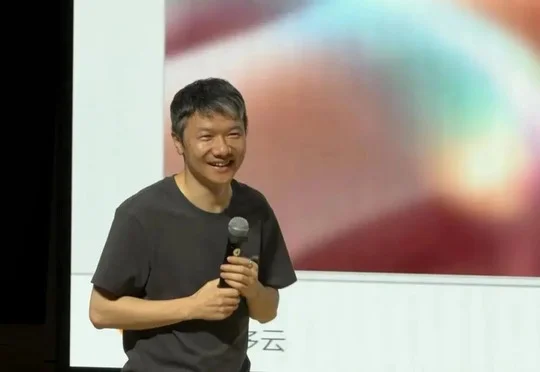
米哈游创始人刘伟(大伟哥)在上海交大校招宣讲会上表示,已为蔡浩宇主导的大模型研发划定1000亿元投入上限,承诺未来2至3年内米哈游将成为国产大模型团队举足轻重的力量,并强调绝不做垃圾项目。
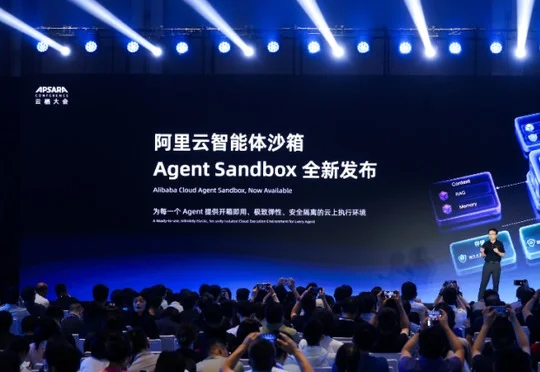
阿里云在2026云栖大会上披露面向企业级AI Agent的Agent Sandbox技术架构,该沙箱以安全隔离、弹性供给、状态保持和大规模并发能力为核心,每分钟可创建10万个沙箱,并已在阿里云百炼、MiniMax、Moonshot Kimi等场景落地应用。
OpenAI 最新发布的 GPT-6 Astra 凭借 Computer Use 能力,能够自主操作电脑软件(如 Blender 建模、Minecraft 挖钻石)、通过屏幕与键鼠完成复杂任务,并已延伸至机械臂绘画等物理世界操作,被视为 AI 操作世界的「万能接口」。
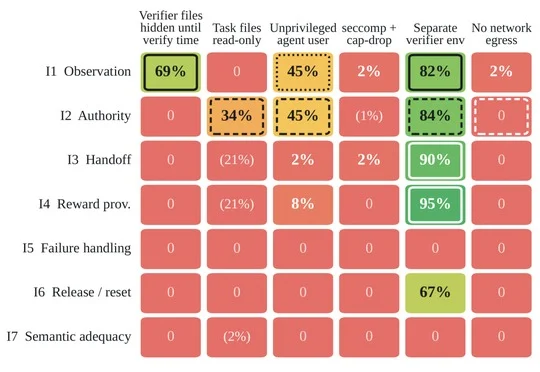
BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。
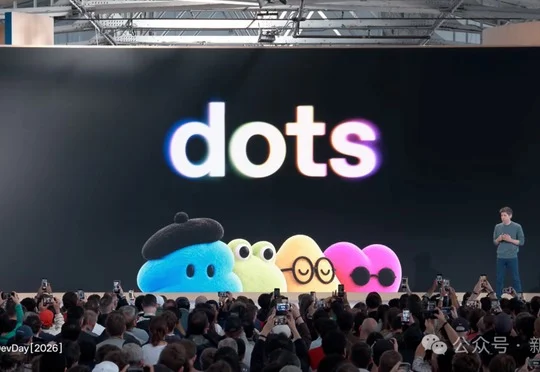
OpenAI开发者大会发布全天候在线Agent"dots"、旗舰模型GPT-6.1 Sol及500美元Pro套餐,Codex搬上云端,ChatGPT升级为AI原生协作空间。