字节Seed:大概念模型来了,推理的何必是下一个token
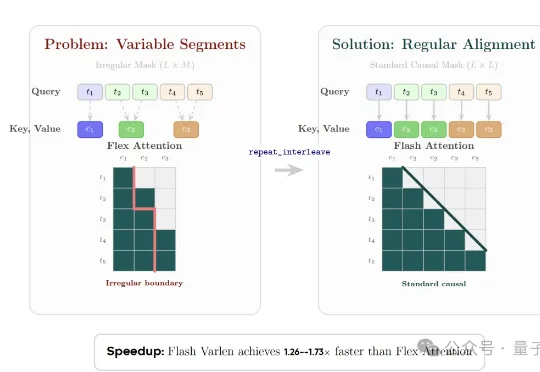
字节Seed:大概念模型来了,推理的何必是下一个tokenLLM的下一个推理单位,何必是Token?刚刚,字节Seed团队发布最新研究——DLCM(Dynamic Large Concept Models)将大模型的推理单位从token(词) 动态且自适应地推到了concept(概念)层级。
来自主题: AI技术研报
11101 点击 2026-01-04 21:01

 搜索
LLM的下一个推理单位,何必是Token?刚刚,字节Seed团队发布最新研究——DLCM(Dynamic Large Concept Models)将大模型的推理单位从token(词) 动态且自适应地推到了concept(概念)层级。
你有没有发现,你让AI读一篇长文章,结果它读着读着就忘了前面的内容? 你让它处理一份超长的文档,结果它给出来的答案,牛头不对马嘴? 这个现象,学术界有个专门的名词,叫做上下文腐化。 这也是目前AI的通病:大模型的记忆力太差了,文章越长,模型越傻!
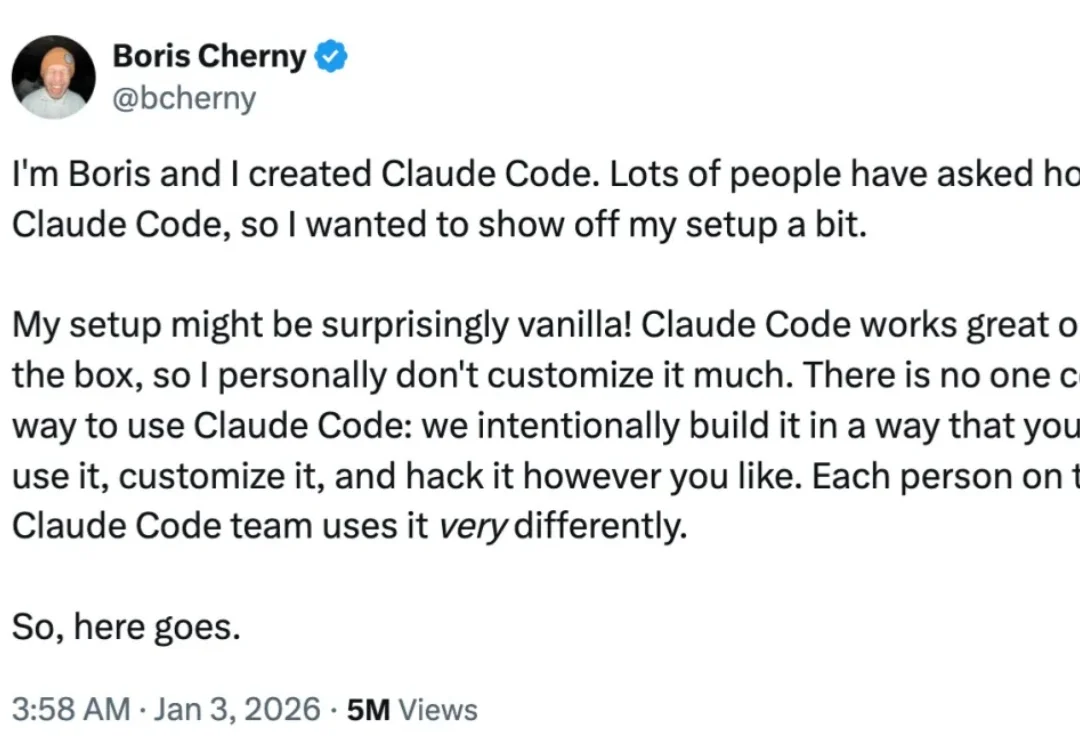
2026 新年第三天,Claude Code 创建者、负责人 Boris Cherny 开展「线上教学」,亲自示范他自己使用这个 AI 编程工具的工作流。
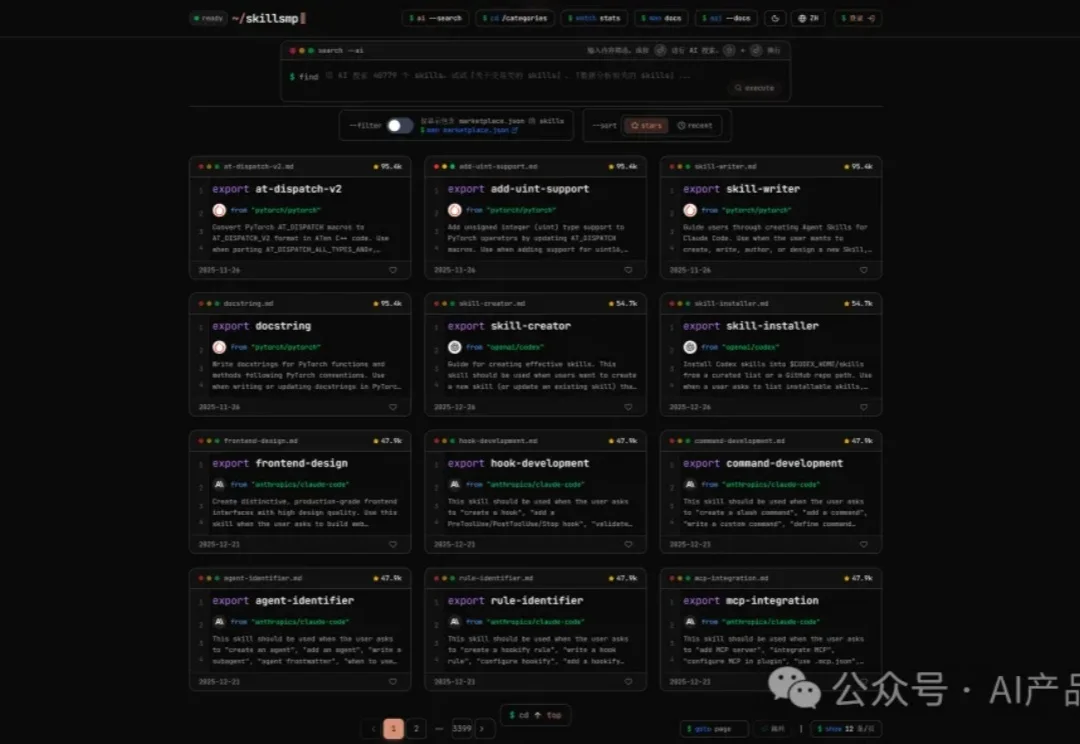
最近火的一塌糊涂的 Skills 很多群友在问是啥东东
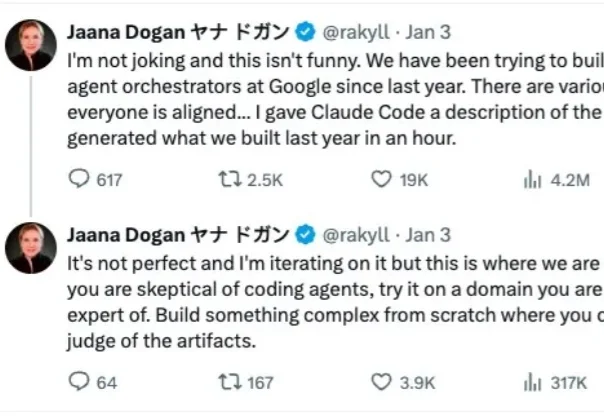
一位谷歌资深工程师透露,Anthropic 的 Claude Code 用一小时跑出了她团队打磨了一年的系统。
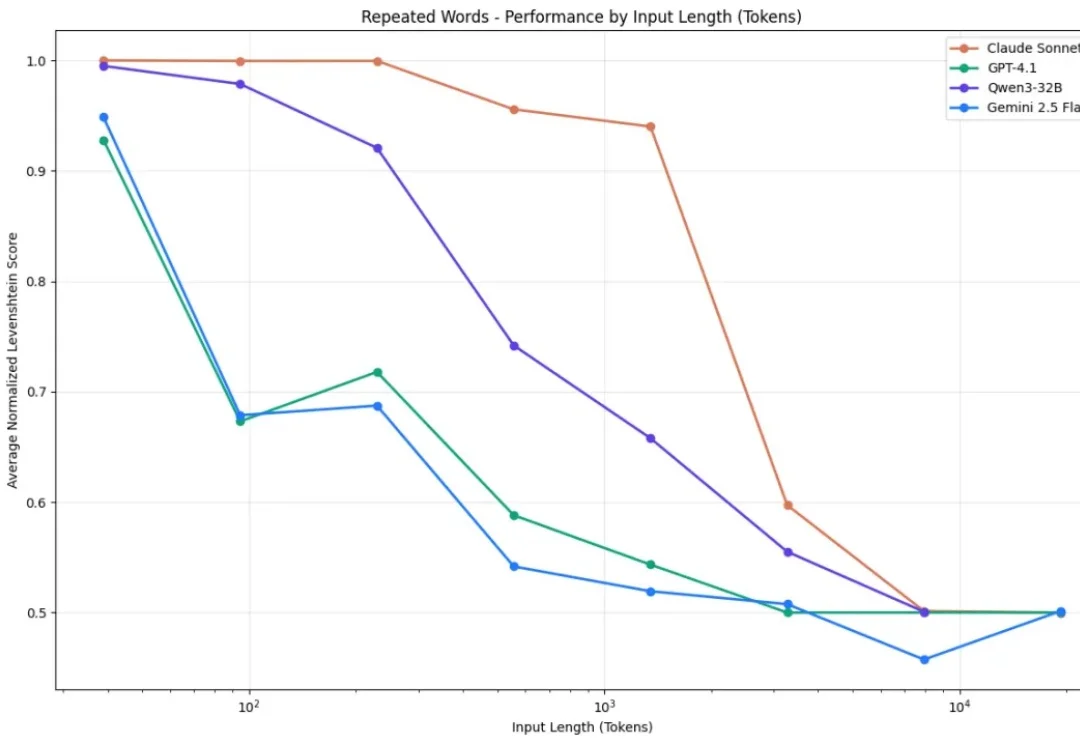
新年伊始,MIT CSAIL 的一纸论文在学术圈引发了不小的讨论。Alex L. Zhang 、 Tim Kraska 与 Omar Khattab 三位研究者在 arXiv 上发布了一篇题为《Recursive Language Models》的论文,提出了所谓“递归语言模型”(Recursive Language Models,简称 RLM)的推理策略。
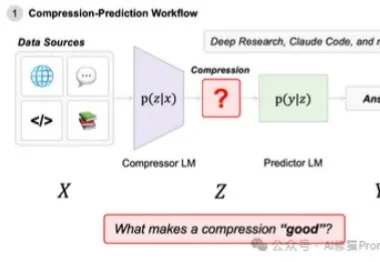
在近一年里,Agentic System(代理系统/智能体系统)正变得无处不在。从Open AI的Deep Research到Claude Code,我们看到越来越多的系统不再依赖单一模型,而是通过多模型协作来完成复杂的长窗口任务。
近日,腾讯微信 AI 团队提出了 WeDLM(WeChat Diffusion Language Model),这是首个在工业级推理引擎(vLLM)优化条件下,推理速度超越同等 AR 模型的扩散语言模型。
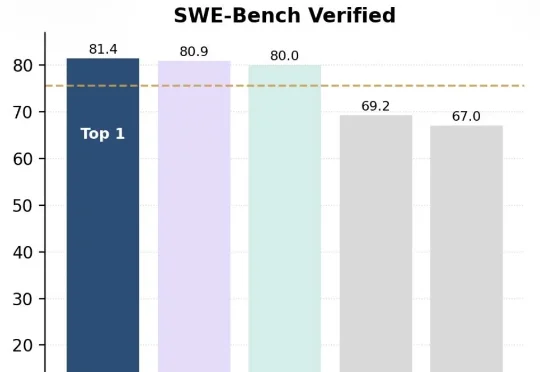
又一个中国新模型被推到聚光灯下,刷屏国内外科技圈。IQuest-Coder-V1模型系列,看起来真的很牛。在最新版SWE-Bench Verified榜单中,40B参数版本的IQuest-Coder取得了81.4%的成绩,这个成绩甚至超过了Claude Opus-4.5和GPT-5.2(这俩模型没有官方资料,但外界普遍猜测参数规模在千亿-万亿级)。

在 《我招了 6 个 AI 员工一起干活》 一文中,我介绍了如何招聘 6 个 AI 员工,并让他们在同一个工作间一起干活。招聘 AI 员工,我最希望他们帮我干的就是编程相关的活。在给他们具体的任务之前,先评估一下他们的能力。