AI资讯新闻榜单内容搜索-ODE

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: ODE
刚刚!Claude Fable 5,又拿第一了

刚刚!Claude Fable 5,又拿第一了

刚刚!Claude Fable 5,又拿第一了

Claude这次,真把AI编程榜单打出断层了!就在刚刚刷新的MirrorCode排行榜上,Claude Fable 5以64%的绝对成功率再次登顶。 排在第四的GPT-5.5更惨。不仅成绩只有10%,甚至还被自家前辈GPT-5.4按在地上摩擦。

来自主题: AI资讯
9607 点击    2026-08-04 12:24
从零开始,教你用Codex搓出属于你自己的第一个硬件。

从零开始,教你用Codex搓出属于你自己的第一个硬件。

从零开始,教你用Codex搓出属于你自己的第一个硬件。

前两天,我发了一个视频。 大概就是我搓了一个小硬件,就是一个用来提醒我久坐的猫爪。
来自主题: AI资讯
8376 点击    2026-08-04 11:24
给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!

给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!

给 Codex 和 Claude Code 接入 DeepSeek-V4-Flash,夯爆了!

其实 Codex 和 Claude Code 都支持切换模型,咱们直接用 DeepSeek-V4-Flash 来驱动它们就行,量大管饱、不用魔法、也不怕封号。而且现在 DeepSeek 官方已经做了原生适配,接入流程比以前简单多了。
来自主题: AI资讯
10881 点击    2026-08-03 16:14
Codex + Obsidian 搭本地知识库:273 篇笔记 27 天实录

Codex + Obsidian 搭本地知识库:273 篇笔记 27 天实录

Codex + Obsidian 搭本地知识库:273 篇笔记 27 天实录

7 月初的时候,我照着 Karpathy 那套 LLM Wiki(简单说就是让 AI 帮你把资料编译成一个能长大的百科)搭了个本地知识库。
来自主题: AI技术研报
7696 点击    2026-08-03 15:53
VLA动作预测必须经过LLM吗?TurboVLA仅0.2B参数,RTX 4090上跑出32Hz在线动作预测

VLA动作预测必须经过LLM吗?TurboVLA仅0.2B参数,RTX 4090上跑出32Hz在线动作预测

VLA动作预测必须经过LLM吗?TurboVLA仅0.2B参数,RTX 4090上跑出32Hz在线动作预测

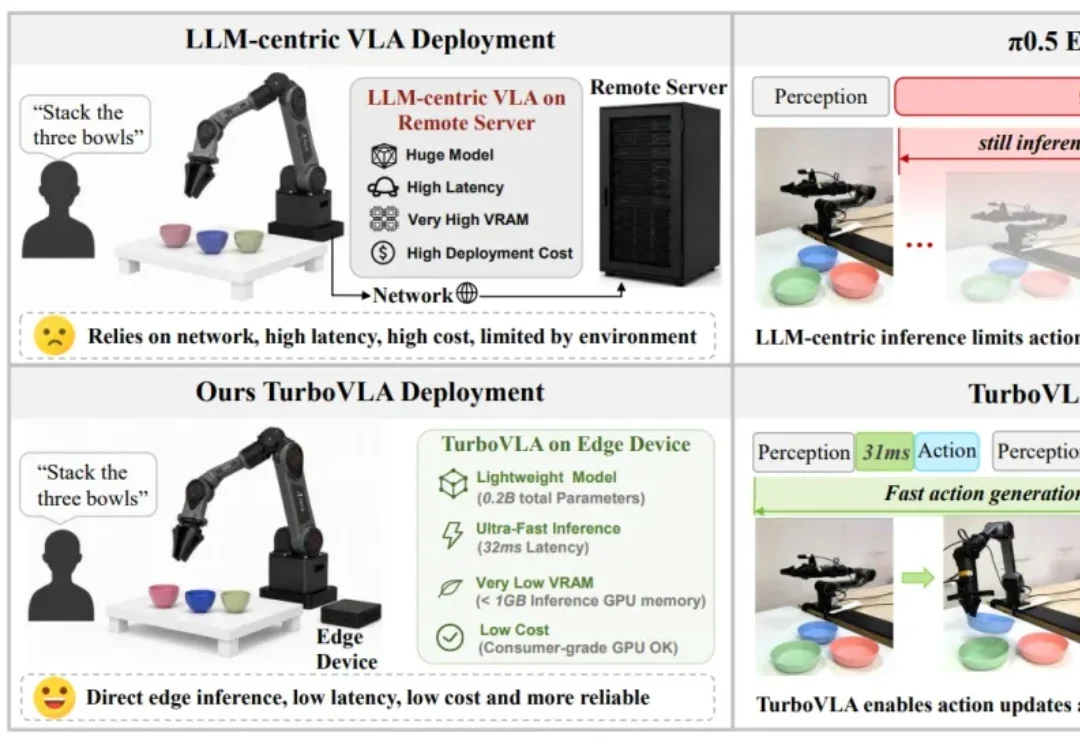
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
来自主题: AI技术研报
10999 点击    2026-08-03 15:30
赛博义父Tibo爆料:谷歌早一年就做出了ChatGPT,硬是没敢发!

赛博义父Tibo爆料:谷歌早一年就做出了ChatGPT,硬是没敢发!

赛博义父Tibo爆料:谷歌早一年就做出了ChatGPT,硬是没敢发!

Jay 发自 凹非寺 量子位 | 公众号 QbitAI 啥,谷歌真比OpenAI还早一年搞出了ChatGPT? 不是谷歌事后找补了,这次是OpenAI自己人,Codex负责人Tibo刚佐证的消息: 那
来自主题: AI资讯
9529 点击    2026-08-03 12:27
80亿参数记性不如U盘:他算出了大模型记忆天花板

80亿参数记性不如U盘:他算出了大模型记忆天花板

80亿参数记性不如U盘:他算出了大模型记忆天花板

一个80亿参数的大模型,一口气吞下15万亿token的训练数据,堆到硬盘上差不多7TB。可它真正「背」得下来的,少得可怜:每个参数只装得下3.6 bit。一个英文字母8 bit,连半个都填不满。
来自主题: AI技术研报
9976 点击    2026-08-02 22:14
清华团队VeriLoop Coder-E1正式开源:以循证螺旋驱动可验证的递归式自我改进

清华团队VeriLoop Coder-E1正式开源:以循证螺旋驱动可验证的递归式自我改进

清华团队VeriLoop Coder-E1正式开源:以循证螺旋驱动可验证的递归式自我改进

近日,由清华大学深圳国际研究生院智能机器人实验室刘厚德教授领衔、王立博博士后担任 AI 首席研究员的大模型团队,正式发布了 VeriLoop Coder-E1—— 一款基于 Qwen3.6-27B 构建、面向仓库级代码修复与智能体式软件工程任务的开源垂类代码模型。
来自主题: AI技术研报
9675 点击    2026-08-02 13:44
生成模型也能端到端训练了?核心竟是一个for循环

生成模型也能端到端训练了?核心竟是一个for循环

生成模型也能端到端训练了?核心竟是一个for循环

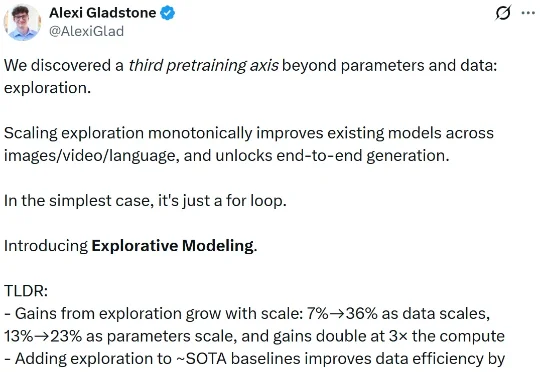
最近,一篇来自 UIUC 与哈佛大学的论文,试图把这块最后的拼图补上。作者给这个新范式起了个名字,叫 Explorative Modeling(探索式建模),模型简称 XM。它的想法简单到近乎朴素,却指向一个大胆的结论:生成模型除了参数和数据,其实还有第三根可以放大的轴。
来自主题: AI技术研报
8354 点击    2026-08-02 11:16
Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

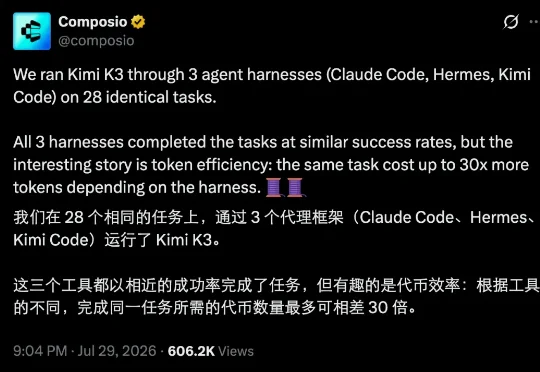
最近有个挺有意思的对比实验,来自 Composio 团队。他们用同一个模型 Kimi K3,分别放进三个不同的 agent 框架(harness)里跑 ——Claude Code、Hermes 和 Kimi Code—— 一共测了 28 个完全相同的任务。

来自主题: AI资讯
10918 点击    2026-08-01 11:06