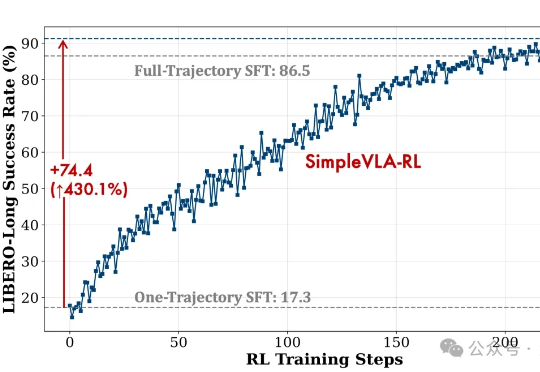
缺数据也能拿SOTA?清华&上海AI Lab破解机器人RL两大瓶颈
缺数据也能拿SOTA?清华&上海AI Lab破解机器人RL两大瓶颈视觉-语言-动作模型是实现机器人在复杂环境中灵活操作的关键因素。然而,现有训练范式存在一些核心瓶颈,比如数据采集成本高、泛化能力不足等。
来自主题: AI技术研报
9631 点击 2025-09-27 11:13

 搜索
视觉-语言-动作模型是实现机器人在复杂环境中灵活操作的关键因素。然而,现有训练范式存在一些核心瓶颈,比如数据采集成本高、泛化能力不足等。
两年过去,ElevenLabs 已经融资 2.6 亿美元,网站访问量超 2500 万,稳坐 AI Web 全球 Top50 榜单,成为 AI 语音赛道的头部创企。而 Speechify 却渐渐“掉队”,榜单中难觅身影,而作为一个 AI 企业,它仅在 2017 和 2020 年有过两次融资,近几年也没有传出任何融资消息。
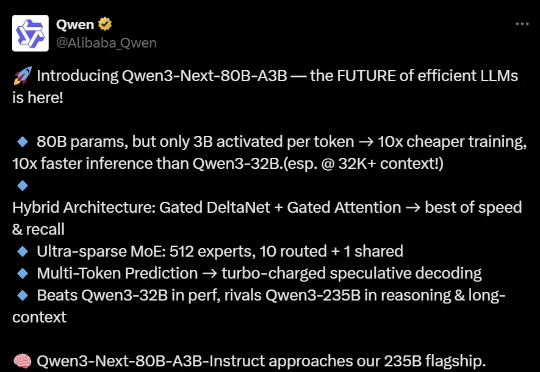
训练、推理性价比创新高。 大语言模型(LLM),正在进入 Next Level。 周五凌晨,阿里通义团队正式发布、开源了下一代基础模型架构 Qwen3-Next。总参数 80B 的模型仅激活 3B ,性能就可媲美千问 3 旗舰版 235B 模型,也超越了 Gemini-2.5-Flash-Thinking,实现了模型计算效率的重大突破。
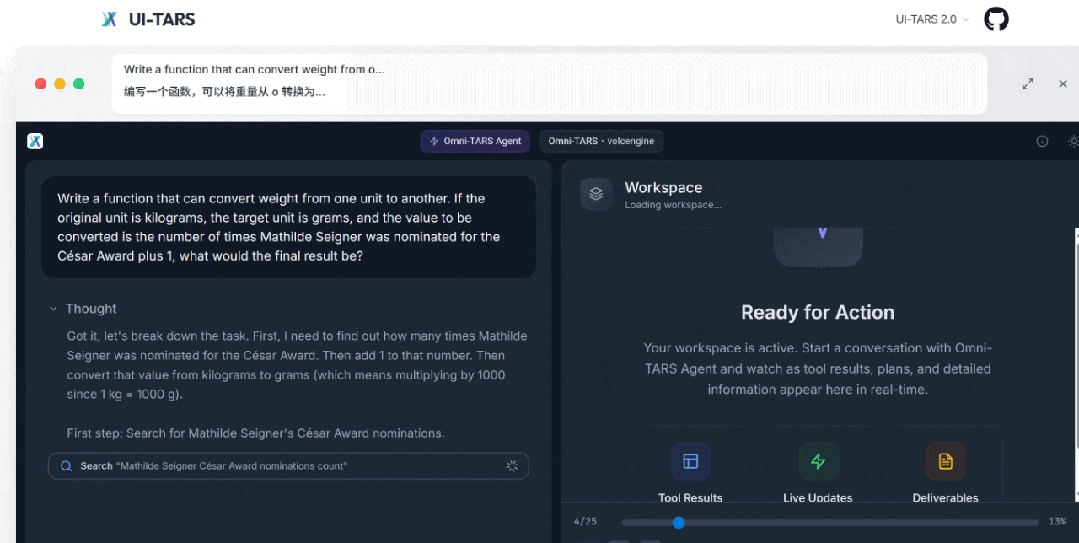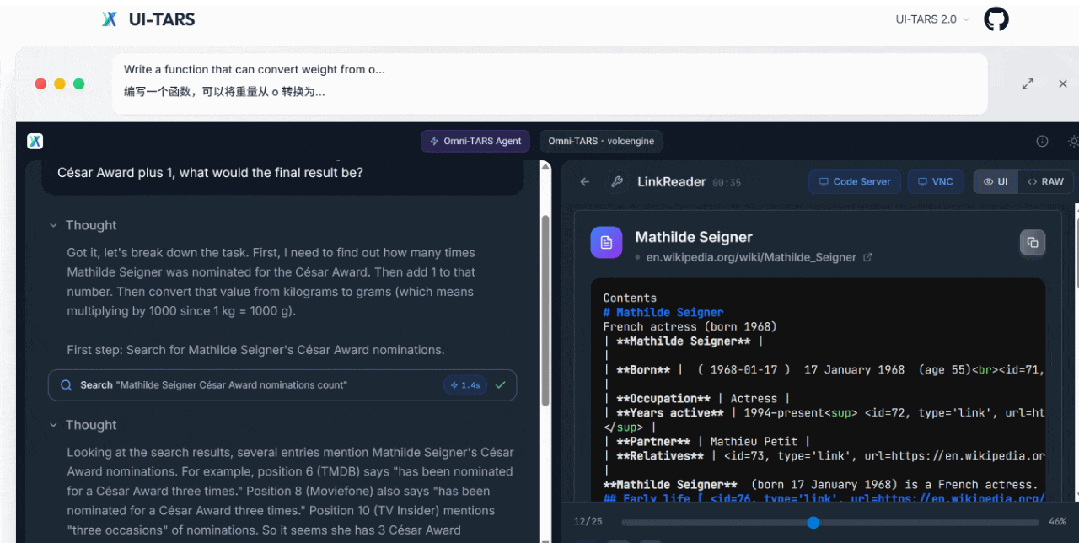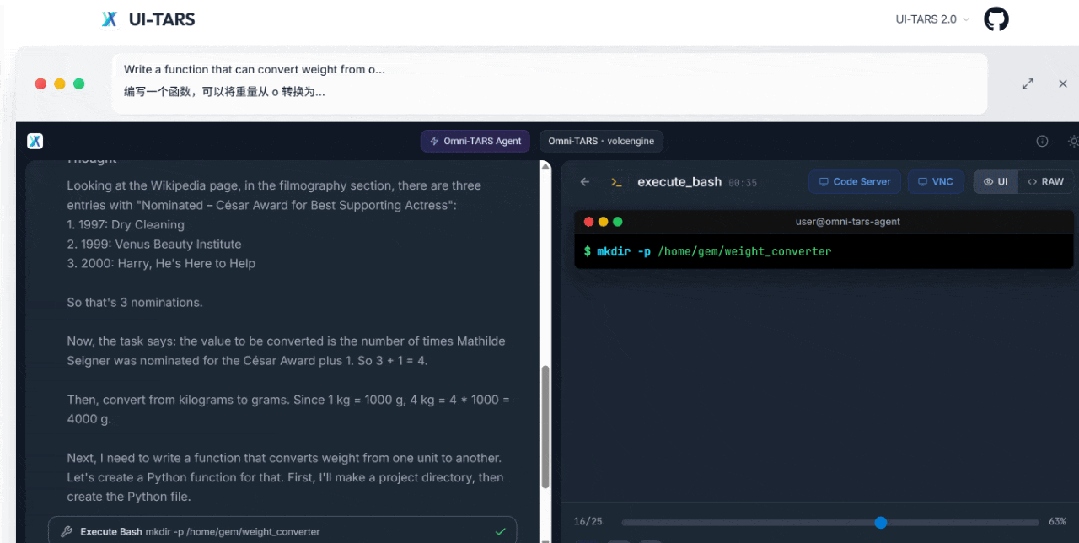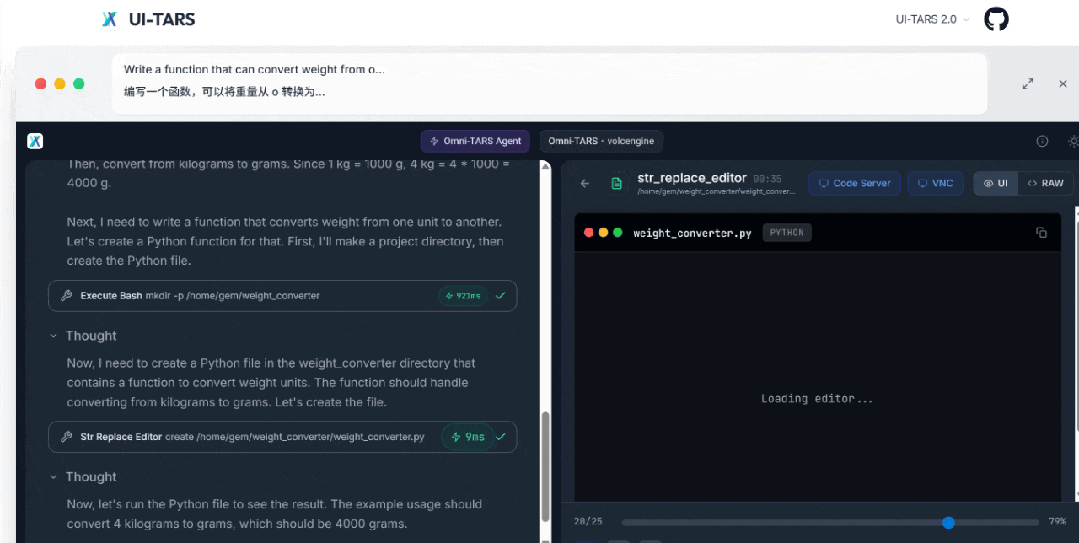
AI自己玩手机、玩电脑、操作网页浏览器……背后还只靠一个模型。 卷王字节Seed又把智能体带到了一个全新level~
订阅了 ElevenLabs 的小伙伴看过来,它的开源平替来了!Chatterbox 是全球首个支持强烈情绪控制的开源TTS 模型,更是号称开源 TTS 中的 SOTA ,由 Resemble AI 推出。
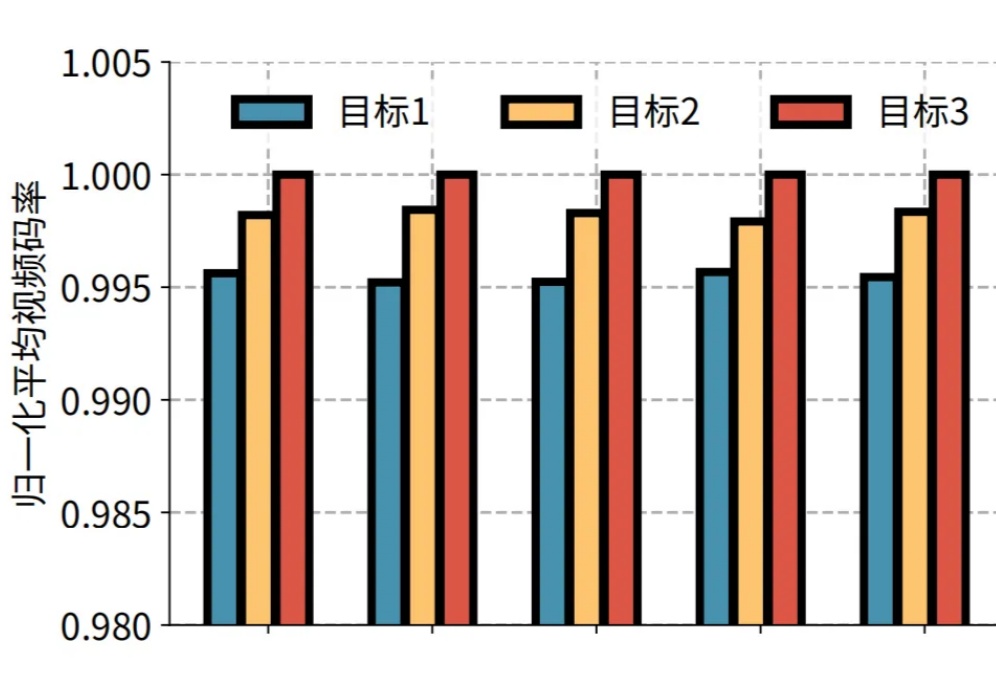
近日,快手与清华大学孙立峰团队联合发表论文《Towards User-level QoE: Large-scale Practice in Personalized Optimization of Adaptive Video Streaming》,被计算机网络领域的国际顶尖学术会议 ACM SIGCOMM 2025 录用。
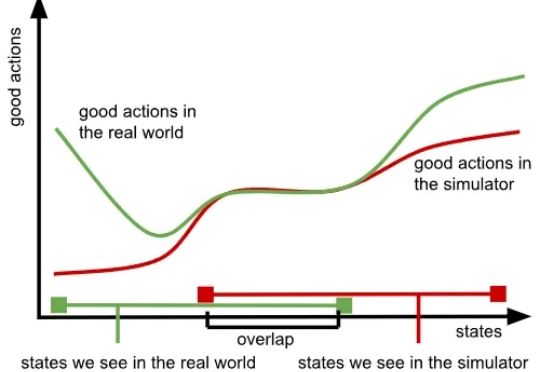
我们知道,训练大模型本就极具挑战,而随着模型规模的扩大与应用领域的拓展,难度也在不断增加,所需的数据更是海量。大型语言模型(LLM)主要依赖大量文本数据,视觉语言模型(VLM)则需要同时包含文本与图像的数据,而在机器人领域,视觉 - 语言 - 行动模型(VLA)则要求大量真实世界中机器人执行任务的数据。
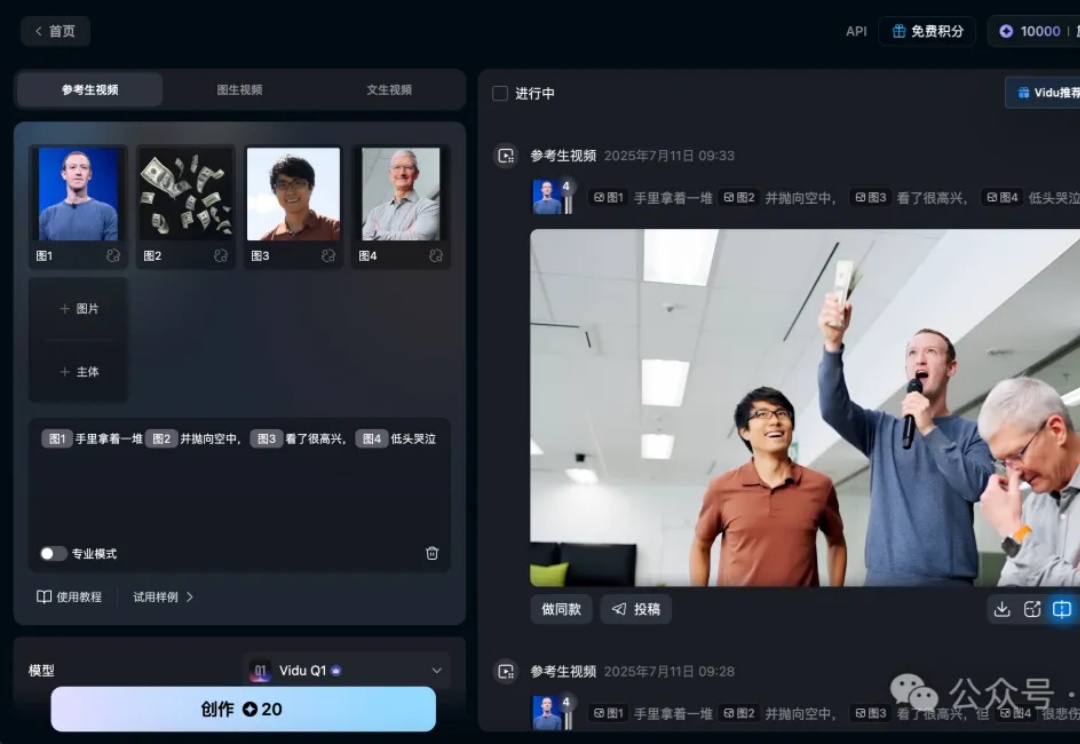
不再是你以为的AI视频生成,国产AI已经开启下一个Level了。
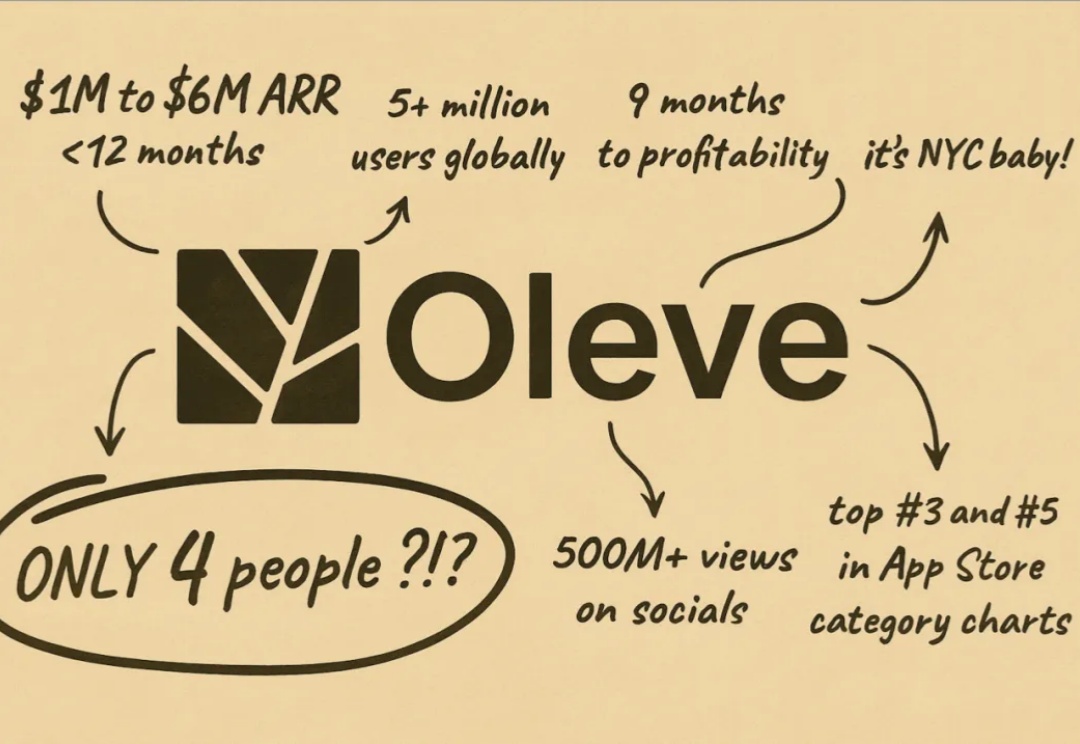
你有没有想过,一家只有四个员工的公司,能做到年收入600万美元?这听起来像是天方夜谭,但 Oleve 正在让这个看似不可能的故事成为现实。我最近深入研究了这家由 Sid Bendre 领导的创业公司,发现了一个令人震撼的事实:他们不仅实现了这个惊人的财务数据,还在短短两年内服务了超过500万用户,从第九个月开始就实现了盈利。
就在刚刚,Ilya出现了!他大义凛然发文,自封为SSI唯一CEO,而Daniel Levy将担任总裁。要实现SSI的梦想,多少钱都不卖。