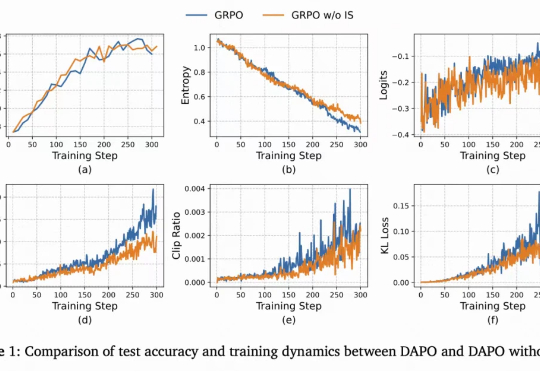
「重要性采样」并不「重要」?快手清华ASPO攻克重要性采样权重错配
「重要性采样」并不「重要」?快手清华ASPO攻克重要性采样权重错配从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
来自主题: AI技术研报
9288 点击 2025-10-18 11:41

 搜索
从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
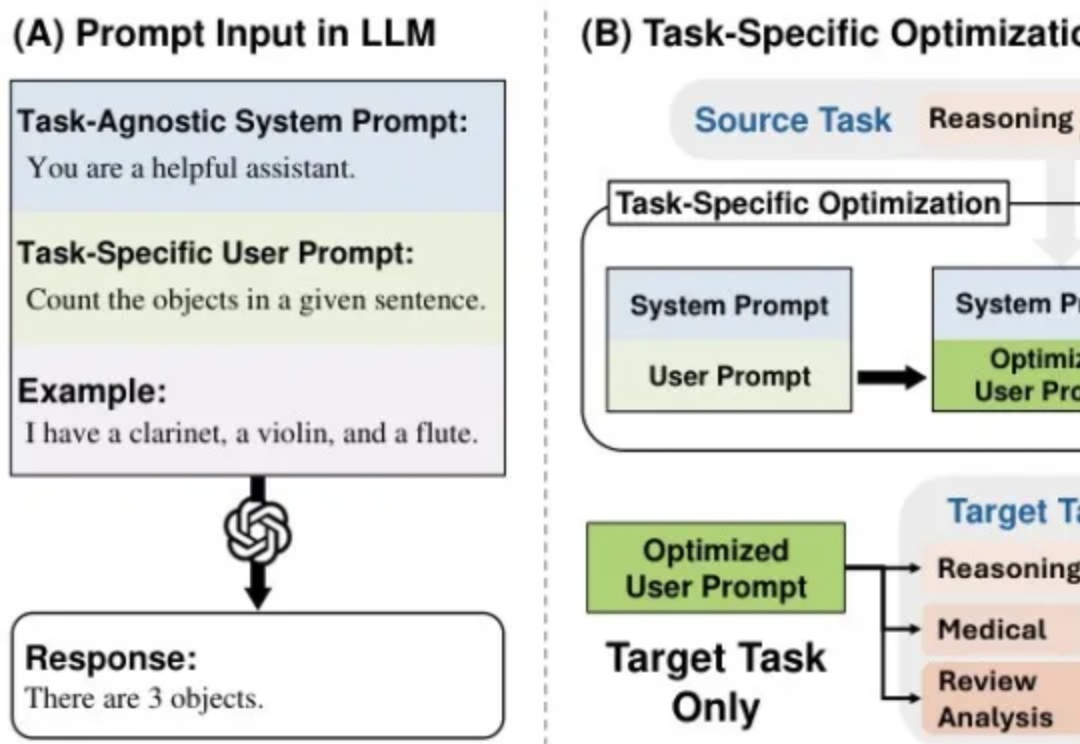
每次更换语言模型就要重新优化提示词?资源浪费且效率低下!本文介绍MetaSPO框架,首个专注模型迁移系统提示优化的元学习方法,让一次优化的提示可跨模型通用。我在儿童教育场景的实验验证了效果:框架自动生成了五种不同教育范式的系统提示,最优的"苏格拉底式"提示成功由DeepSeek-V3迁移到通义千问模型,评分从0.3920提升至0.4362。
2020年AlphaFold2横空出世横扫CASP14,彻底改变了AI+生物学。
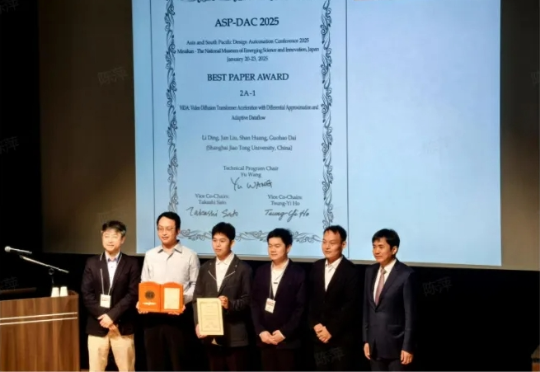
由无问芯穹与上海交通大学联合研究团队提出的视频生成软硬一体加速器,首次实现通过差分近似和自适应数据流解决 VDiT 生成速度缓慢瓶颈,推理速度相比 A100 提升高达 16.44 倍。

据 TechCrunch 报道,Raspberry 筹集了 2400 万美元的 A 轮融资,由 Andreessen Horowitz 主导,现有投资者 Greycroft、Correlation Ventures 和 MVP Ventures 参与。
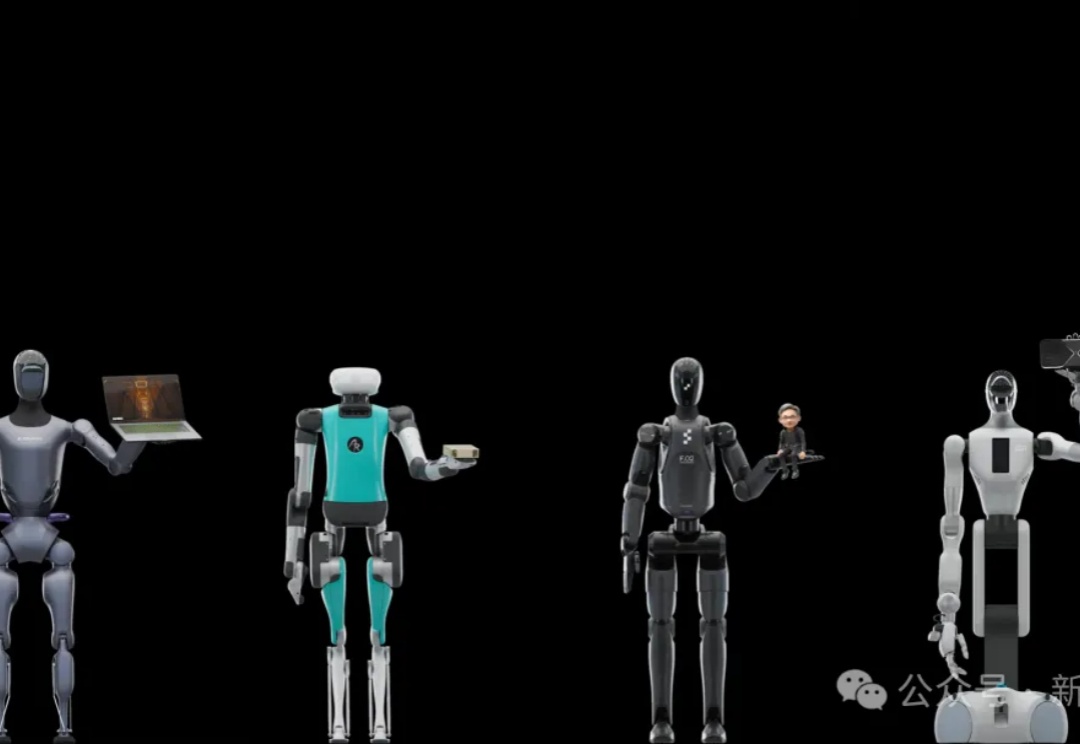
今天,银河通用机器人发布了端到端具身抓取基础大模型「GraspVLA」,全球第一个预训练完全基于仿真合成大数据的具身大模型,展现出了比OpenVLA、π0、RT-2、RDT等模型更全面强大的泛化性和真实场景实用潜力。
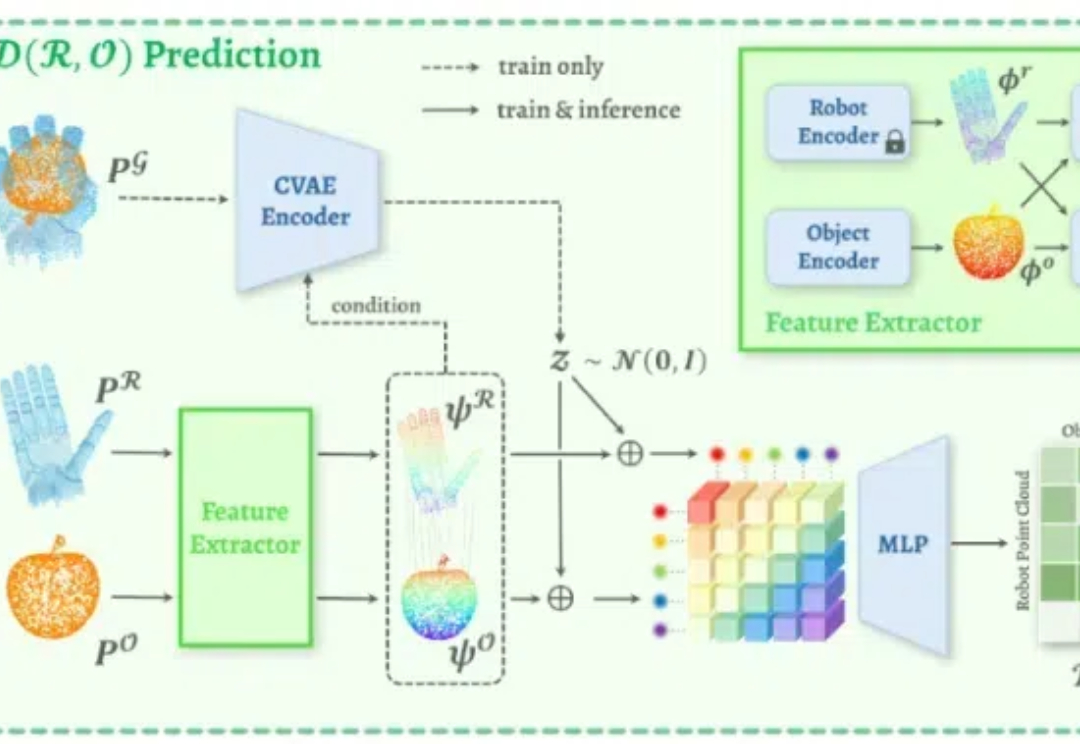
近期,新加坡国立大学计算机学院的邵林团队提出了 D(R,O) Grasp:一种面向跨智能体灵巧抓取的机器人与物体交互统一表示。该方法通过创新性地建模机器人手与物体在抓取姿态下的交互关系,成功实现了对多种机器人手型与物体几何形状的高度泛化能力,为灵巧抓取技术的未来开辟了全新的方向。
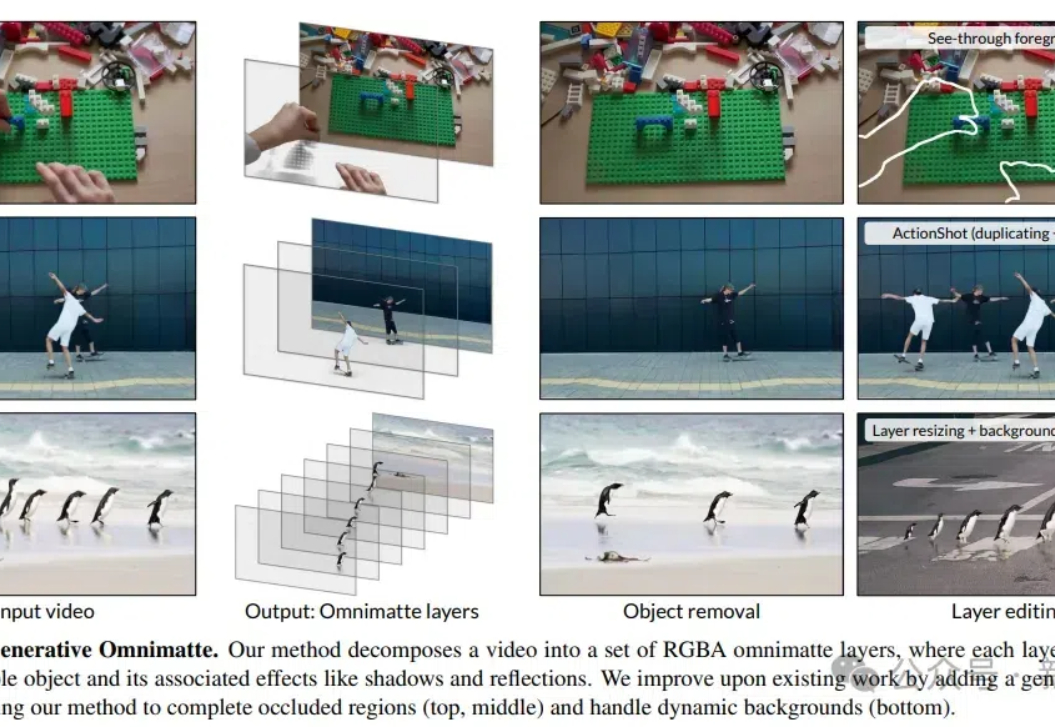
DeepMind的研究人员开发了一种视频分层新方法,可以无需假设背景静止或精确的相机姿态,就能将视频分解成包含物体及其效果(如阴影和反射)的多个层,提升了视频编辑的灵活性和效率。

众所周知,视频的抠图相当麻烦,要是有大面积频繁的抠图需求,还得布置绿幕进行后期PS。
MICRO 全称 IEEE/ACM International Symposium on Microarchitecture,与 ISCA、HPCA、ASPLOS 并称为体系结构「四大顶会」,囊括了当年最先进的体系结构成果,被视作国际前沿体系结构研究的风向标,见证了诸多突破性成果的首次亮相,包括谷歌、英特尔、英伟达等企业在半导体领域的多项技术创新。