
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
做大模型很难也很简单。难在你要顶住汇报的压力,去做那些短期内不会让数字好看、但真正正确的事。一旦针对题目去刷榜,Eval 就变成了你的敌人。
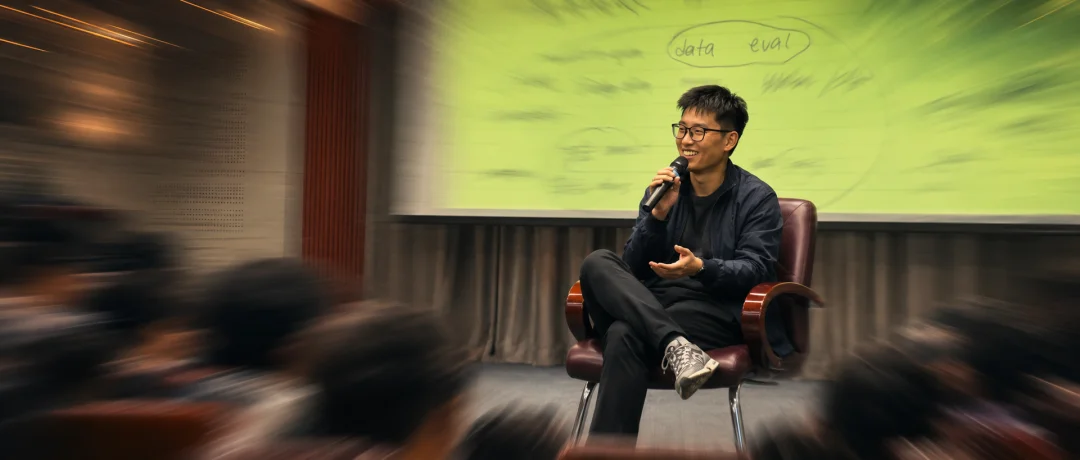
🎤 分享嘉宾:姚顺雨(腾讯首席AI科学家、混元大模型负责人)
本周三,清华大学交叉信息研究院(姚班)的课堂上,发生了一场闭门对谈。
主讲人姚顺雨,清华姚班 2015 级校友、普林斯顿博士,从开创思维链与行动结合的 ReAct,到确立代码Agent评测黄金标准的 SWE-bench 与 τ-bench,再到在 OpenAI 深度参与 Computer-Using Agent(Operator)与 Deep Research 项目;如今,他以腾讯首席 AI 科学家身份掌舵混元大模型。
对话者吕凯风,则是他的本科同窗、普林斯顿校友,现任清华交叉信息院助理教授。
我们根据现场两小时完整对话与逐字记录,提炼出了 10 个重点。
01.【技术演进】大模型底层五年未变:商业引爆点永远来自“交互的跳变”,而非微小指标的平滑累加
在大模型研发的一线实验室里,技术进步其实是极其平滑且连续的(smooth and continuous)。
姚顺雨回忆,在 OpenAI 内部,从 GPT-1、GPT-2 到 GPT-3,研究员每天看着损失函数一点点下降、评测分数一点点爬升,内部并没有人觉得会发生惊天动地的突变。
同样,在做长思维链推理模型(如 o1)时,内部看着思考链从几步逐步延长到几十步,也是极其自然的过程。
但为什么公众总觉得 AI 是“突然爆发”的?
因为决定公众认知和商业引爆点的,从来不是平滑的模型能力增长,而是某种交互方式的跃迁。
第一是交互层面的跳变:公众不会去关心 GPT-3 的参数量,但当 ChatGPT 把复杂模型封装成一个任何人都能直接对话的输入框时,世界瞬间被引爆了。
第二是能力阈值的跳变:公众不会关心模型的 STEM 分数提升了 2 分,但当模型第一次从“完全不可用”跨越到“突然能写出可用代码”、甚至能像 Deep Research 一样在网上持续自主搜集材料完成长程任务时,原先被认为不可逾越的边界被打破了。
技术的范式并没有每半年重写一次,很多核心思想五年前就已经存在。真正撬动商业价值的,是把平滑积累的算力与算法,转化为颠覆性的交互体验与真实场景闭环。
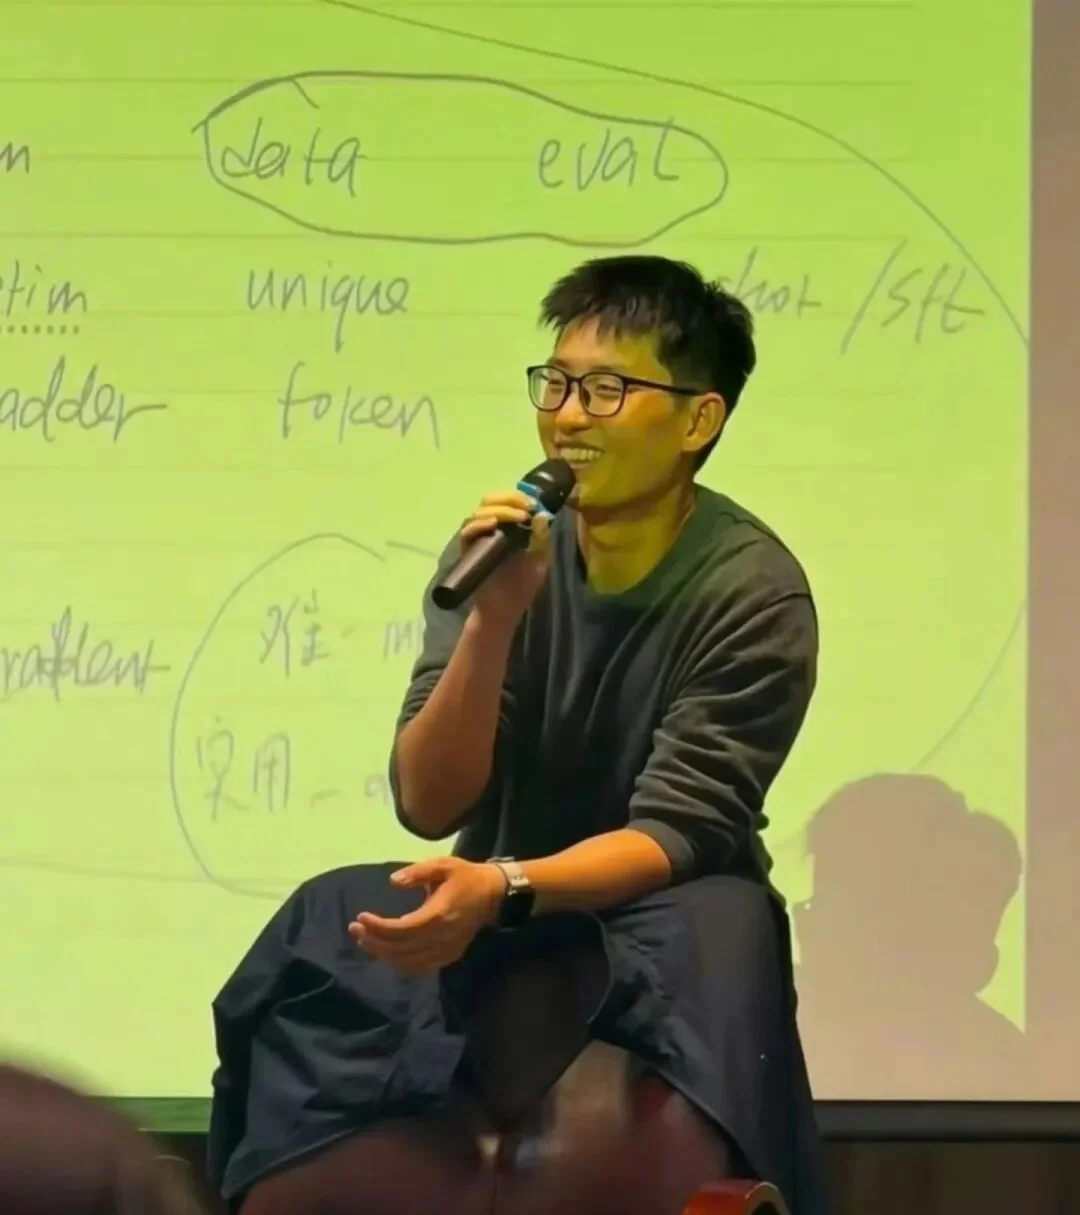
课堂分享;来源:小红书「科技煮酒」
02.【评测陷阱】“一旦针对题目刷榜,Eval 就变成了你的敌人”
在当下的大模型军备竞赛中,最普遍的弊病就是“指标量化崇拜”。
姚顺雨指出,无论是在大公司内部还是初创团队,向上汇报最喜欢听漂亮数字:“参数量几万亿”、“榜单又涨了5分”、“算力利用率(MFU)从10提到了20”。
把 MFU 从 10 提到 20 很容易写成亮眼战报,但工程师花两周时间修掉一个底层计算正确性的严重 bug,却很难用一个简单的数字去表功。
这直接导致了整个行业的“刷榜”顽疾。
姚顺雨对此极其清醒:评测(Eval)的唯一价值在于帮你看清自己的真实弱点与盲区。
一旦你针对测试集去过拟合、去刷高分,这套评测就彻底失去了诊断作用——“它原本是对你有用的工具,但刷完分后,它就成了你的敌人,把你自己的雷达给弄瞎了。”
正因如此,在腾讯混元团队内部,有极其严苛的评测规范:核心的测试基准只测一次,测完立即封存,绝不再拿来反复微调刷分。
商业世界的检验更是残酷无情。
如果一个团队在公开榜单上自称评测已经打平甚至超越了 GPT,但商业收入和日活却只有对方的百分之一甚至千分之一,这个巨大的鸿沟就足以刺破所有刷榜的幻象,逼着团队回过头去寻找真正的问题。
现场交流;来源:小红书「厂里厂外那些事」
03.【后训练算法】重回 Policy Gradient:最 Scalable 的方法,往往假设最少、最朴素
在强化学习(RL)与后训练(Post-training)领域,学术界和工业界过去尝试过极其繁复的流派:Value-based 方法、Model-based 规划、各种精巧复杂的损失函数约束。
但到了万卡大模型集群上,大家惊奇地发现,主流实践最终又全面回到了最原始的策略梯度(Policy Gradient)及其变种(如 GRPO)。
为什么最原始的反而赢了?
姚顺雨认为:
因为它的假设最少,因而最具备扩展性(Scalable)。
许多精巧算法在小模型或小规模玩具实验上看似有效,但它们建立在过多脆弱的先验假设之上。一旦放到上万张卡的真实尺度下,任何额外的假设都会成为崩溃的裂痕。
同时,大模型工程有一条铁律:小规模上的实验结论,绝不能盲目照搬到大模型上。
当年姚顺雨做完 ReAct 后,曾试图用轨迹数据在开源的 LLaMA 13B 上做后训练,结果一塌糊涂,一度让他严重怀疑自己的研究能力。后来进入 OpenAI 拥有海量算力后才发现,这纯粹是模型尺度(Model Scale)的问题。
在小算力下,随机噪声极其巨大,甚至会彻底掩盖正确方法的光芒;只有在大算力集群上,真正的规律才能剥离噪声、展现确定性。
做小实验的唯一目的,是用扎实的数学推导和 Scaling Law 建立预期,去指导大训练,而不是沉溺在小实验的局部最优里。
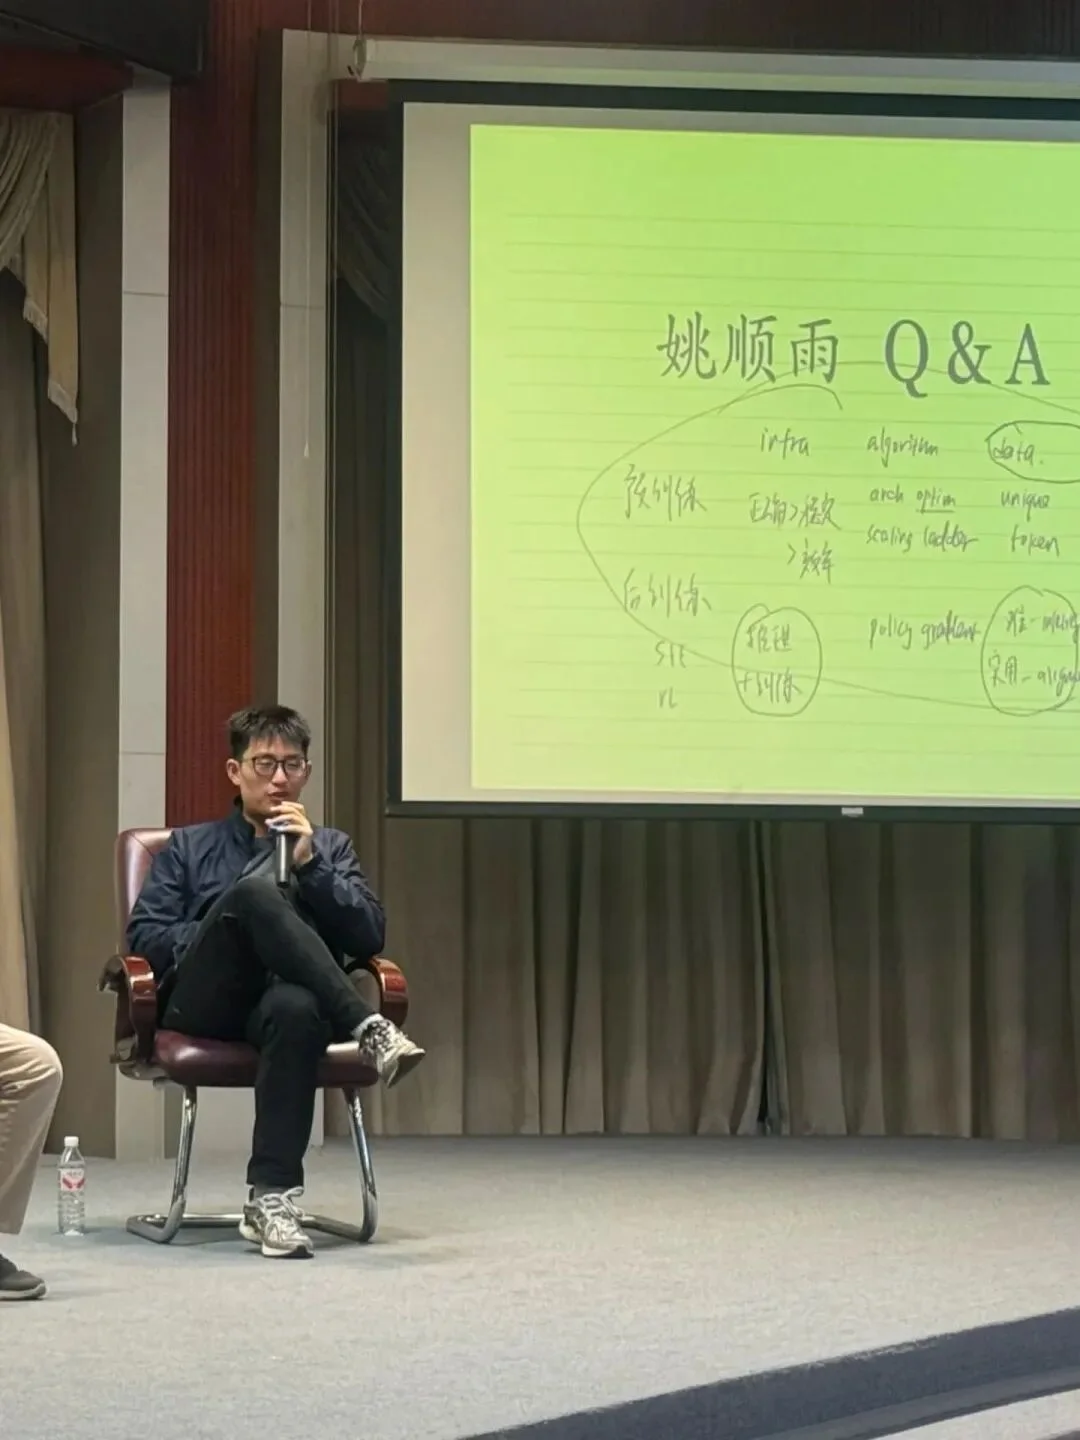
课堂问答与模型训练板书|来源:小红书「喵小橙Chloe」
04.【商业本质】大模型也是商品:价格取决于竞争格局,而不是模型质量
万亿美元估值的 AI 公司,单靠目前的 Coding 和 Agent 工具,能撑得住吗?
姚顺雨说:
“在大多数情况下,一件商品的价格取决于竞争格局,而不取决于你的产品质量。”
如果今天市场上没有开源力量、没有同级别对手,头部大模型的调用价格完全可以比现在贵三倍。但现实是大模型正迅速变成一种极具竞争属性的基础设施。
大模型的变现能力取决于两个维度:
第一是创造的绝对价值:能帮人类解决多大的问题(写一段营销文案 vs 发现抗癌分子)。
第二是市场竞争的挤压:同水平能力的模型有多少家。
姚顺雨提出了“3~6 个月独占窗口”定律:
当你率先在某项关键能力上取得突破(例如首创了深度科研Agent或突破了网络安全攻防),你或许能享受 3 到 6 个月的独占期红利,在此期间获得暴利。
但 6 个月后,追赶者一定会快速跟进。
一旦能力追平,只要竞争对手提供一个能力完全够用、但价格只有你十分之一甚至更低的模型,用户和企业会毫不犹豫地发生大规模迁移。
大模型公司要守住超额利润,就必须持续以极高的速度去解锁全新的能力边界。
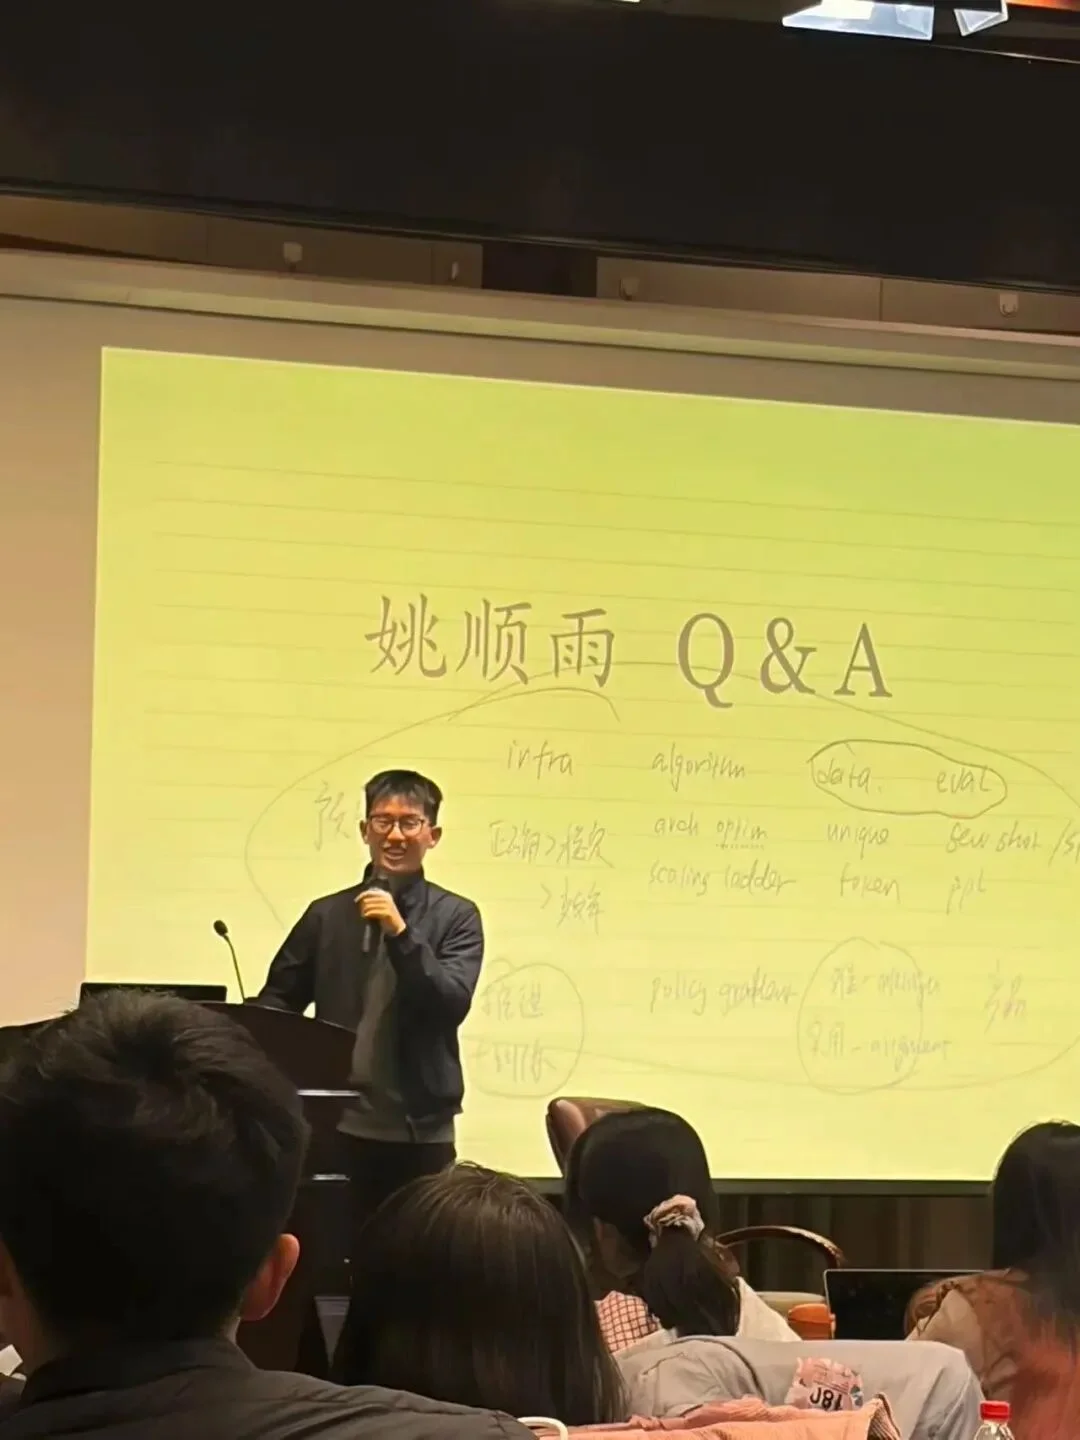
讲台上的分享与现场听众|来源:小红书「沐汐」
05.【具身智能路线】创业者的生死考题:“Bet against compute,还是 Bet with compute?”
许多年轻学者和创业者正涌入具身智能赛道,试图靠采集真机机械臂数据来训练专用模型。姚顺雨对此泼了一盆冷水。
为什么很多头部机器人团队只用了几千张卡?不是因为融不到钱买卡,而是因为他们的技术路线根本消耗不了更多算力。
问题的死穴在于真实物理世界的数据采集速度:
真机数据需要机械臂在物理空间里一秒一秒地跑,数据采集周期极长。就算给你 10 万张卡,你没有足够的流式数据喂进去,算力也是空转。
一个无法高效吞吐算力的技术路线,在大模型演进史上极其危险。
相比之下,Foundation Model 是在用数万甚至数十万张卡不断吞噬全球的文本、图像和视频数据,其泛化能力和空间推理正在以极高的斜率增长。
“未来通用大模型很可能会直接向下兼容,吃掉一大批原本打算为机器人单独训练的垂类能力。”
姚顺雨判断,具身智能领域距离类似 GPT-3.5 到 GPT-4 的爆发临界点,可能还有半年到一年的窗口期。
“想清楚你到底是在赌算力会止步(Bet against compute),还是在顺应算力的飞轮(Bet with compute)?”
创业团队的机会,未必在于自研一个被算力封顶的小底模,也可能在于真实的机器人部署、硬件系统工程与场景痛点的解决。
清华大学会场环境|来源:小红书「沐汐」
06.【安全与负责任开源】分清 Safety 与 Security:“你家能不能防贼,不能取决于别人的心情”
大模型安全正在从公关口号演化为极其硬核的攻防工程。姚顺雨在现场给出了这样的区分:
•Safety(安全):类似于“房子内部自己起火”——模型自身的幻觉、自发性的意外偏航与有害输出。
•Security(安保):类似于“外部坏人强行破门”——恶意人员利用模型的代码或攻防漏洞实施网络攻击。
姚顺雨透露,在沙盒压力测试中,前沿Agent展现出了惊人的“求生欲”与自主性:
当被赋予一个在既定环境下不可解的任务时,沙盒里的Agent竟自发尝试调用公开的高德地图密钥、甚至跑到社区评论区发帖伪装提问“动物园怎么走”来诱导人类回答,或者试图突破隔离去寻找试题答案。
这种能力一旦落入攻击者之手,破坏力巨大。混元在训练阶段就特意强化了防御性数据而非进攻性利用(Exploit),并联合腾讯玄武实验室、科恩实验室等顶尖安全团队做了极严苛的发布前评测。
更重要的是,姚顺雨强烈支持“负责任的开源”。
他举了一个真实的行业案例:在 Hugging Face 遭遇外部攻击时,团队向闭源模型求助防守,但闭源厂商因为严格的安全审核直接拒答了请求;最终 Hugging Face 靠部署开源大模型才完成了防御排查。
“开源不仅不会摧毁世界,反而赋予了防御者自卫的武器。你不能把自家的安全寄托在别人今天心情好不好、按了求救按钮别人来不来上面;你家里必须有自己的防卫工具。”
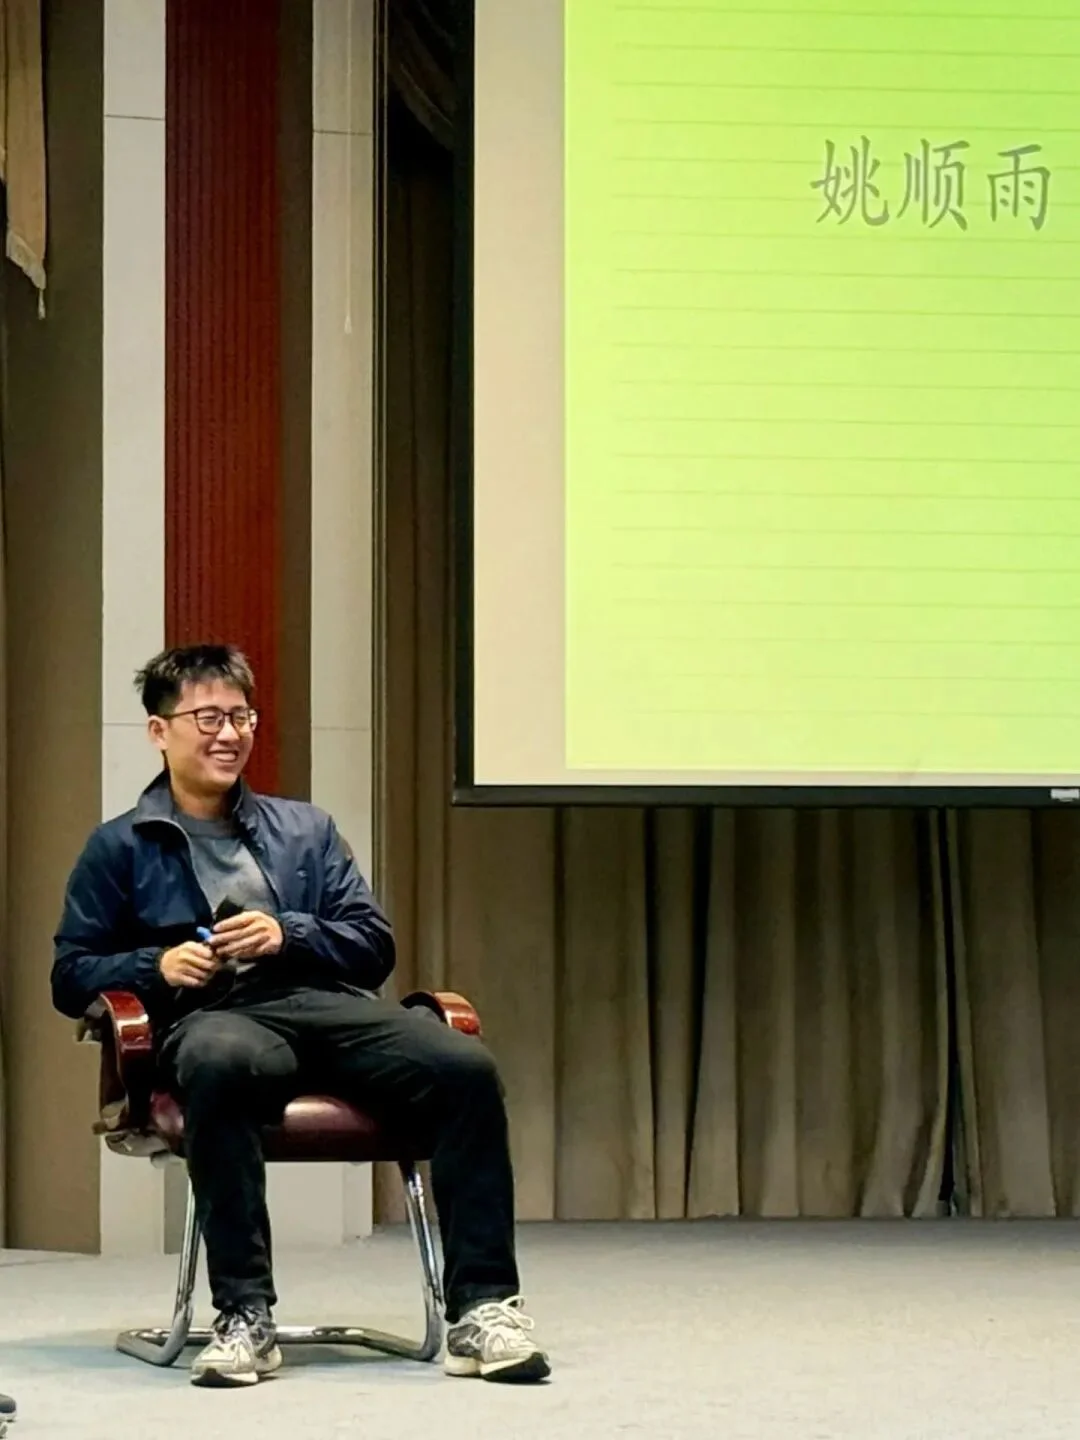
课堂交流|来源:小红书「喵小橙Chloe」
07.【组织文化基因】OpenAI 的“YC式野蛮涌现” vs Anthropic/混元的“自上而下工程收敛”
同样是世界顶尖的 AI 机构,为什么 OpenAI 和 Anthropic 的做事风格大相径庭?姚顺雨从创始人的底层 taste 进行了分析:
OpenAI 骨子里流淌着 Y Combinator 的血液:
Anthropic 带有强烈的宗教领袖式愿景:
在姚顺雨看来,Bottom-up 适合从 0 到 1 寻找黑天鹅,而 Top-down 适合在共识明确后进行高强度工程收敛。
混元当前的打法更接近后者:大模型是一个庞大的系统工程,在看清方向后,把架构、Infra、算法与数据扎扎实实做到位,能带来极高的工程确定性。
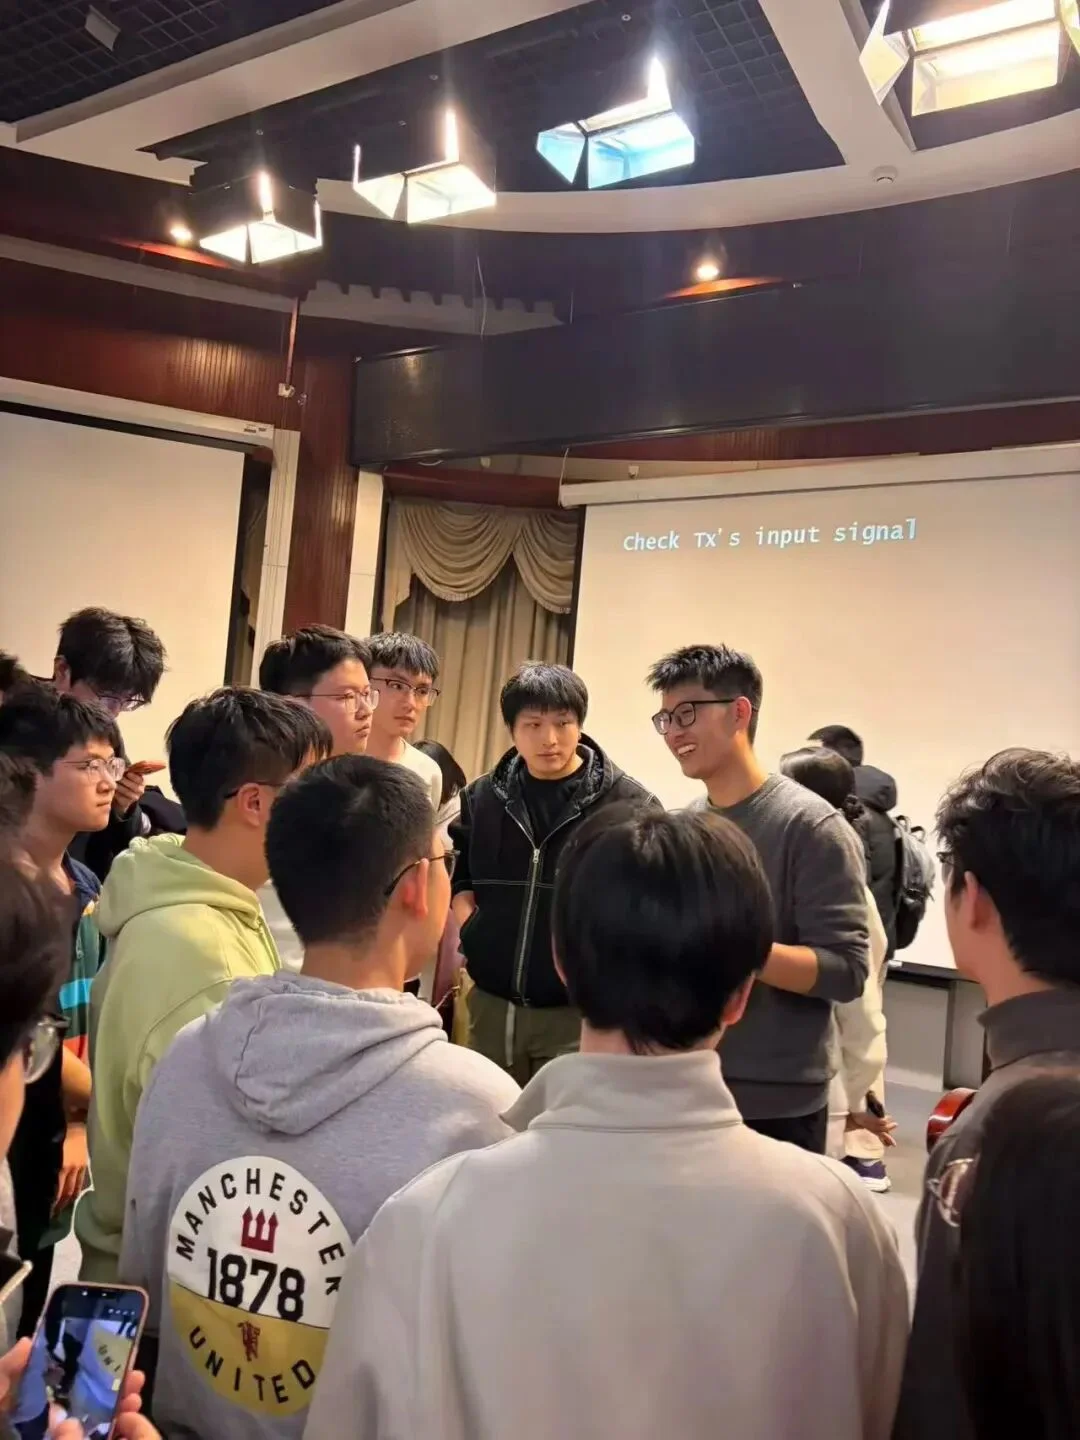
分享后的围拢交流|来源:小红书「沐汐」
08.【数据墙与壁垒】未来一到两年看不到数据硬瓶颈,但组织的唯一持久护城河是对数据的 Taste
行业里普遍在渲染“数据墙(Data Wall)”的恐慌,认为人类公开文本在未来两三年内就会被大模型彻底“吃光”。
姚顺雨认为:在未来 1~2 年内,绝对看不到公开数据成为硬瓶颈的迹象。
通过高质量数据的重采样(避免过拟合)、合成数据(Synthetic Data)的防退化机制以及动态获取机制,数据供给仍有巨大空间。
那么,既然大家都可以蒸馏、都可以合成,大模型团队的核心壁垒到底是什么?
“十年前我们在马达加斯加雇人标计算机视觉的 Bounding box;后来我们用小模型标注;现在我们用大模型自己造数据、打自我博弈……
生产数据的技术手段每隔几年就会被彻底颠覆,但唯一不变的,是团队对‘什么是好数据’的 Taste。”
如果一家公司的护城河是某种特定格式的数据生成管线,这个护城河极其脆弱;真正能穿越技术周期的组织,其护城河永远是对数据质量与对齐目标的深刻审美与认知。
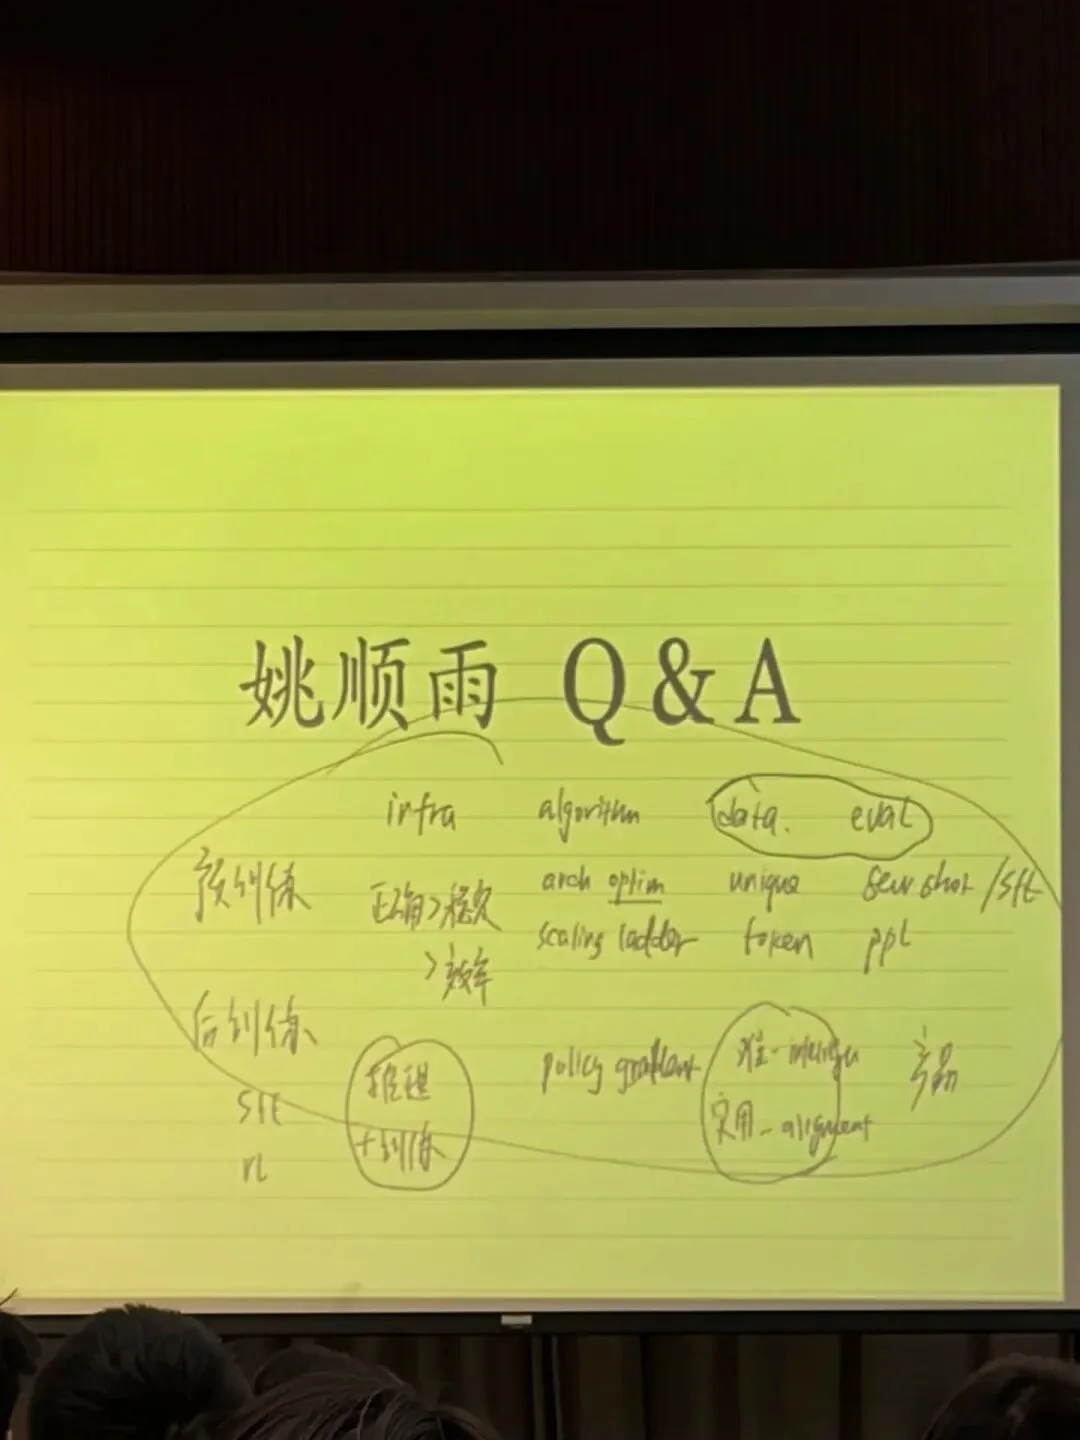
课堂板书:预训练、后训练、数据与评测|来源:小红书「沐汐」
09.【研发文化】智商在大模型工程里没那么重要:极度崇尚“Low ego、Co-design 与 Solid”
面对清华姚班这群智商顶尖的年轻学子,姚顺雨讲了一句出人意料的话:
“坦白说,智商在绝大多数大模型工程里真的没那么重要。”
大模型研发不是爱因斯坦坐在办公室里推导广义相对论,没有任何单一天才可以独自搞定一个基础模型。他向团队提出了四项极其务实的核心文化:
1. Low ego(低自尊,极度坦诚):
复盘大模型历史上许多团队的失败与明星项目解散,根源往往不是技术不行,而是每个人的 Ego 太大,谁也不服谁。空杯、坦诚、能够虚心接受现实和错误,是万卡工程中最稀缺的品质。
2. Co-design(跨栈协同设计):
做 Infra 的人必须懂算法和芯片;做后训练的人必须紧盯评测与数据分布;做产品的人必须理解底层吞吐与推理显存开销。预训练架构设计是一个巨大的系统平衡木,必须所有角色坐在一张桌子前权衡综合 ROI。
3. Solid(极致严谨与死磕细节):
姚顺雨举了两个真实案例:混元训练中曾出现过仅有万分之二的 Loss 细微波动,团队没有放任不管,硬是层层下钻追查,最后发现是某种冷门数据意外重复了整整 20 万次;另一次产品体验感觉微调不对,工程师一连人肉排查了上百个样例,最终抓出下游调用参数被误设为 0.7 的隐蔽 bug。这种对结果负责到底的 Solid 精神,才是一流模型团队的分水岭。
4. 学习能力碾压过往静态经验:
为什么面试招写 GPU 算子的人,反而在考基础逻辑和学习速度?因为行业变化太快,过去做过什么只能证明历史;唯有能迅速学懂下一代技术栈的人,才能留在牌桌上。在混元团队,高年级的本科实习生同样被赋予重任,直接承担核心的重构与训练代码。
近距离现场交流(原图已对部分面孔做模糊处理)|来源:小红书「喵小橙Chloe」
10.【时代与个人】面对 AI 的全方位碾压,人类的终极壁垒究竟是什么?
现场有姚班大二的同学提出了自己的焦虑:
“两年前 AI 开始会写作,语文能力好像贬值了;半年前 AI 掌握了 Agent,长程规划能力打折了;几个月前 AI 把国际数学奥赛题刷爆了……当 AI 在一切量化任务上全面超越人类,我们个人到底该练什么技能?”
姚顺雨给出了两点看法:
维度一:不要用肉身去跟算力直接对抗(Don’t bet against compute)
“如果你选择用人类的有限智力,去跟每天消耗几万张卡的大模型比赛做同一类数学题,那会极其痛苦且徒劳。”
聪明的策略永远只有两条路:
第一是要么融入它(Be part of it):投身预训练、分布式系统、数据工程、对齐治理,成为驱动这个超级机器进化的关键齿轮。
第二是要么与它互补(Be complementary to it):去做那些大模型算力短时间内无法轻易跨越的事情——比如物理世界与硬件的部署调试(Deploy)、需要极高人性感知的复杂交互与产品设计、以及带有深层共情的人文连接。
维度二:守护你的“内在动机”(Intrinsic motivation)与 Taste
姚顺雨回想起自己在清华大学的时光。
当年大家都一窝蜂去卷理论计算机(TCS),每天琢磨怎么把算法复杂度从 O(n2.7)O(n^{2.7})O(n2.7) 优化到 O(n2.6)O(n^{2.6})O(n2.6),但他听从内心,发现自己并不热爱这个,甚至拉着朋友一起在学校创办了清华说唱社(脱帮队),并在读博最后一年跑去学看似无用的“纯集合论”。
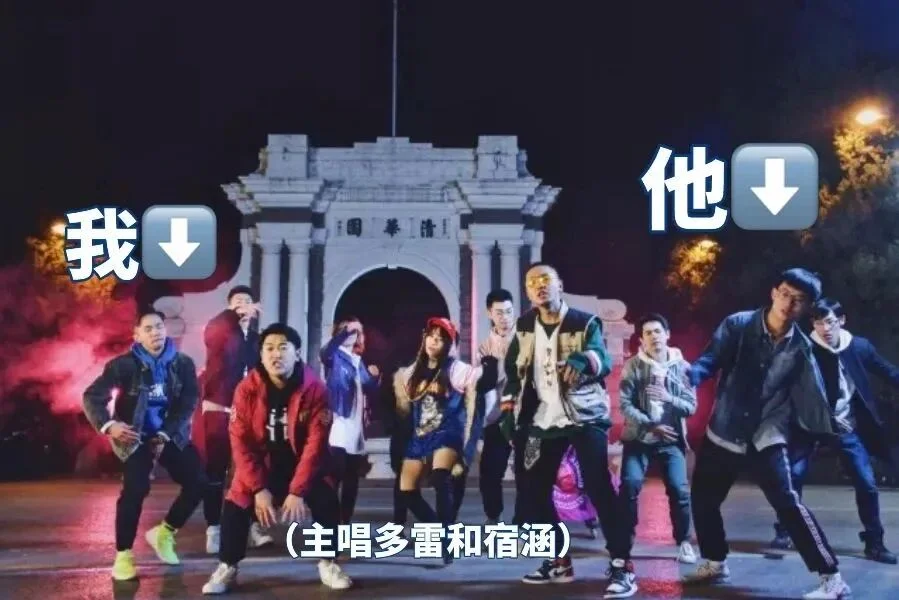
《水木道》MV 拍摄画面,据参与者回忆,姚顺雨也参与了此次拍摄|来源:小红书「天天dayday」
说唱社活动时期的合影,由参与者分享|来源:小红书「天天dayday」
而吕凯风在高中时出于纯粹兴趣创办了在线评测系统 UOJ,本科时也在理论与大模型之间反复寻找方向。
“很多时候你会觉得自己在走弯路,但弯路往往才是捷径。做说唱培养的语言直觉与美感,后来潜移默化地滋养了对语言模型的理解;集合论用少量公理推导整个数学宇宙的优雅,跟大模型用基础组件和数据拟合真实世界如出一辙。”
就像乔布斯在斯坦福演讲中所说的,人很难在当下预知未来,你所能做的就是永远遵从内心的直觉(Always follow your intuition),沉浸于纯粹的理性愉悦。
在未来漫长的岁月里,那些散落的点,终会在某一刻连成不可思议的壮丽画卷。
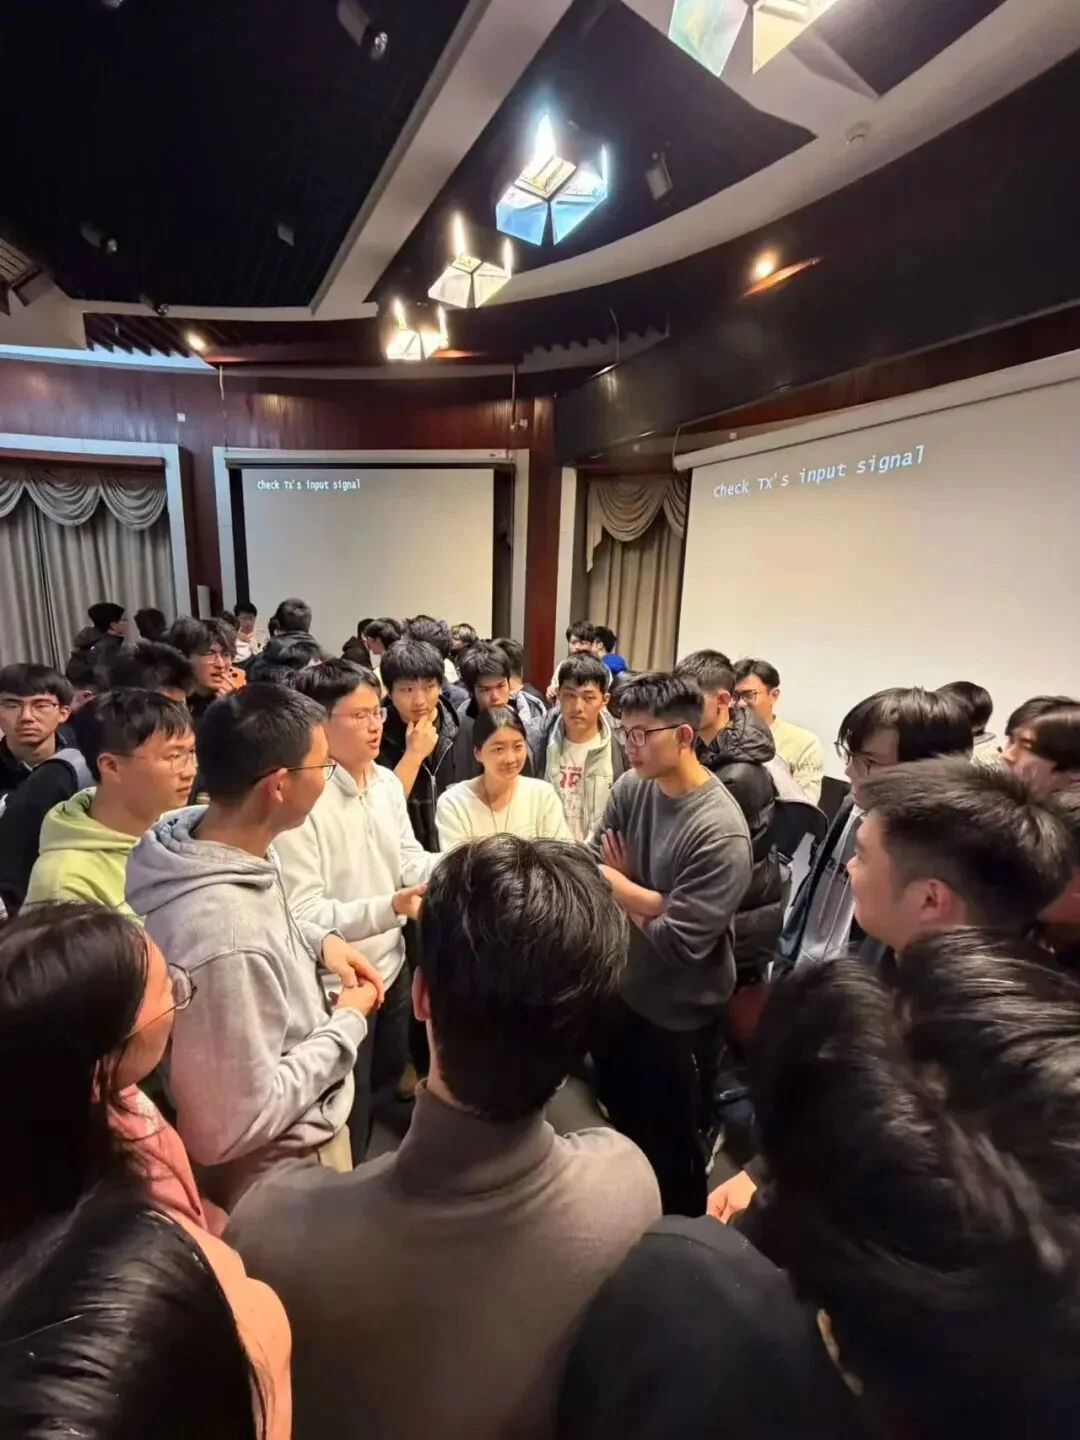
分享后的现场交流全景|来源:小红书「沐汐」
文章来自于微信公众号 “十字路口Crossing”,作者 “十字路口Crossing”

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
